Exploiter les données du recensement 🇨🇦
Dernière mise à jour le
Bienvenue dans ce nouveau projet ! Nous allons explorer l’immense quantité d’informations du recensement canadien fournies par Statistique Canada. Pour traiter ces données, nous utiliserons la librairie Simple Data Analysis (SDA), que j’ai créée (donnez-lui une étoile ⭐ ).
Pour chaque région métropolitaine, nous créerons une carte montrant les aires où le revenu des ménages est inférieur ou supérieur à la médiane. La carte de Montréal ci-dessous montre le résultat que nous obtiendrons ensemble.
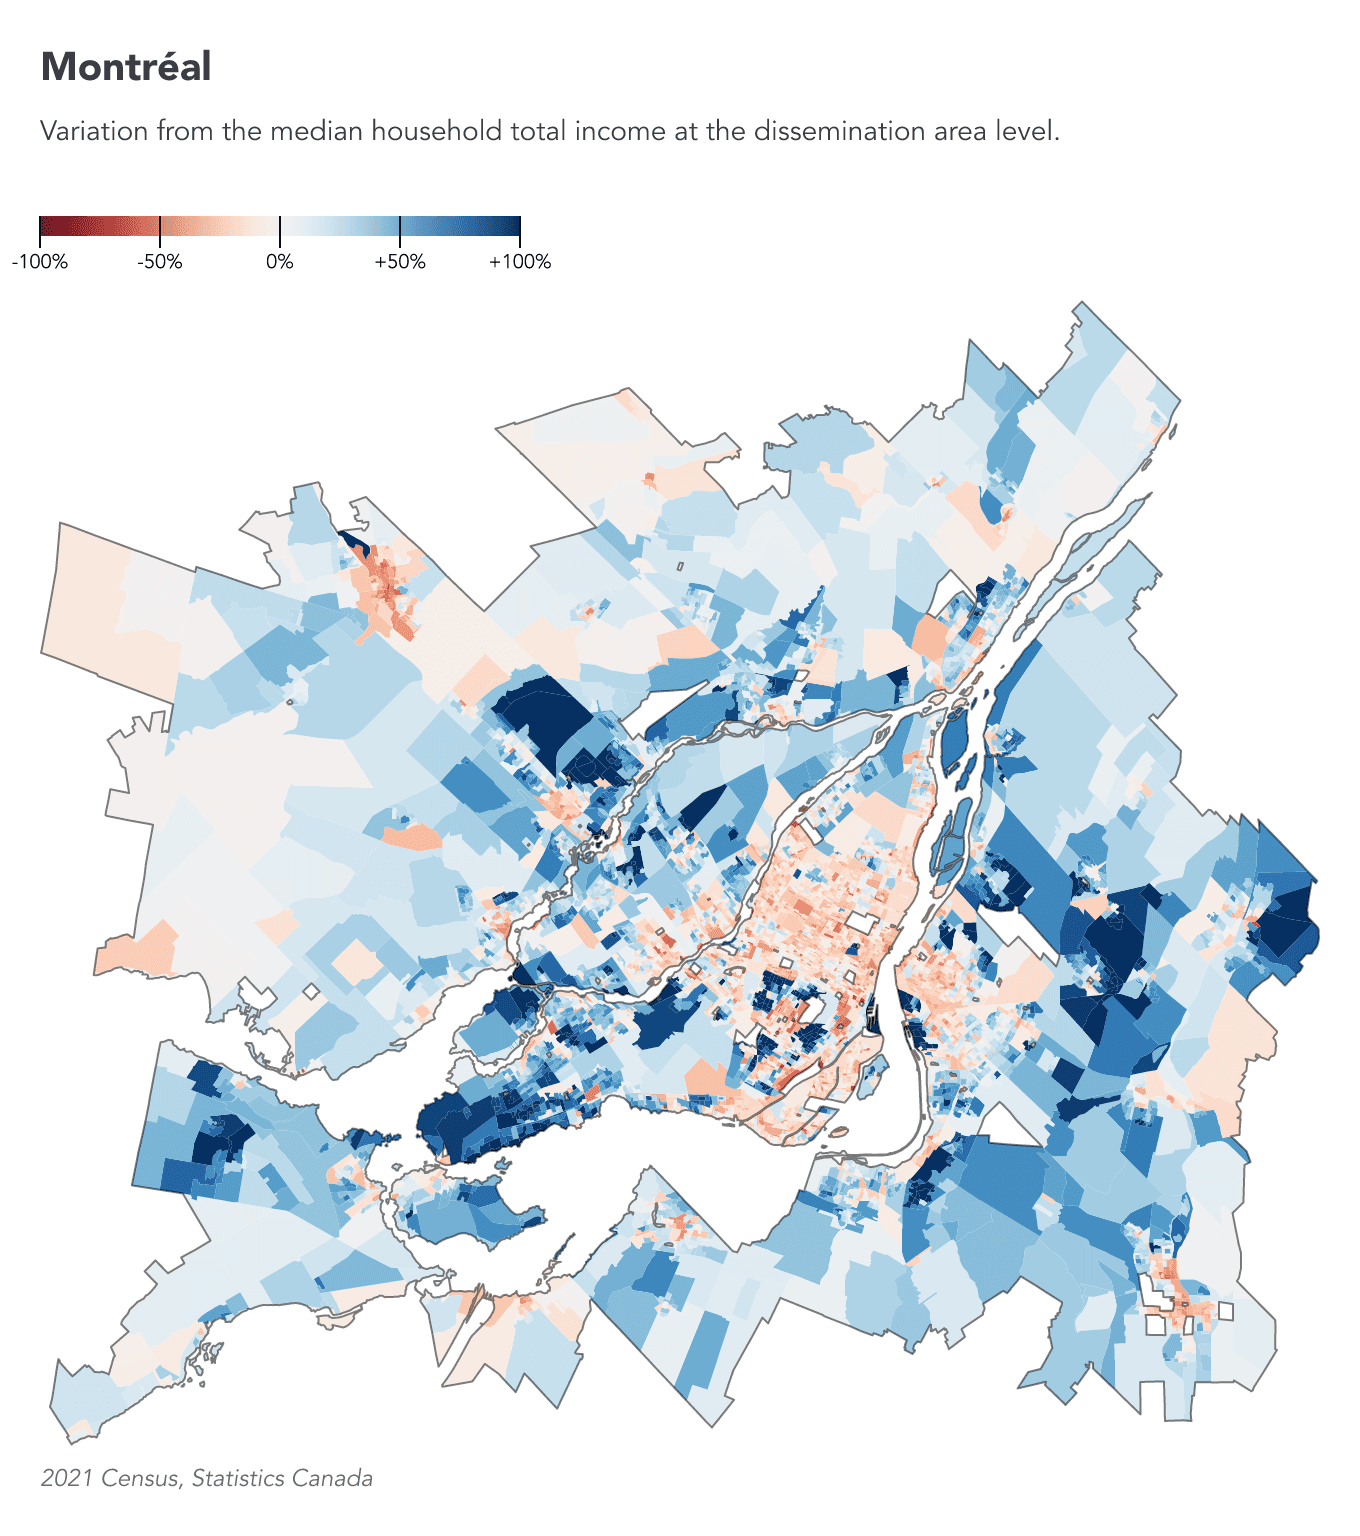
Dans ce projet concret, je vous montrerai des techniques avancées pour traiter de grands ensembles de données avec TypeScript. Les données du recensement de 2021 pèsent environ 30 Go, mais il vous faudra environ 70 Go d’espace libre sur votre disque dur. C’est le moment de faire du ménage ! 🧹
Si vous bloquez à une étape, il peut être utile de revoir les leçons précédentes sur les bases de SDA :
Nous utiliserons Node.js et VS Code. Assurez-vous d’avoir également suivi la leçon Installation.
C’est parti !
Quelle est la question ?
Pour ne pas perdre le fil, définissons la question à laquelle nous voulons répondre :
- Pour chaque région métropolitaine canadienne, quelles aires de diffusion ont un revenu des ménages supérieur ou inférieur à la médiane ?
Voici comment le recensement définit les régions métropolitaines :
Une région métropolitaine de recensement (RMR) est formée d’une ou de plusieurs municipalités adjacentes centrées sur un centre de population (appelé le noyau). Une RMR doit compter au moins 100 000 habitants, dont au moins 50 000 vivent dans le noyau.
Et voici la définition des aires de diffusion :
Une aire de diffusion (AD) est une petite unité géographique relativement stable dont la population moyenne est de 400 à 700 personnes. C’est la plus petite région géographique normalisée pour laquelle toutes les données du recensement sont diffusées. Les AD couvrent tout le territoire canadien.
Passons au code !
Installation
Créez un nouveau dossier vide à un endroit pratique sur votre ordinateur et ouvrez-le dans VS Code. Ouvrez ensuite le terminal dans VS Code.
Nous utiliserons @nshiab/setup-data-project, une librairie que j’ai créée pour installer les librairies et préparer tous les fichiers et réglages nécessaires à un projet. Exécutez cette commande dans le terminal :
npx @nshiab/setup-data-project --sdaSi on vous demande de confirmer l’installation de la librairie, tapez y et appuyez sur Entrée.
L’option --sda sélectionne automatiquement la librairie simple-data-analysis à installer.
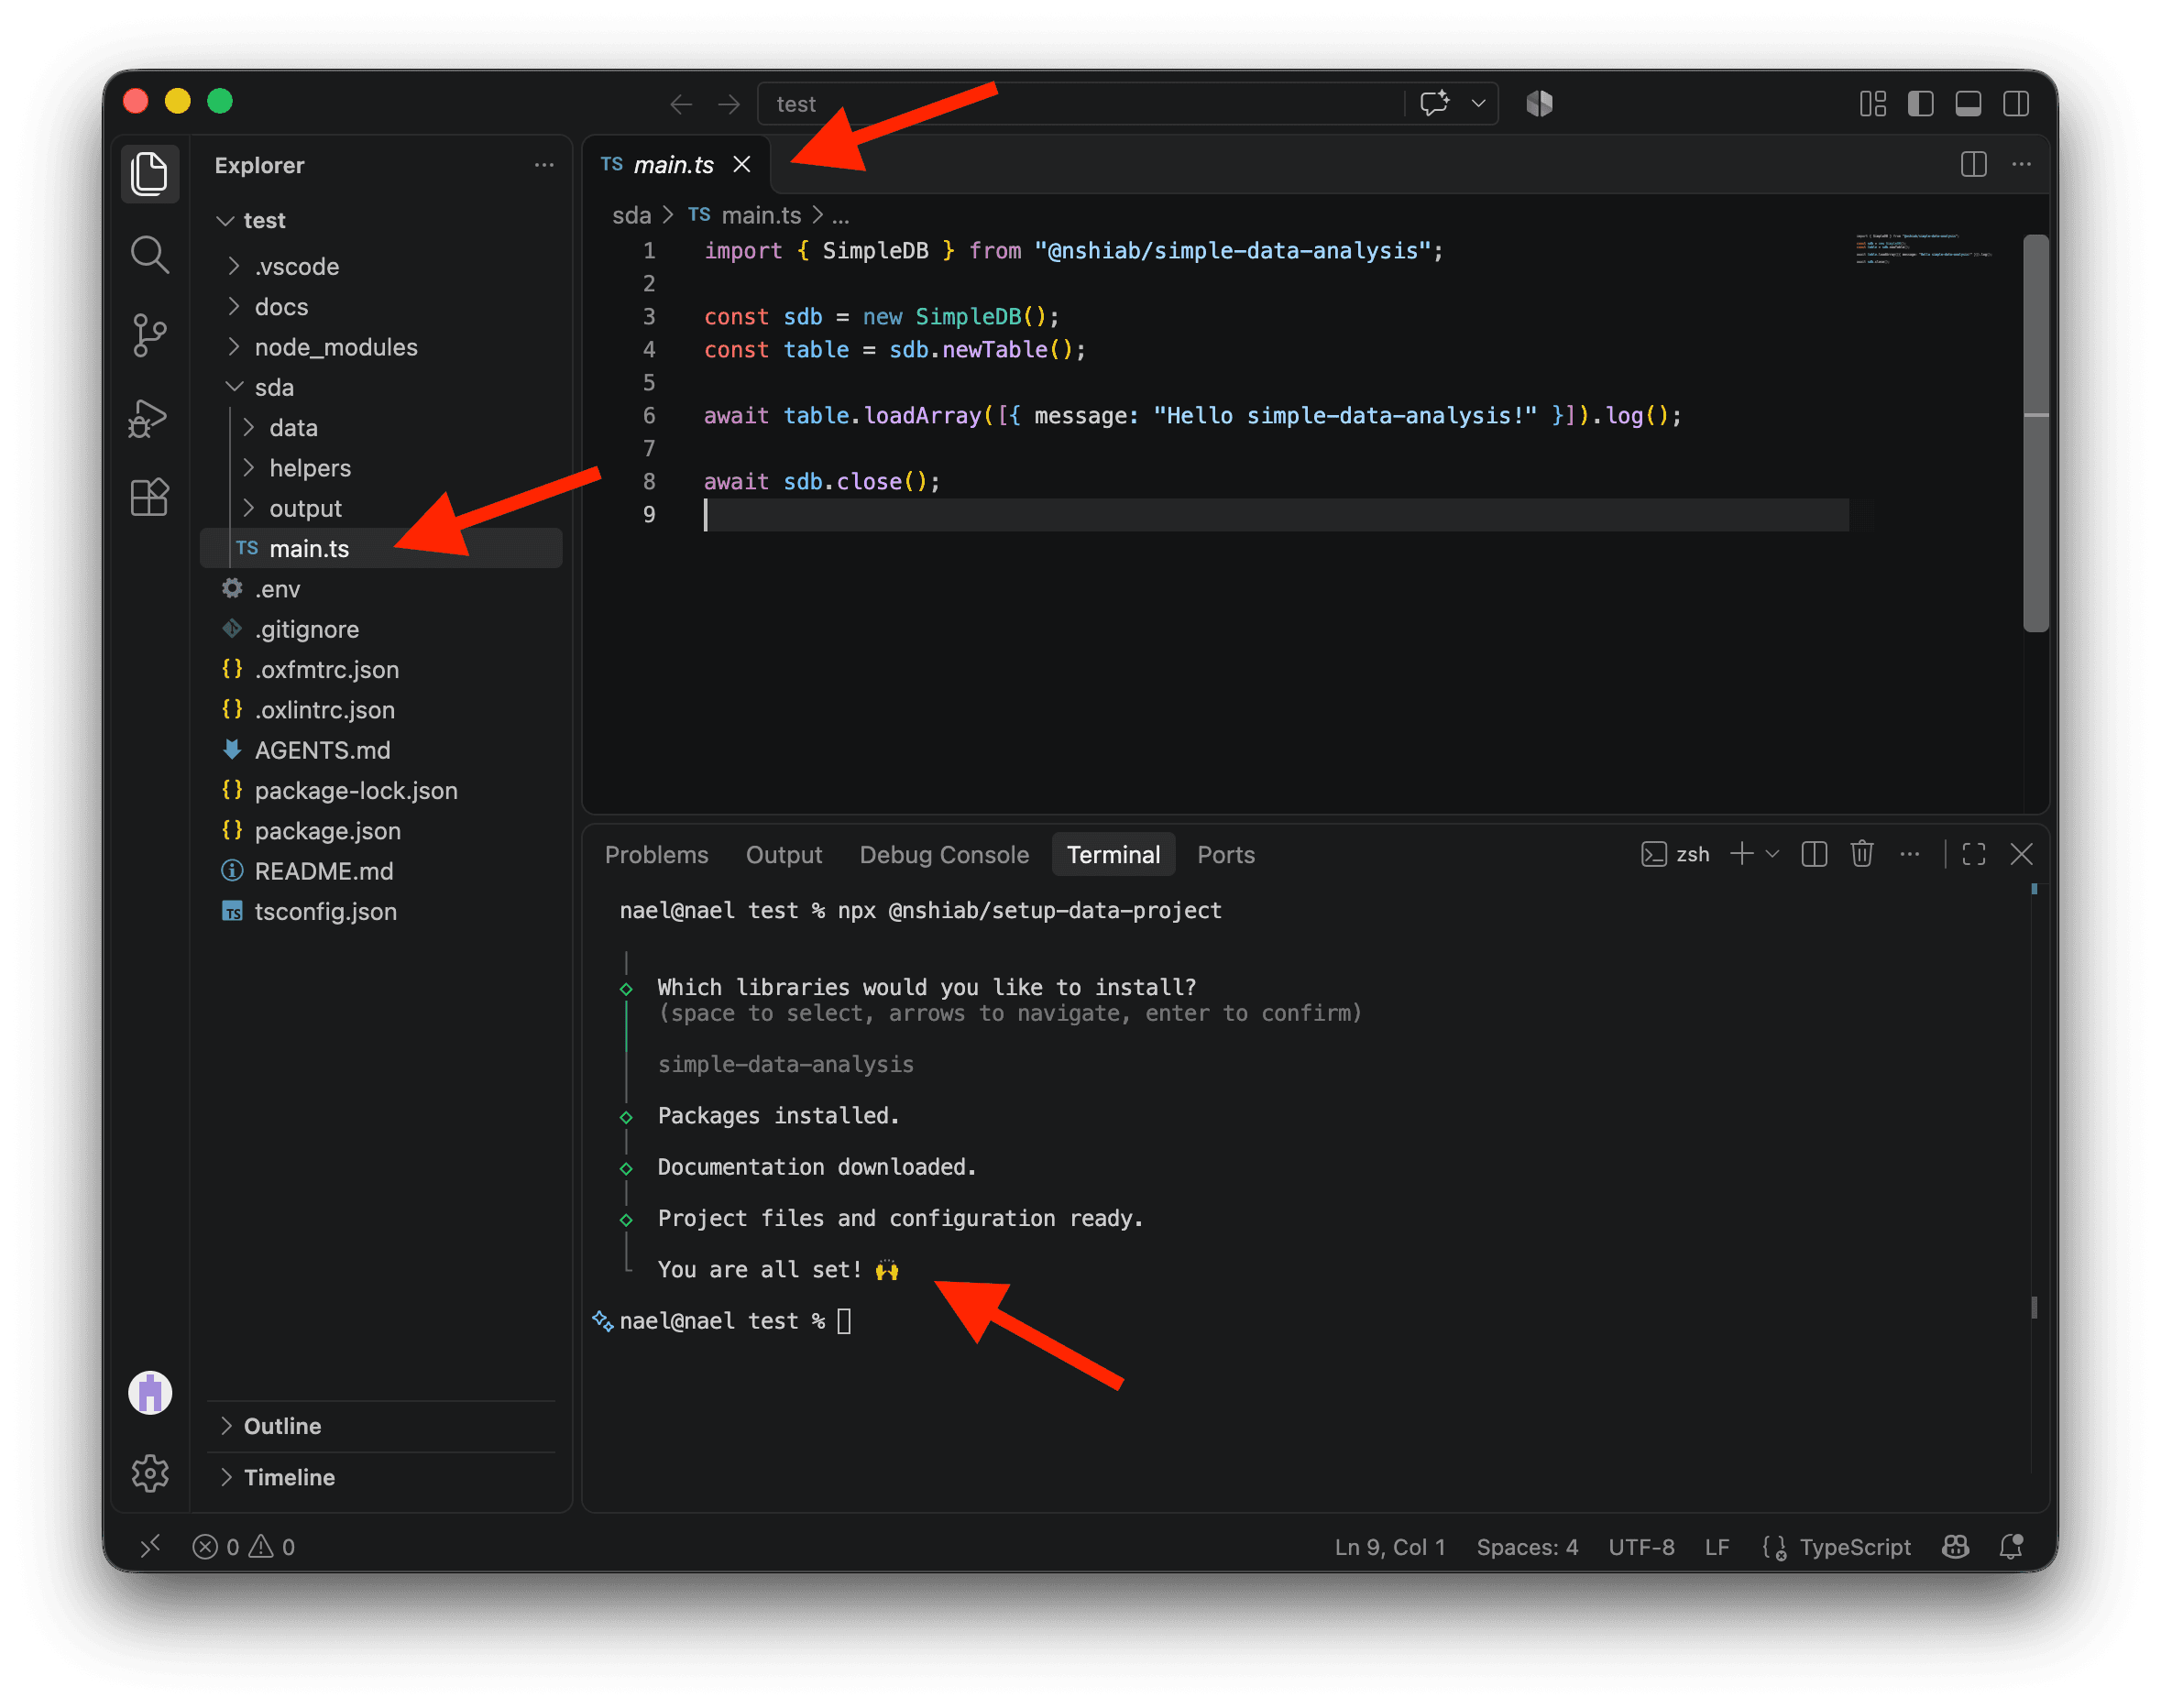
Une fois que le terminal affiche You are all set!, ouvrez sda/main.ts. Vous y trouverez du code de départ.
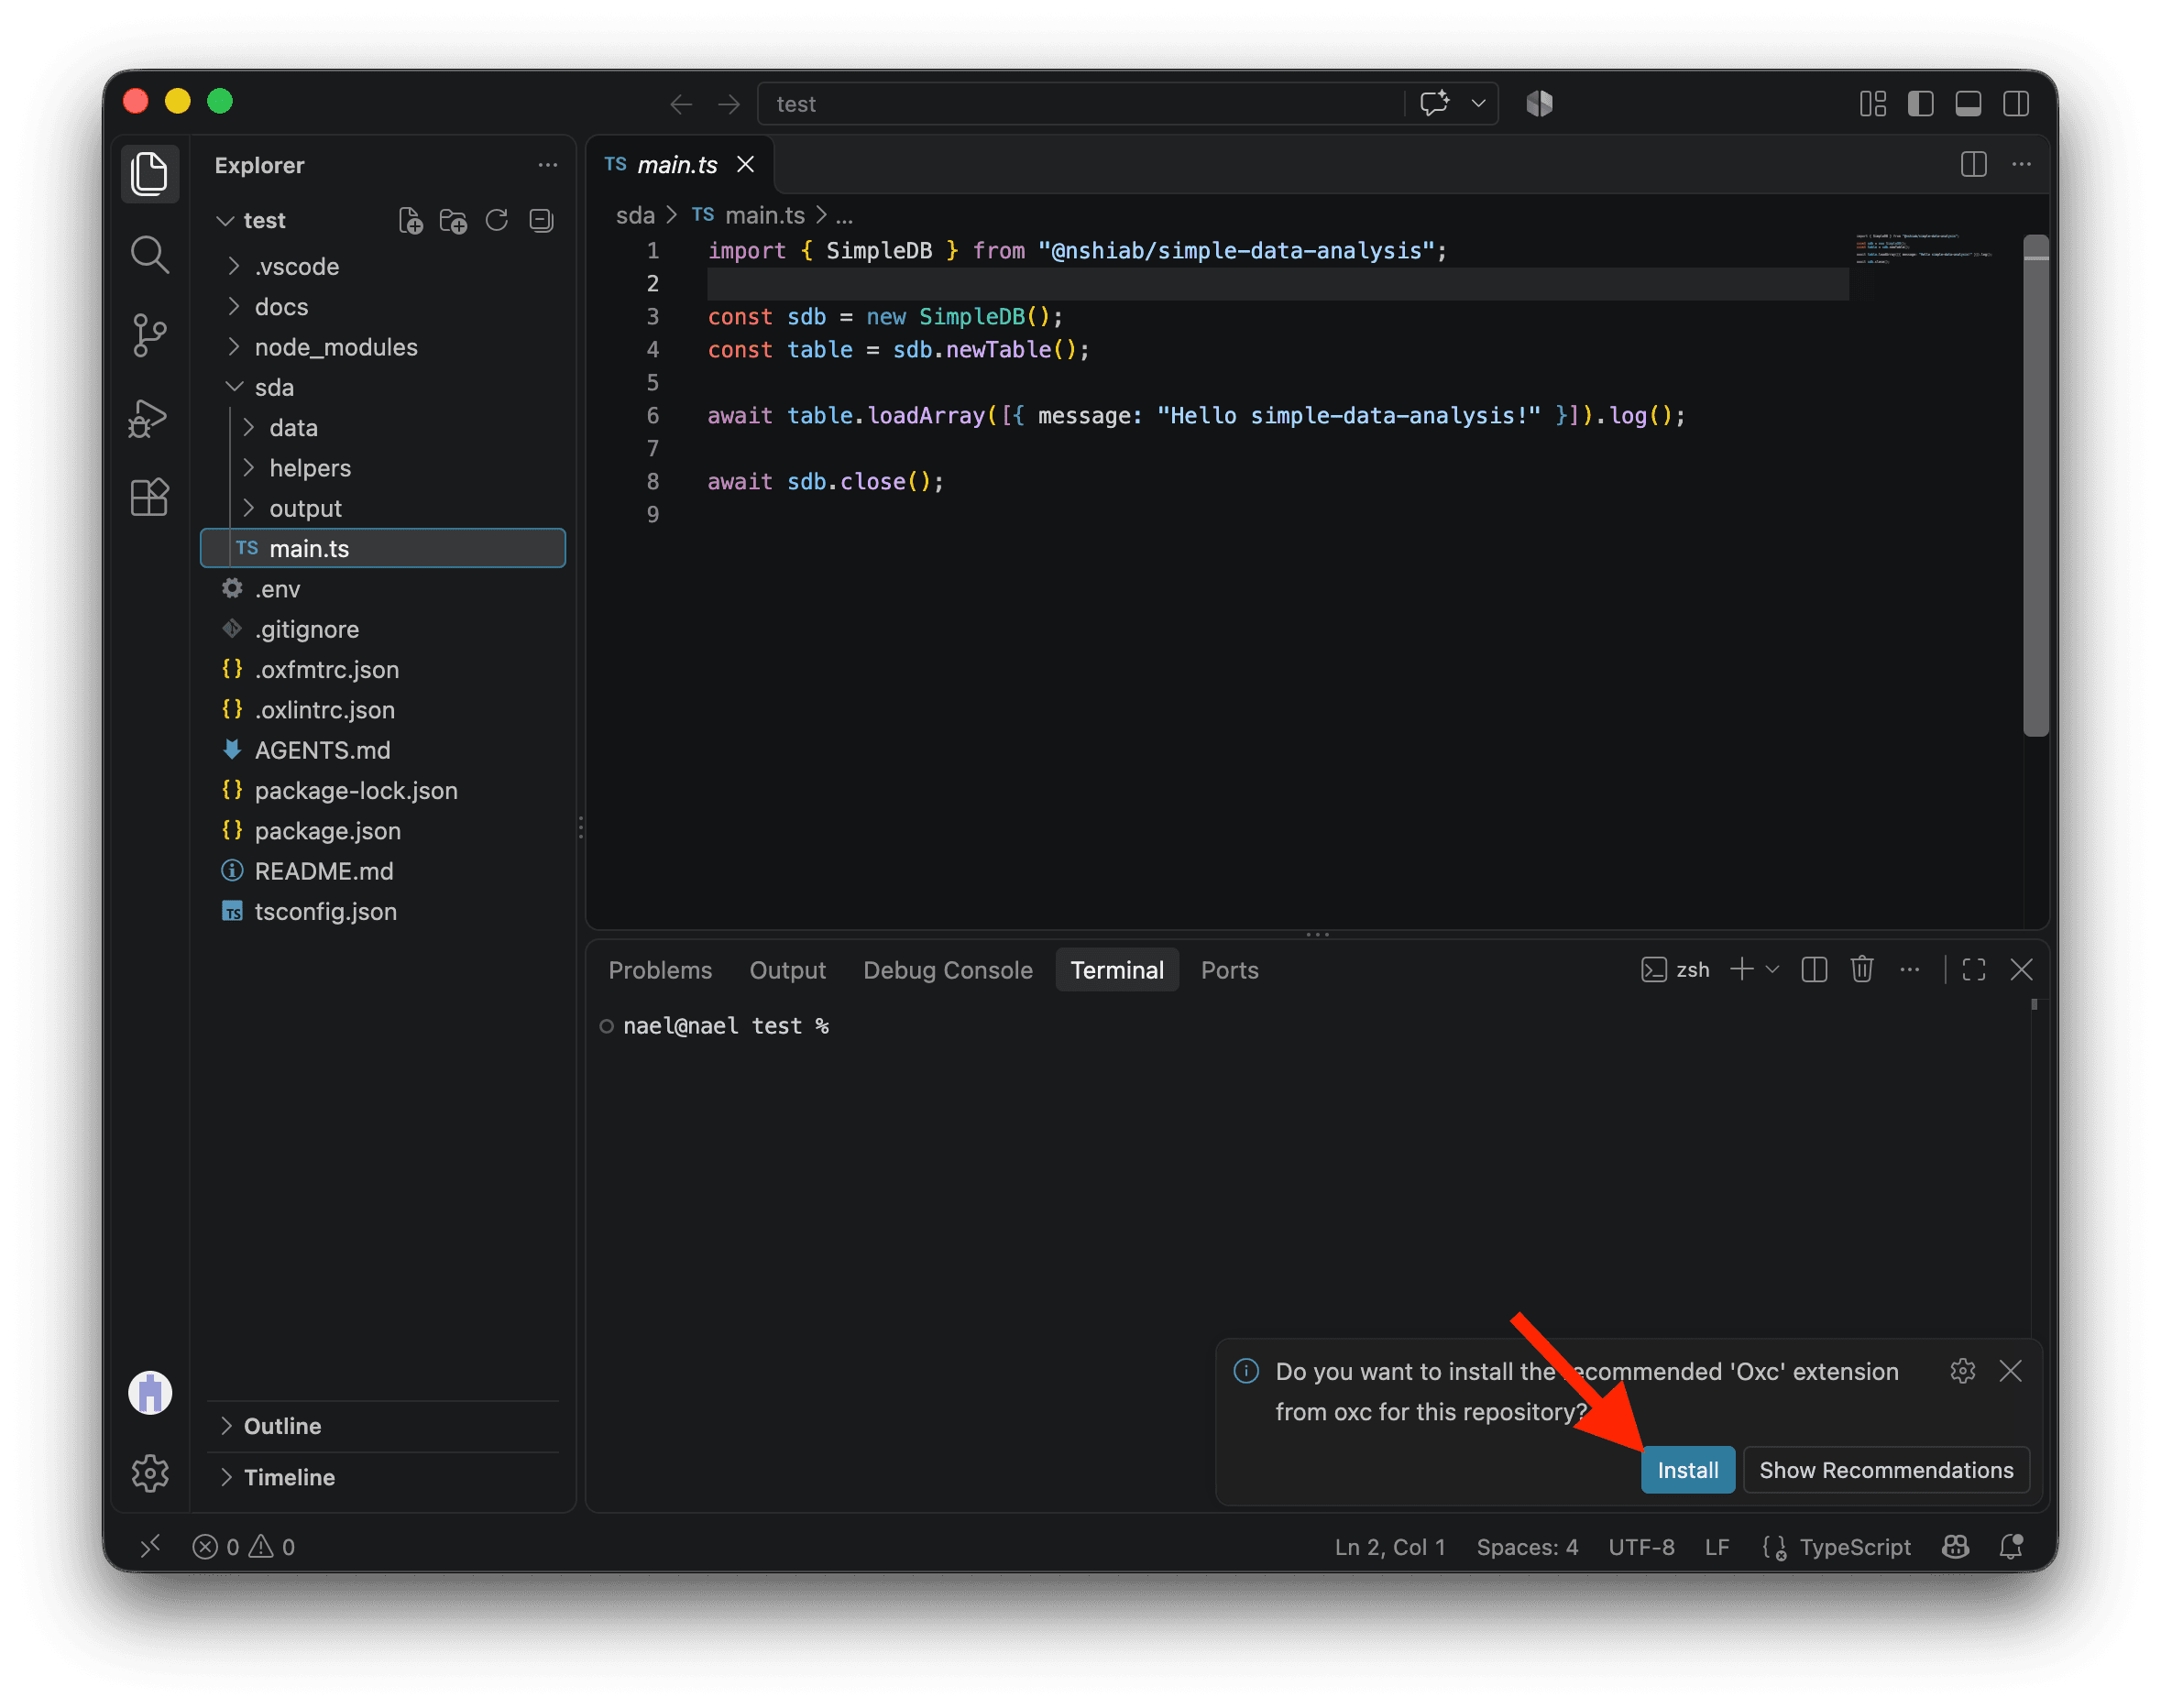
Si VS Code vous propose d’installer l’extension recommandée Oxc, cliquez sur Install. Elle aide à formater votre code et à repérer des problèmes potentiels pendant que vous travaillez.
Nous sommes maintenant prêts à surveiller sda/main.ts. Exécutez la commande ci-dessous. Chaque fois que vous enregistrez le fichier, votre code sera automatiquement formaté, vérifié et exécuté :
npm run sda:watchSi vous devez arrêter la surveillance, cliquez dans le terminal et appuyez sur Ctrl+C sur Mac ou Windows.
Gardez la surveillance active pendant cette leçon.
Téléchargement des données
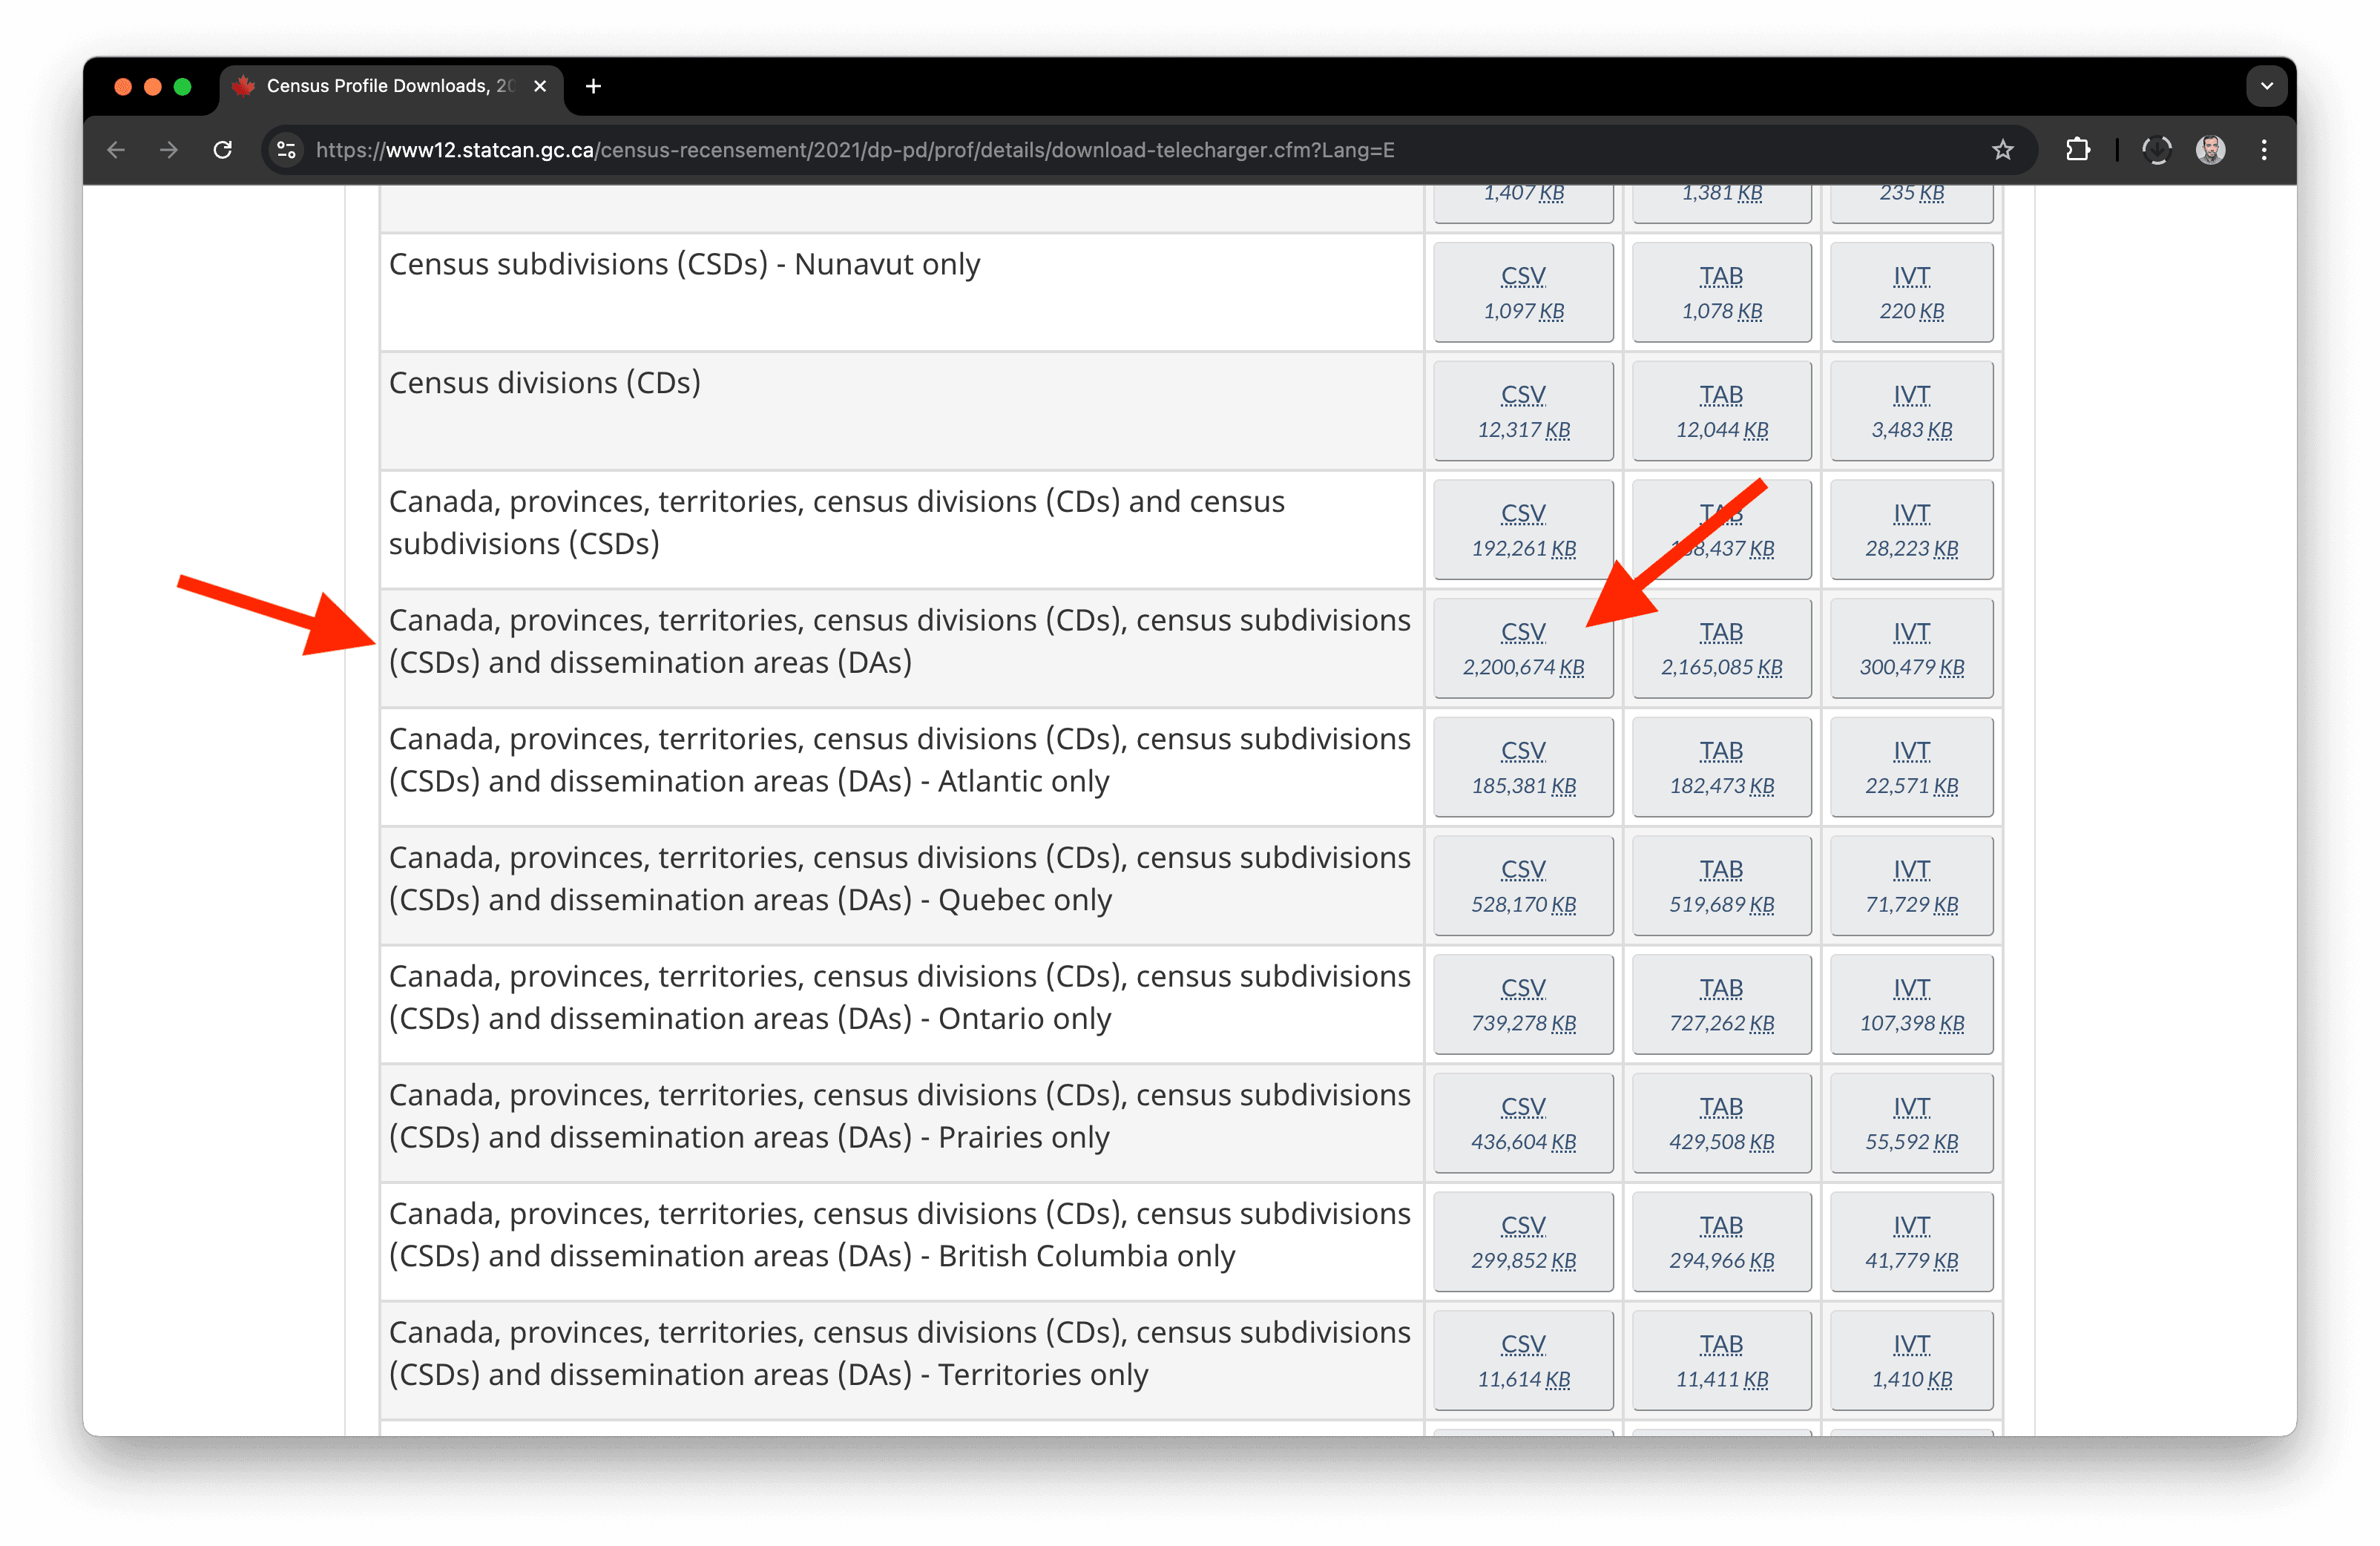
Pour télécharger les données du recensement avec le plus de détails possible, rendez-vous sur cette page de Statistique Canada .
Ouvrez le premier volet Comprehensive download file, puis cliquez sur le bouton CSV de Canada, provinces, territories, census divisions (CDs), census subdivisions (CSDs), and dissemination areas (DAs).
Si vous ne le trouvez pas, voici le lien direct . Vous téléchargerez un fichier ZIP de 2,25 Go.
Puisque nous voulons travailler sur les régions métropolitaines, il nous faut aussi leur nom pour chaque aire de diffusion.
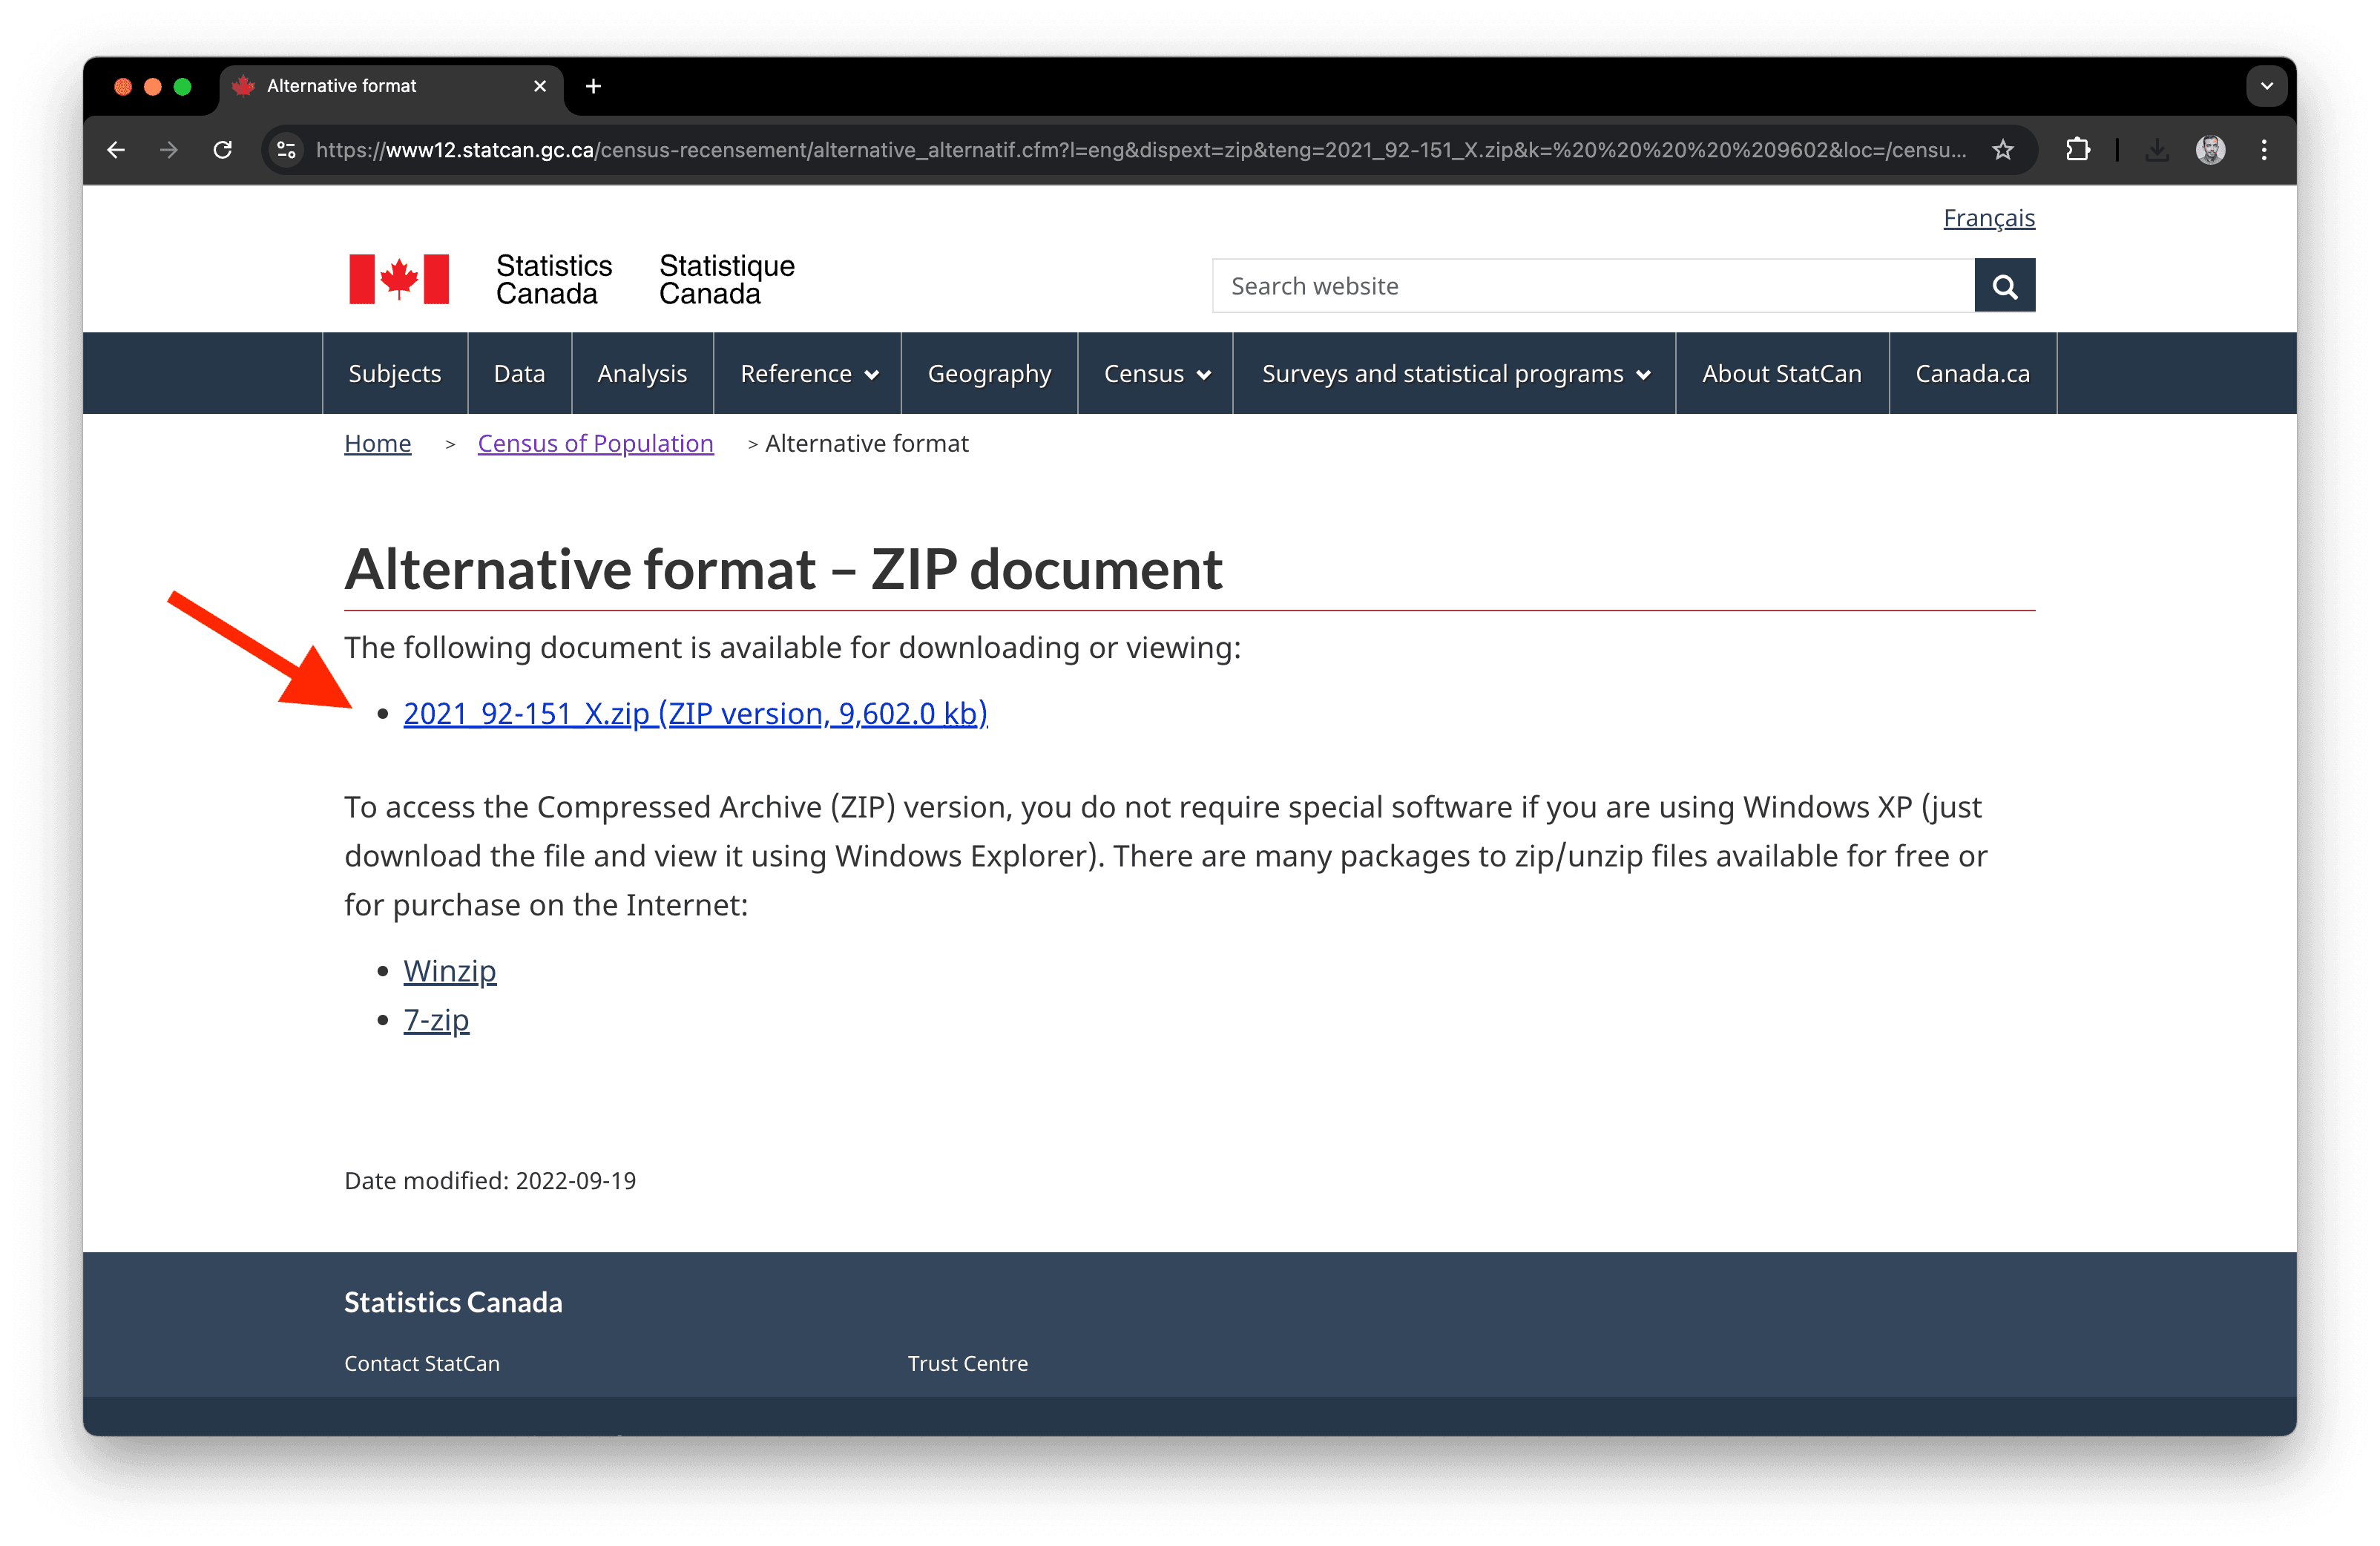
Statistique Canada fournit cette information dans le Fichier des attributs géographiques de 2021 . Téléchargez-le à partir de ce lien direct de Statistique Canada . Il s’agit d’un fichier ZIP de 9,8 Mo nommé 2021_92-151_X.zip.
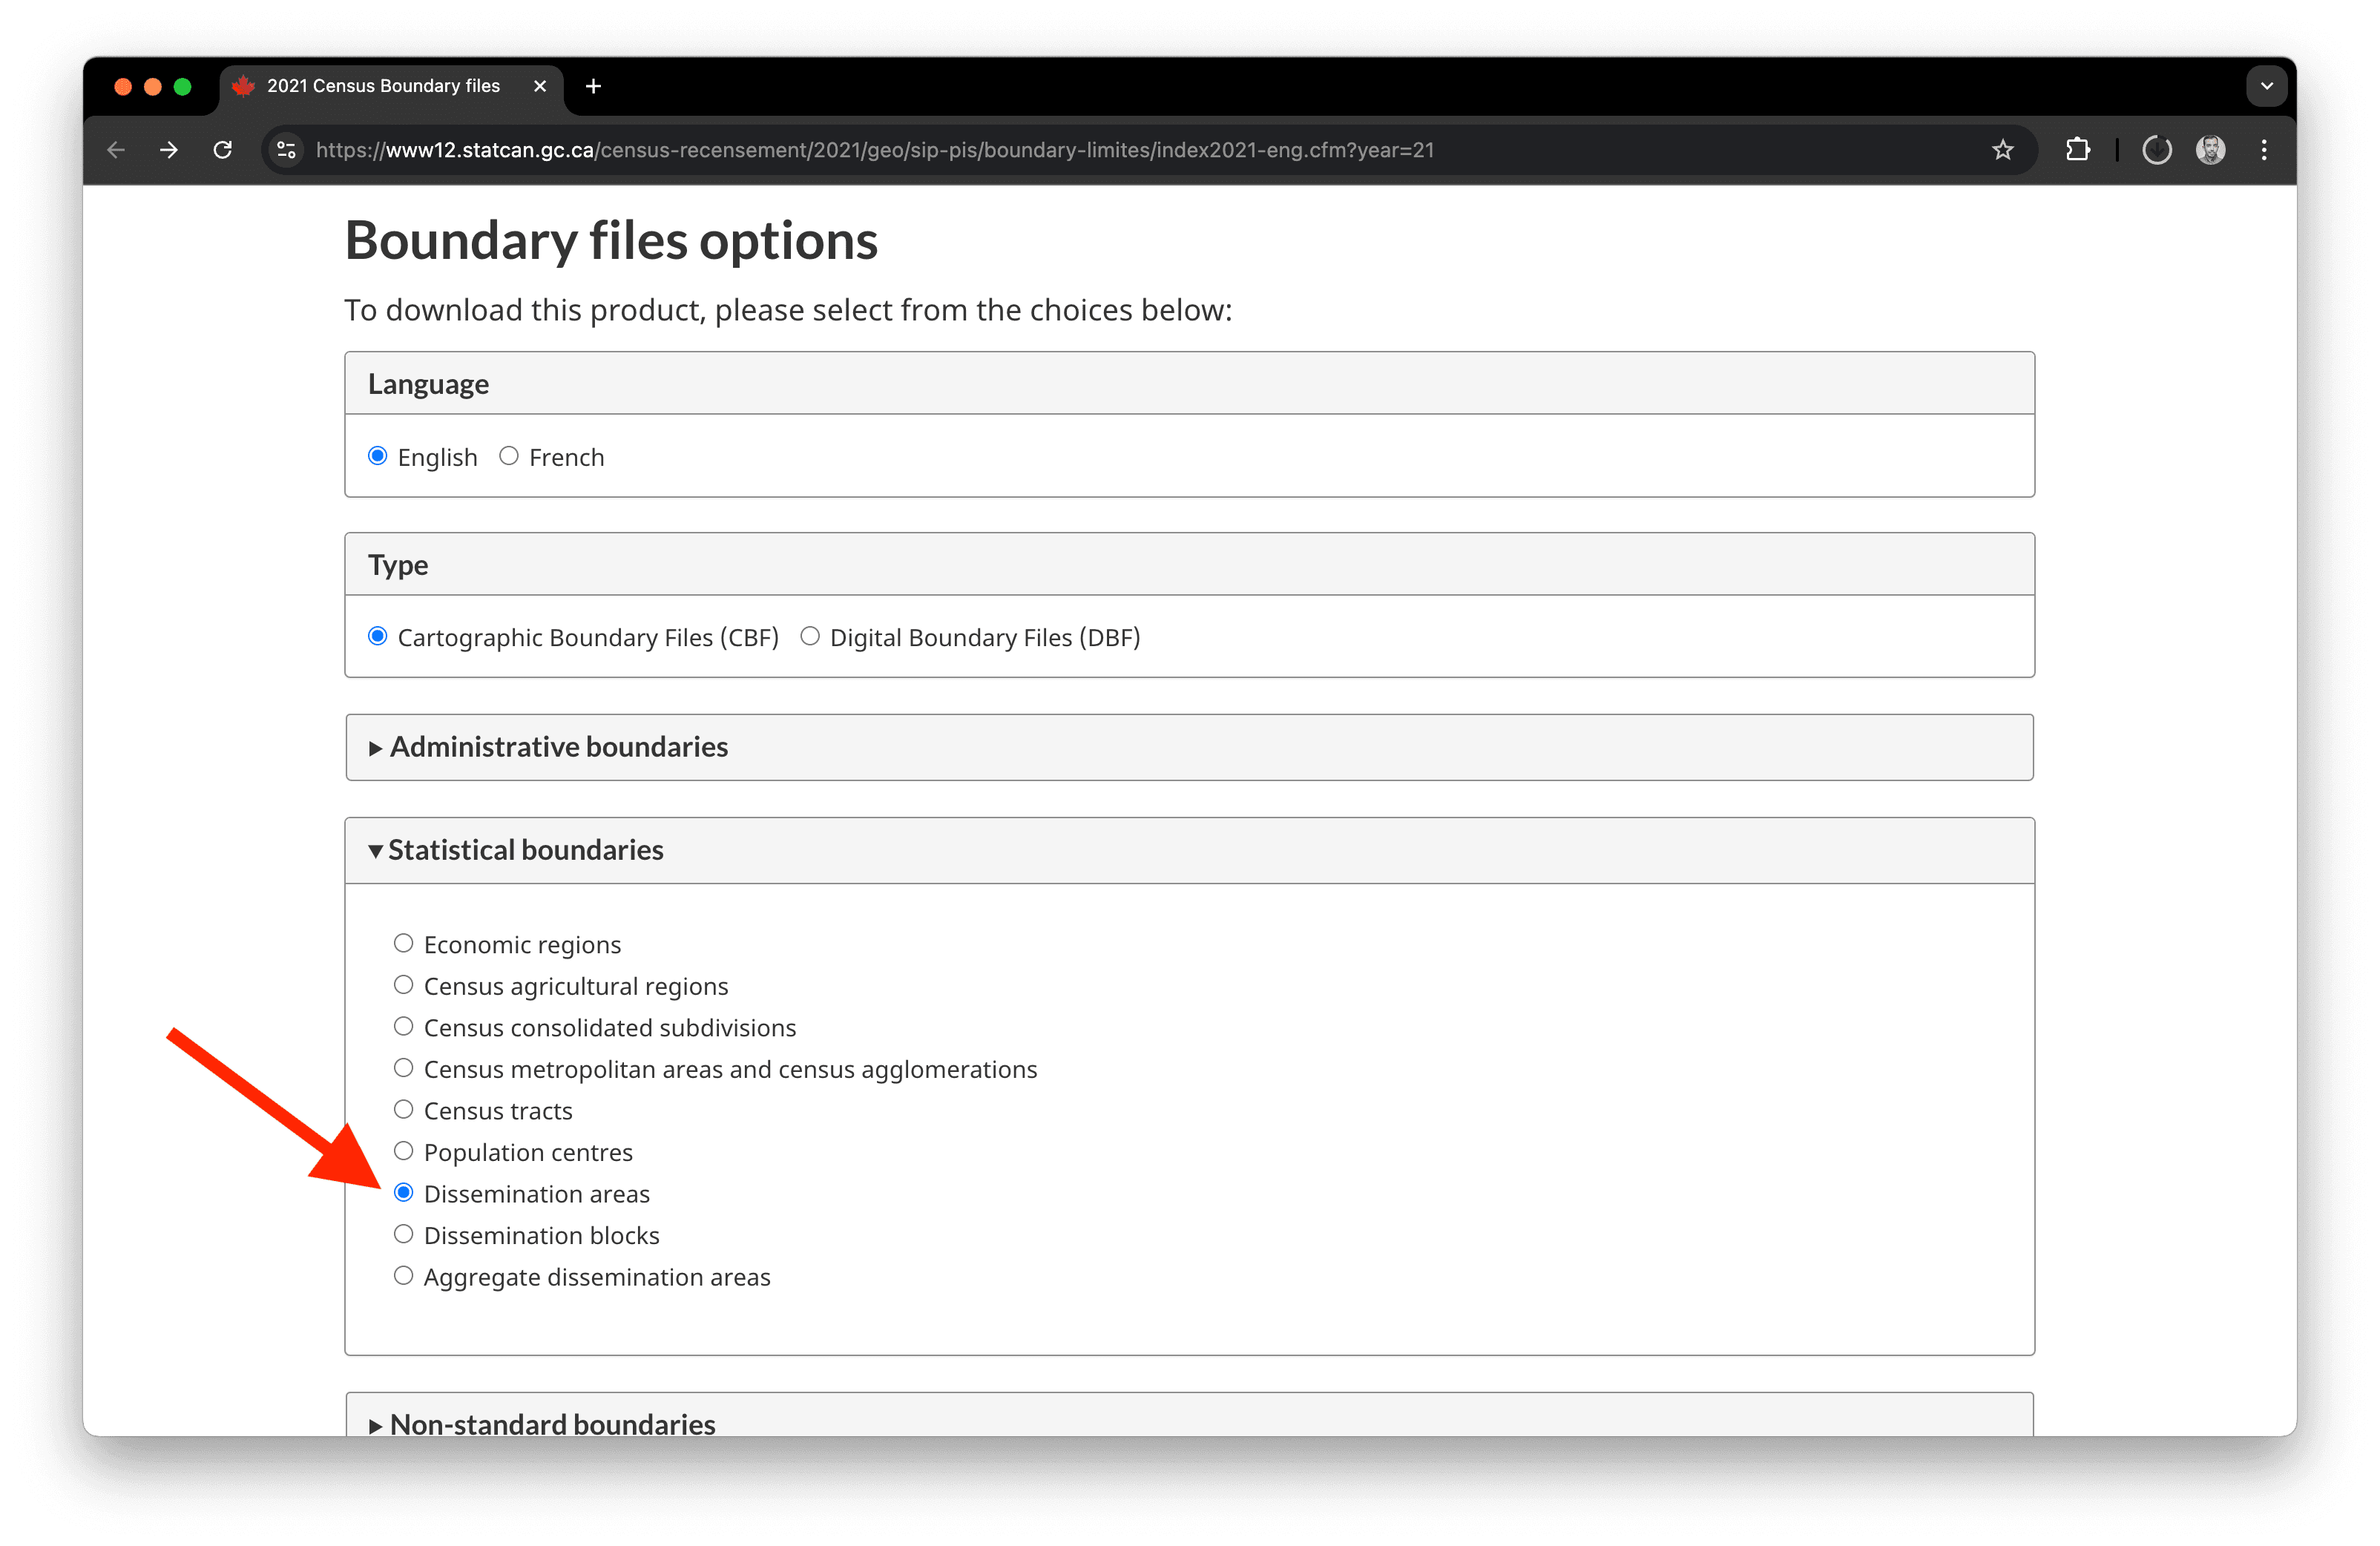
Enfin, pour créer une carte, nous avons besoin des frontières géospatiales des aires de diffusion. Vous les trouverez ici .
Ouvrez le volet Statistical boundaries et sélectionnez Dissemination areas. Dans la section Format, choisissez Shapefile, puis cliquez sur Continue au bas de la page.
Si vous ne le trouvez pas, voici le lien direct pour télécharger le fichier. Il pèse environ 197 Mo.
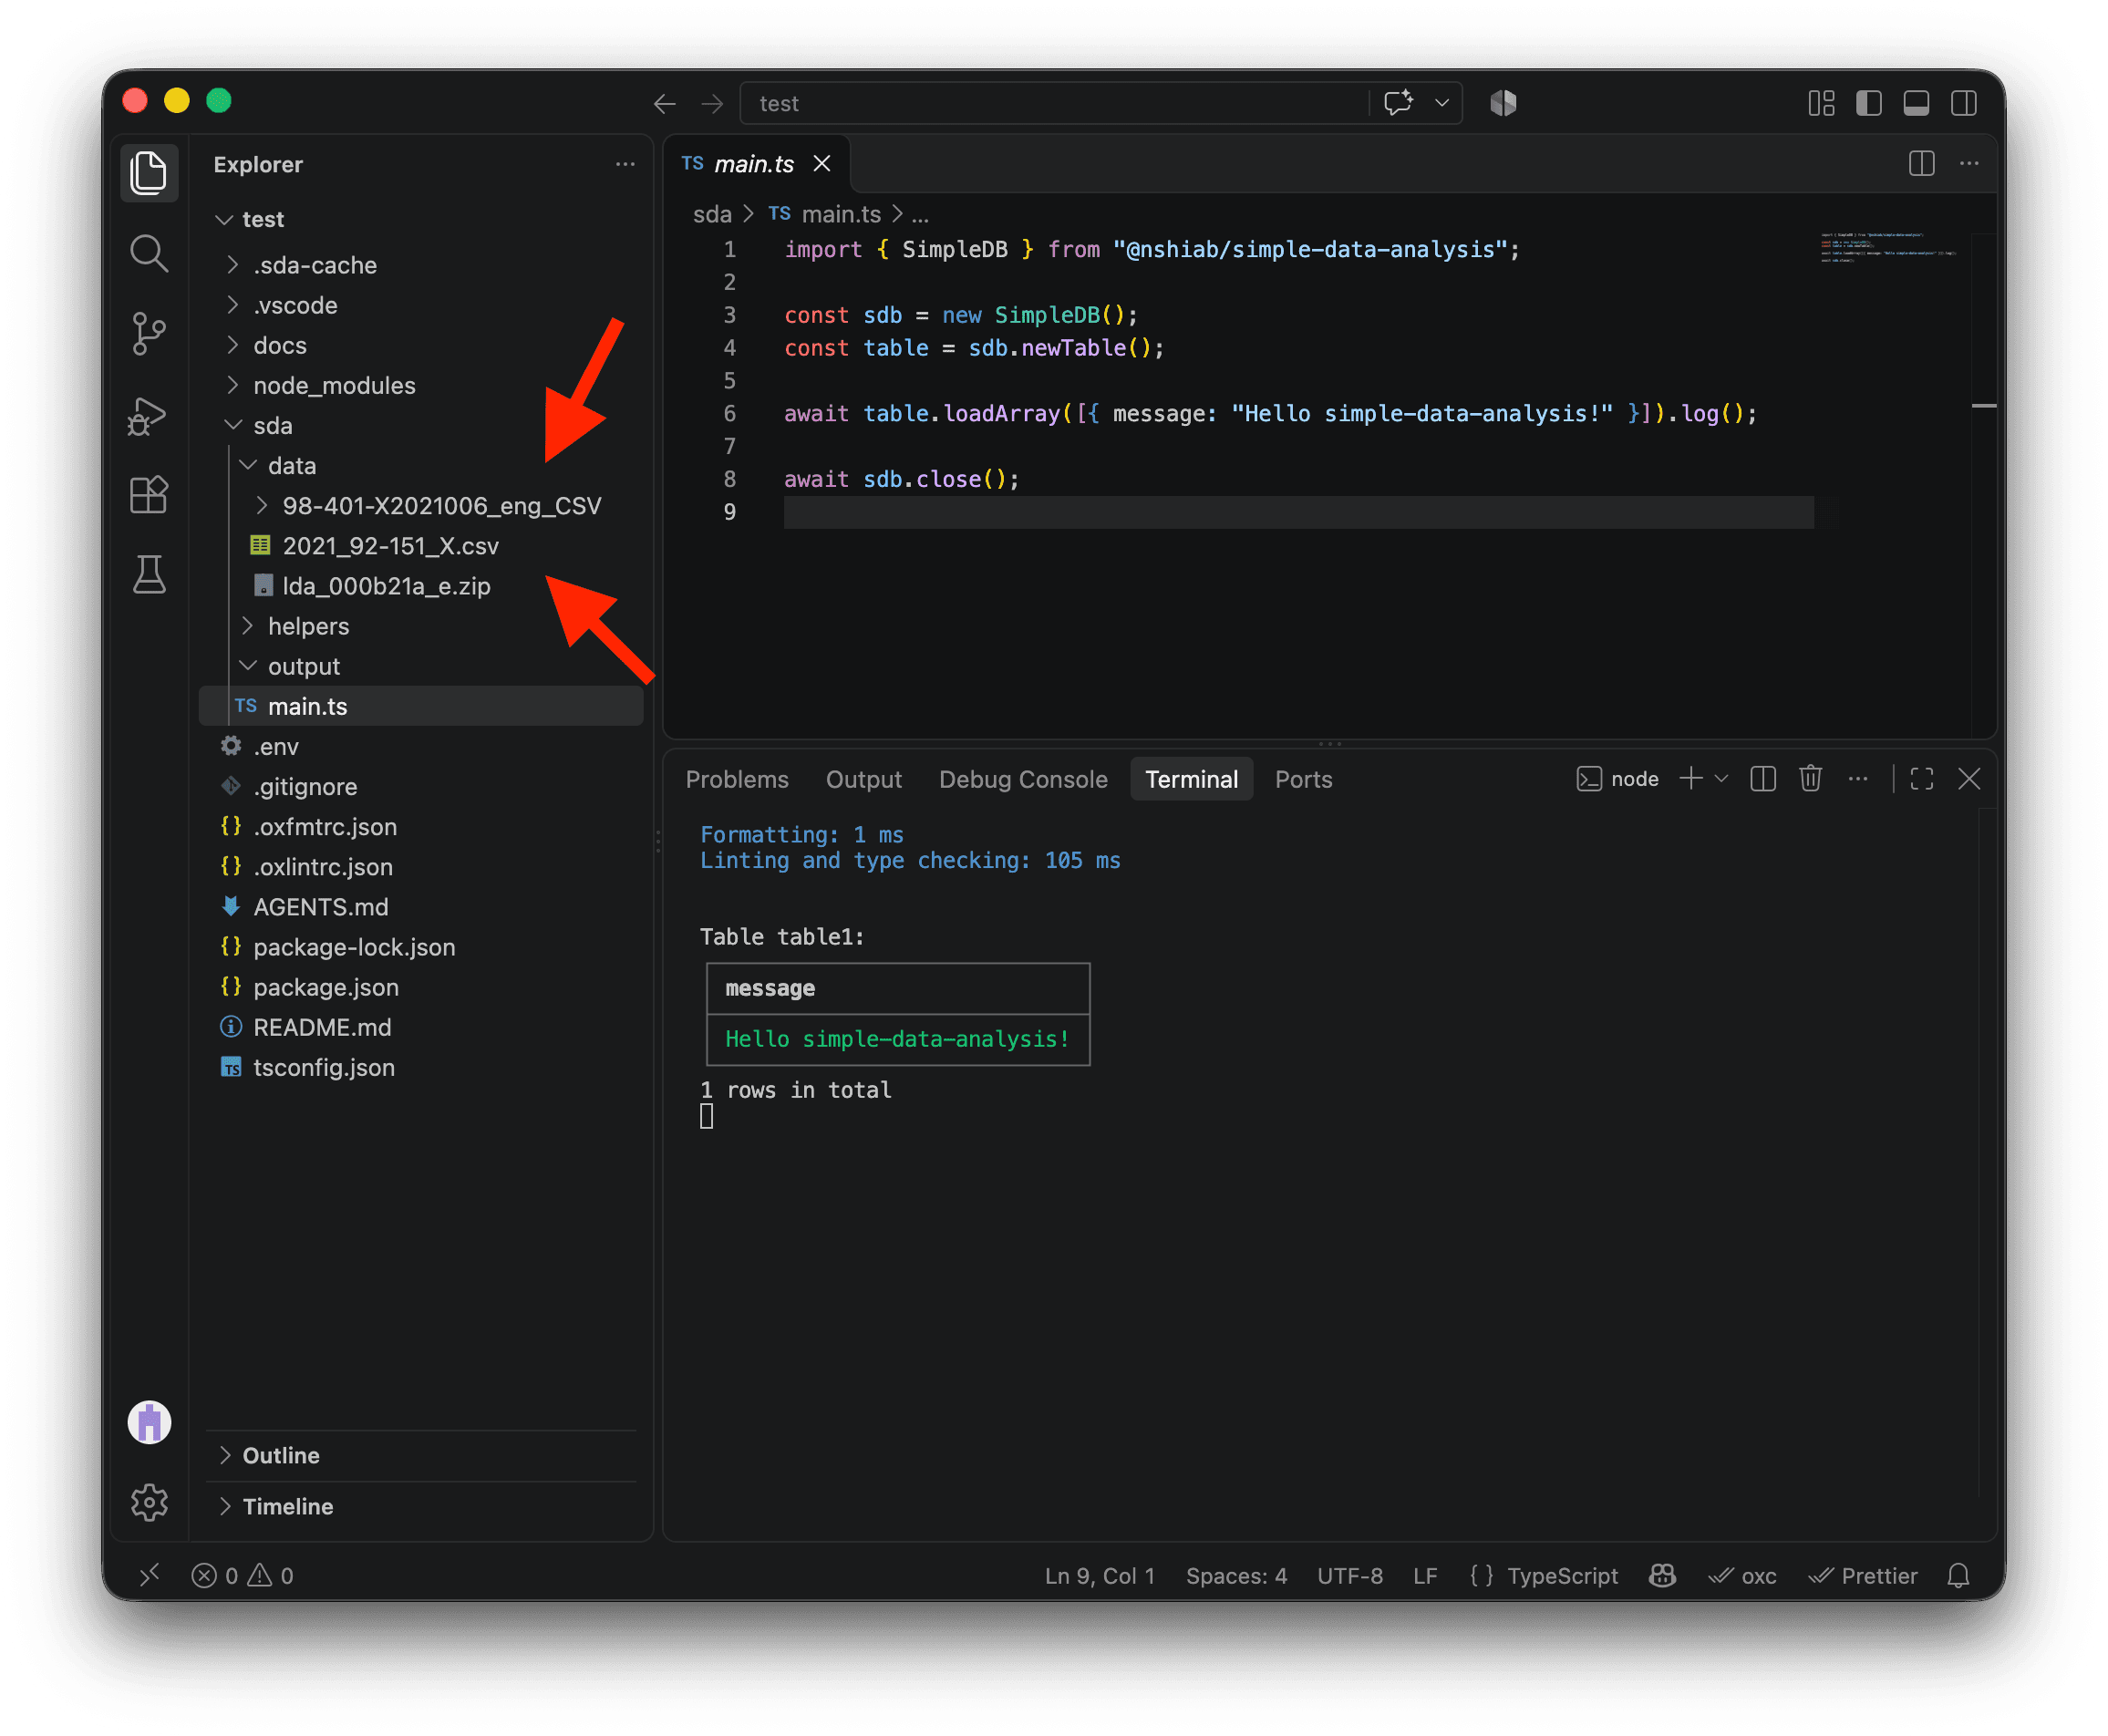
Déplacez tous ces fichiers dans le dossier data de votre projet et décompressez tout, sauf les frontières géospatiales du fichier lda_000b21a_e.zip !
Pour décompresser les fichiers, ouvrez votre dossier en dehors de VS Code, par exemple dans Finder ou l’Explorateur de fichiers. Vous pourriez avoir besoin d’un logiciel comme WinZip ou 7-Zip. Une fois les fichiers décompressés, supprimez les deux fichiers .zip d’origine de votre projet et du dossier Téléchargements, sans oublier de vider la corbeille ! 🗑️ L’espace disque est précieux avec les grands ensembles de données.
Surprise ! Vous avez maintenant plus de 27 Go de données à traiter. 😅
Les données du recensement
Charger seulement ce dont nous avons besoin
En décompressant les données du recensement, nous avons obtenu un dossier contenant plusieurs fichiers. Les données se trouvent dans ceux dont le nom contient _data_.
Essayons de charger les 1 000 premières lignes du premier fichier, qui couvre les provinces de l’Atlantique. Ces fichiers sont très volumineux. Nous utiliserons donc l’option limit pour explorer un échantillon.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB();

await sdb
  .newTable("census")
  .loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_Atlantic.csv",
    { limit: 1000 },
  ).log();

await sdb.close();
Hum… Il y a un problème. Cette erreur signifie que les données n’utilisent pas l’encodage UTF-8, devenu la norme aujourd’hui.
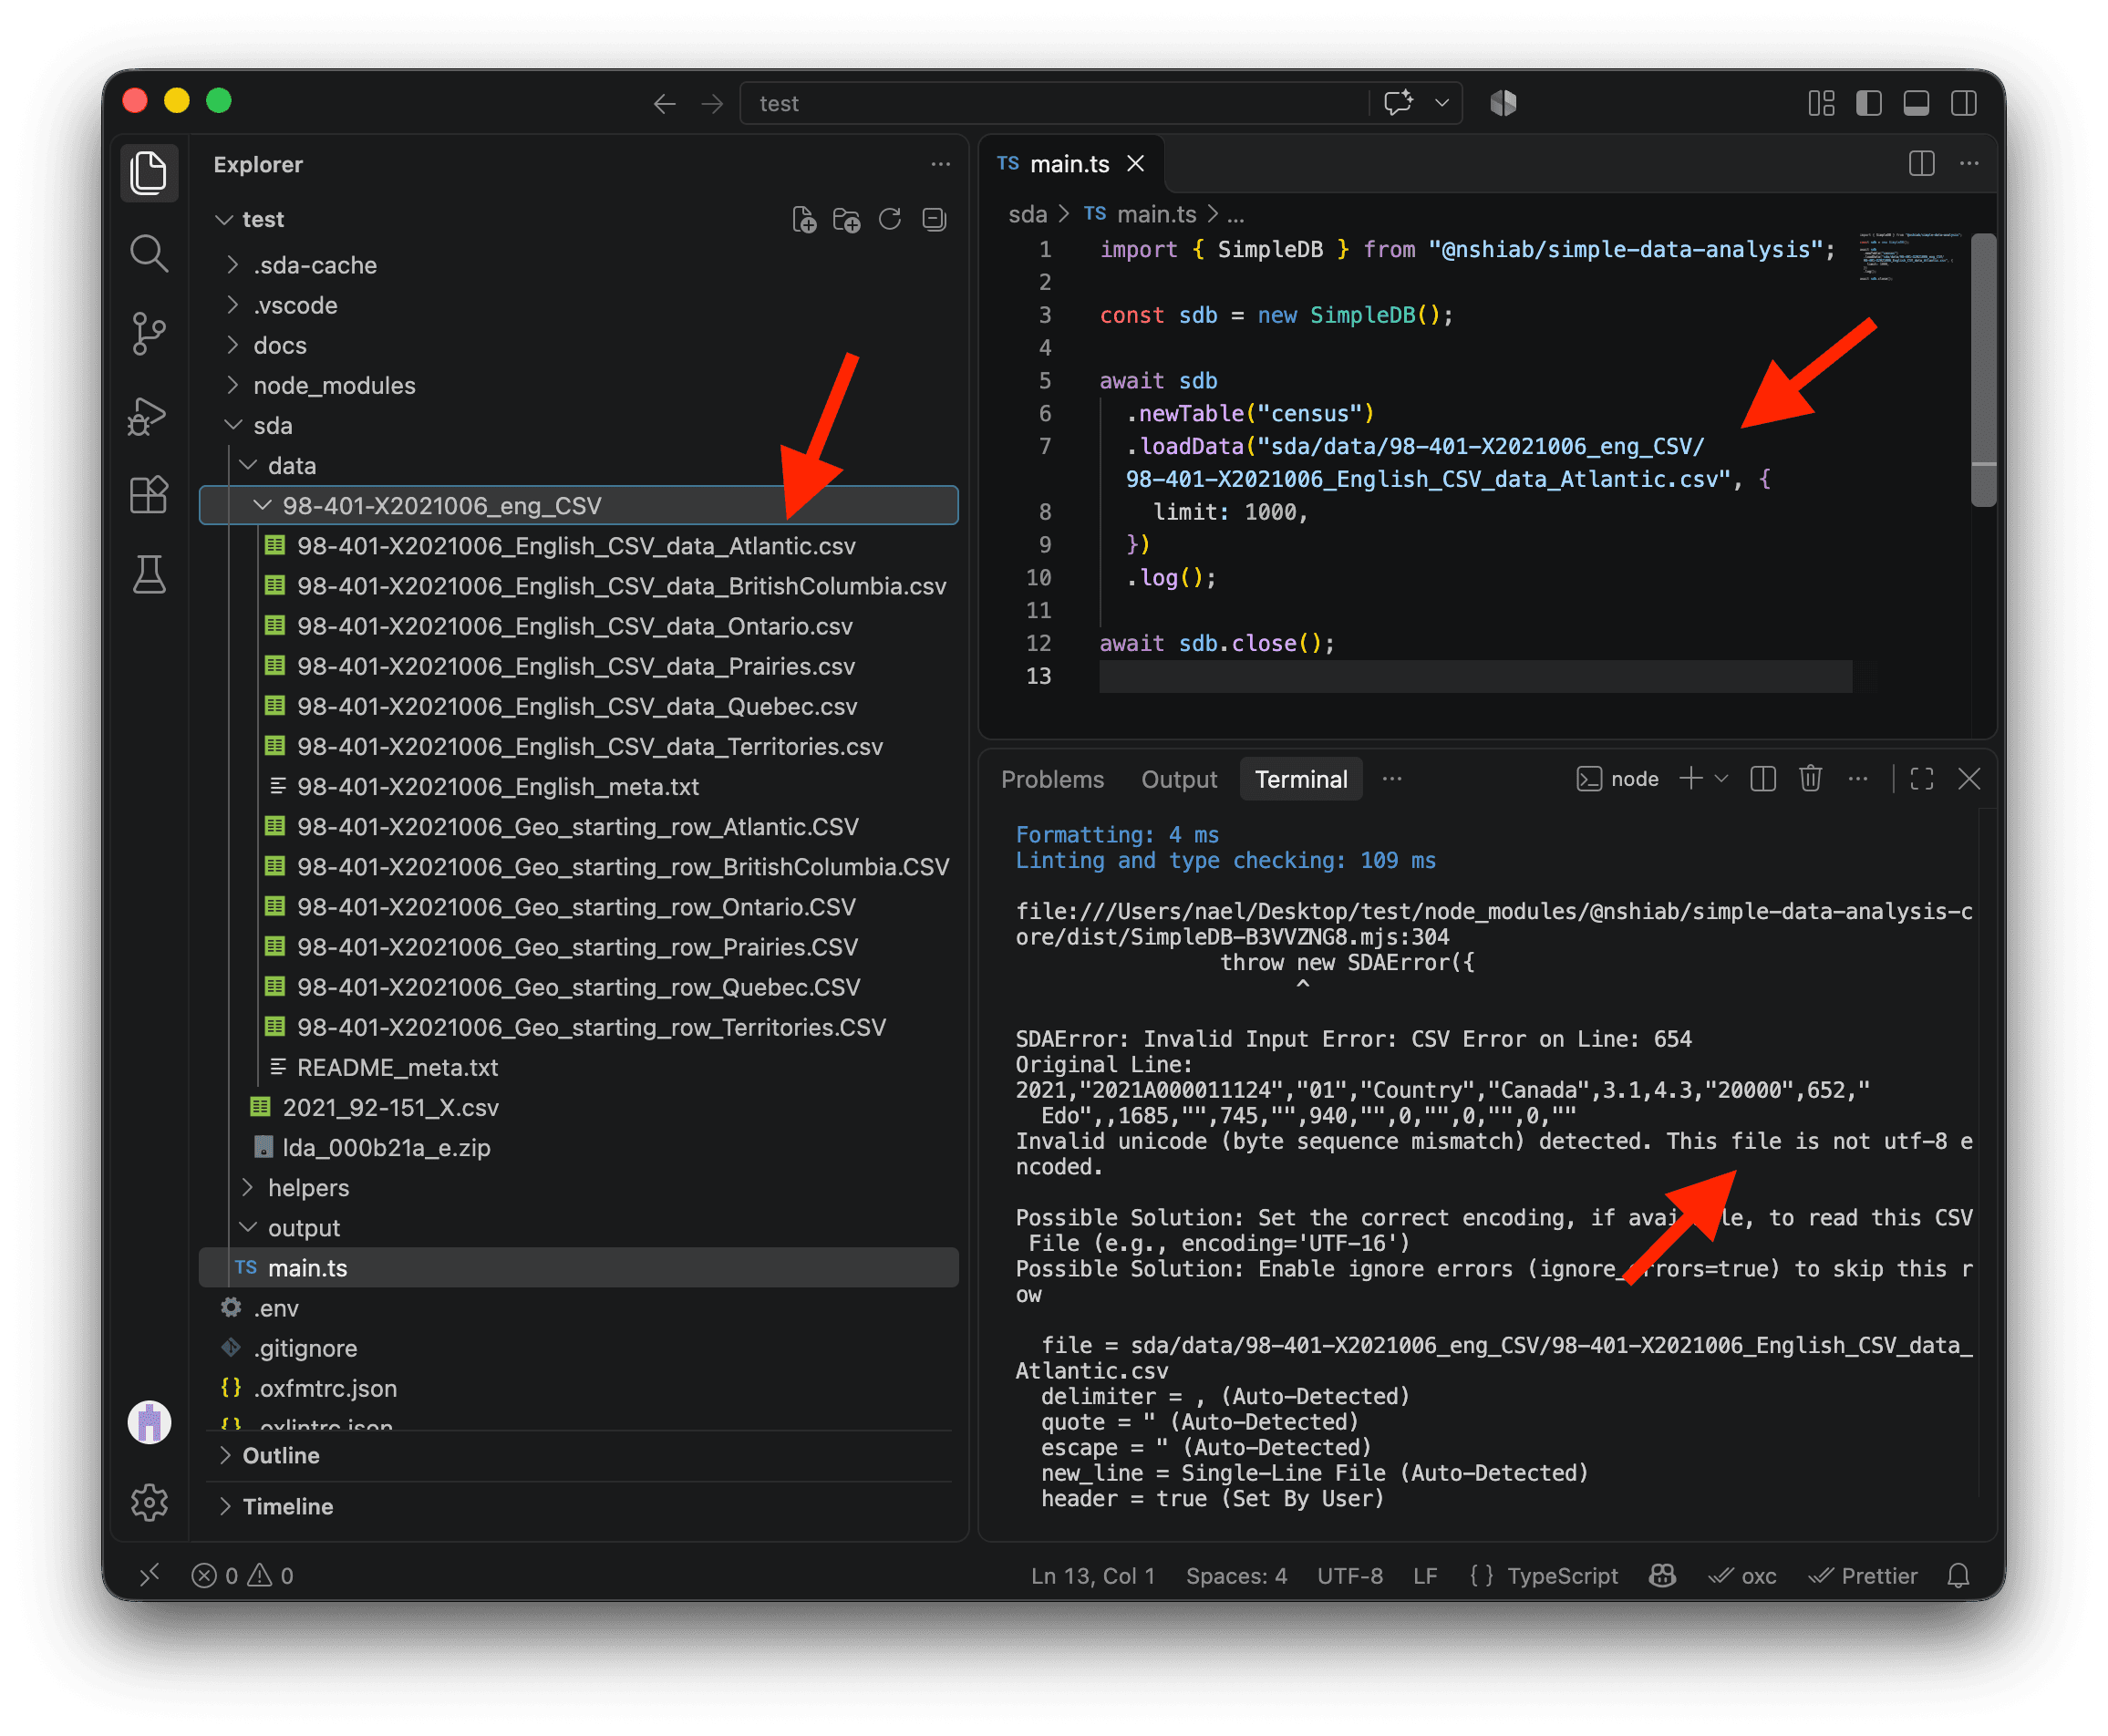
Le chemin du fichier CSV de l’Atlantique est long. Pour le copier sans le taper, faites un clic droit sur le fichier dans l’explorateur de VS Code et sélectionnez Copy Relative Path.
J’ai demandé à Statistique Canada quel encodage était utilisé. On m’a répondu qu’il s’agissait de Windows-1252. Heureusement, SDA offre une option encoding. Nous pouvons utiliser cp1252 pour désigner cet encodage, et SDA convertira automatiquement les données en UTF-8 en arrière-plan.
Mettez votre code à jour avec l’exemple ci-dessous et enregistrez le fichier (COMMAND + S sur Mac ou CTRL + S sur Windows). Les 1 000 premières lignes devraient maintenant apparaître.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB();

await sdb
  .newTable("census")
  .loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_Atlantic.csv",
    { limit: 1000, encoding: "cp1252" },
  ).log();

await sdb.close();
Génial, ça fonctionne ! 🥳
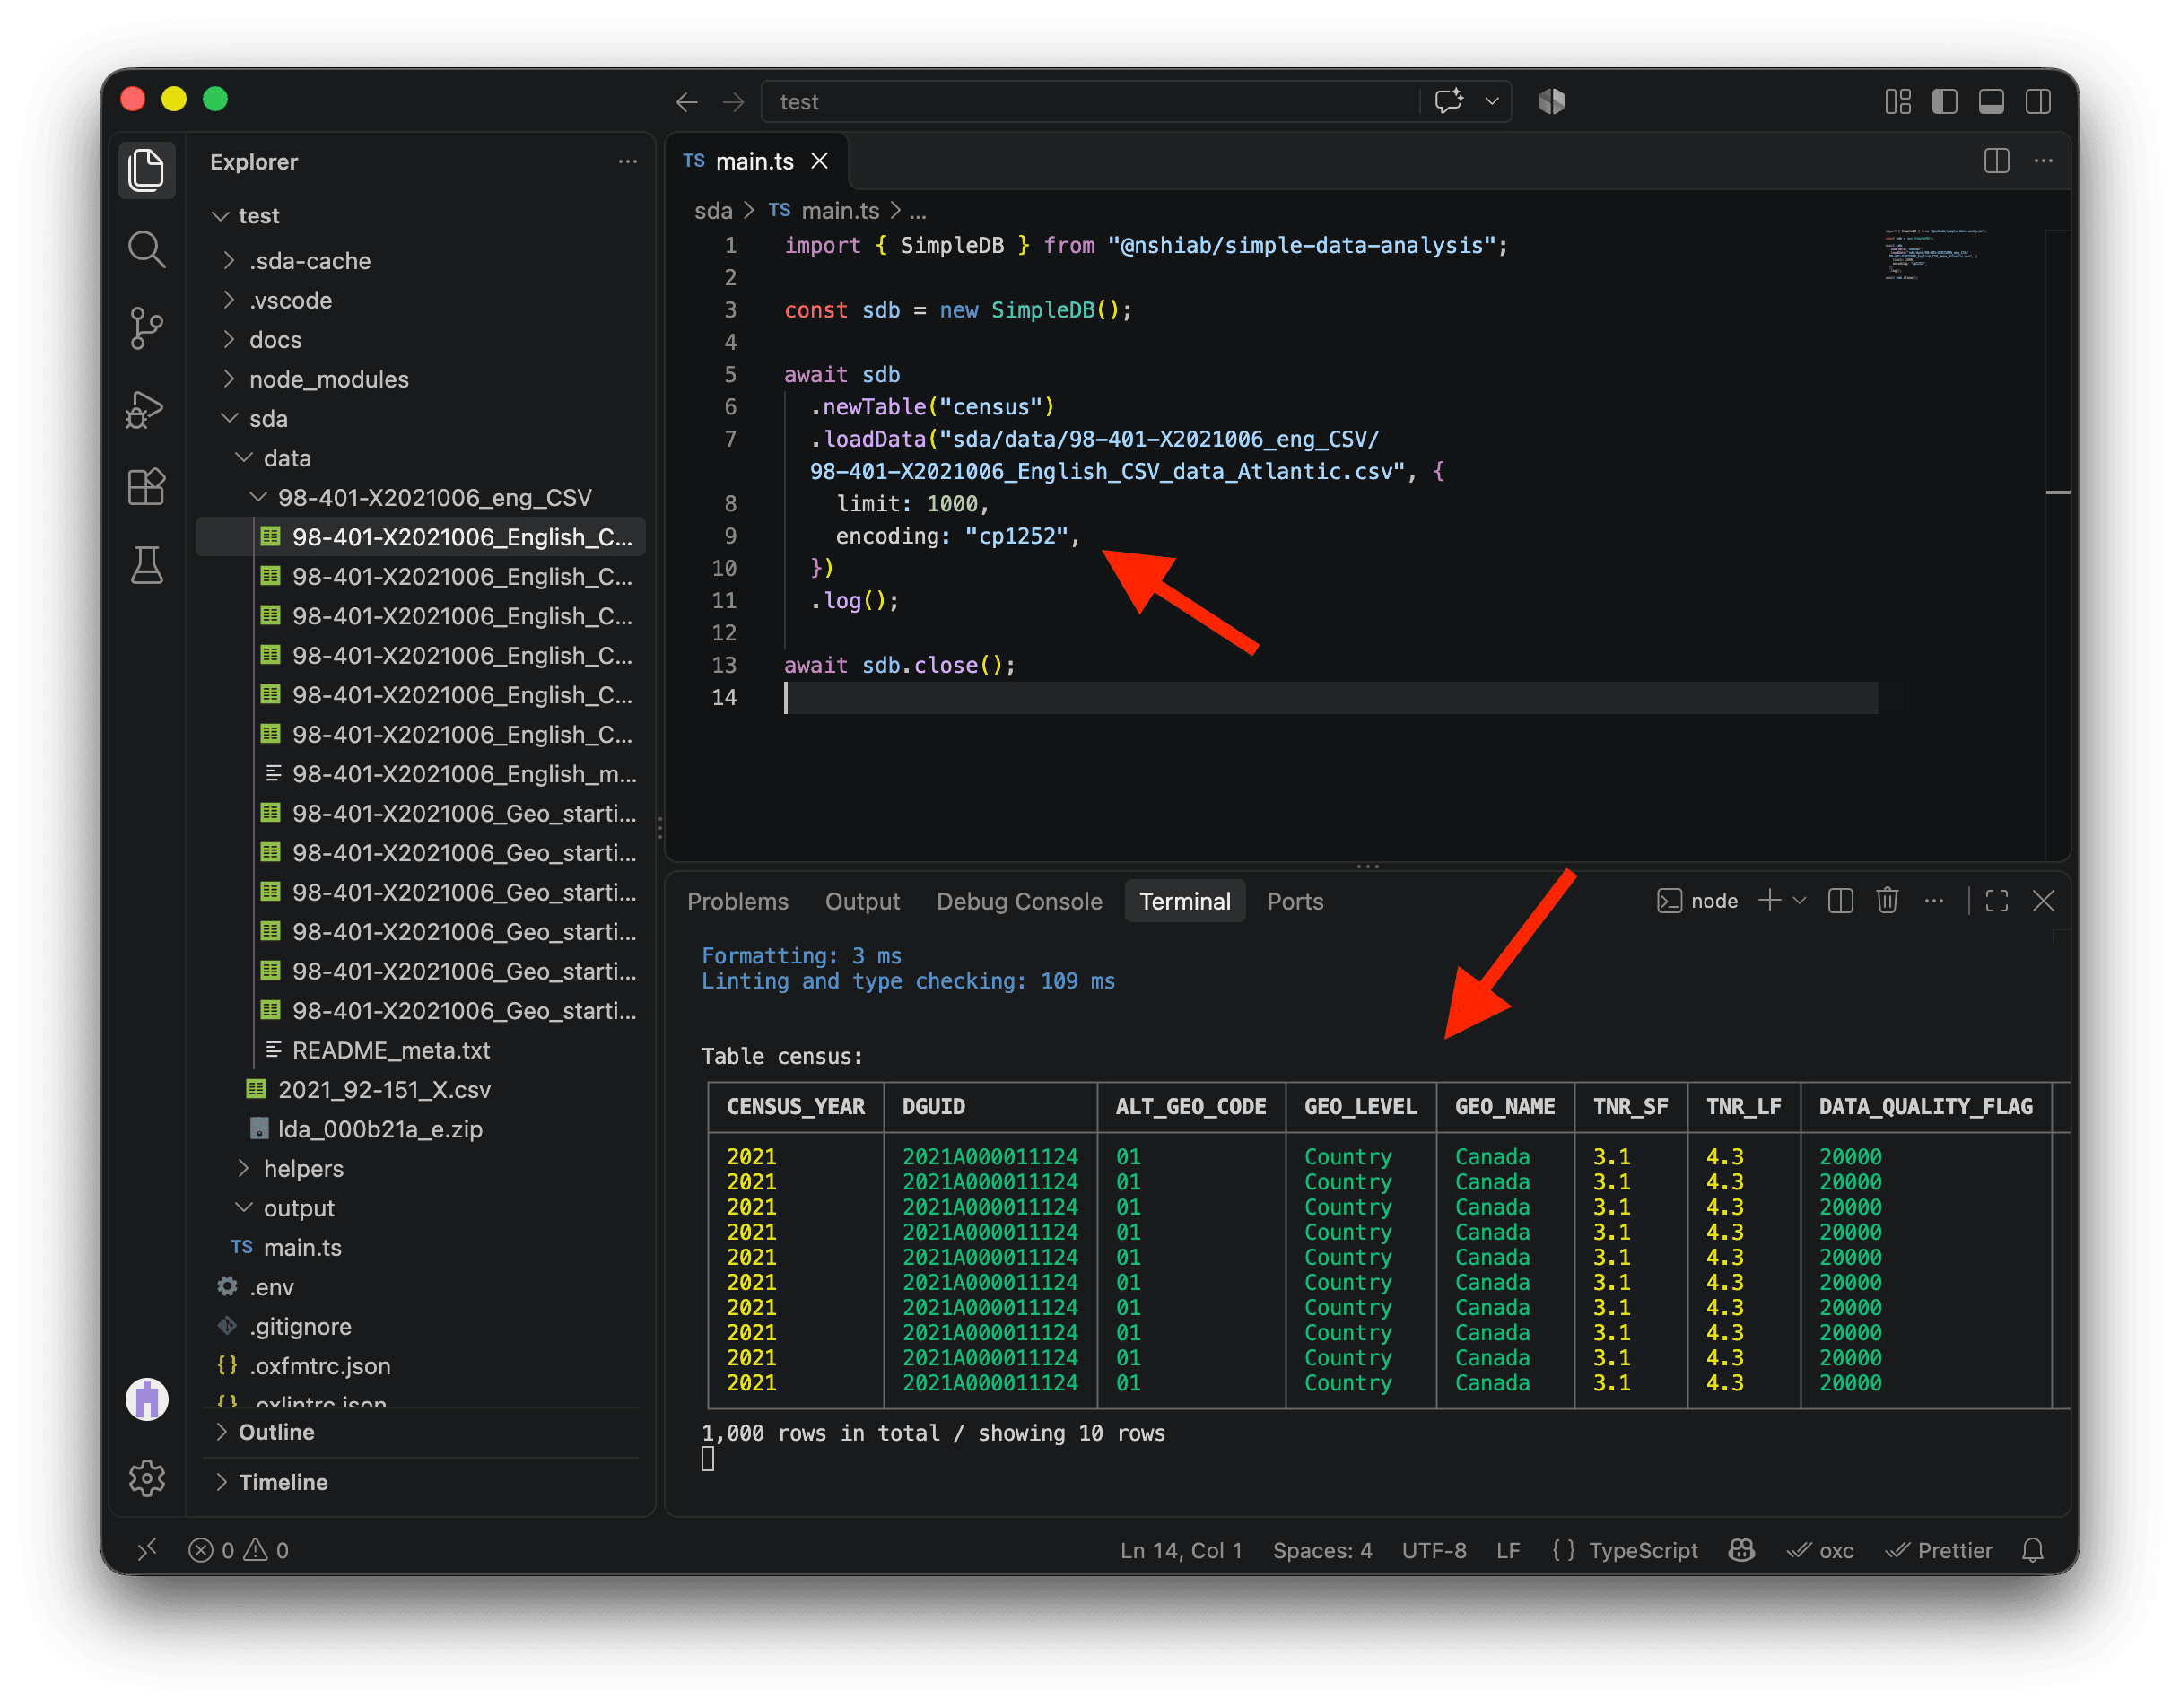
Si le tableau s’affiche bizarrement dans votre terminal, c’est parce qu’il est plus large que celui-ci. Faites un clic droit dans le terminal et cherchez Toggle size with content width. J’utilise aussi souvent le raccourci OPTION + Z sur Mac ou ALT + Z sur PC.
Notre table contient beaucoup de colonnes, mais nous n’en avons besoin que de quatre dans le fichier CSV :
GEO_LEVEL: le type de région géographique représentée par la ligne.CHARACTERISTIC_ID: la variable du recensement représentée par la ligne.DGUID: l’identifiant géographique unique que nous utiliserons pour joindre les données.C1_COUNT_TOTAL: la valeur de la variable du recensement.
Nous pouvons utiliser l’option columns pour ne charger que ces quatre colonnes.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB();

await sdb
  .newTable("census")
  .loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_Atlantic.csv",
    {
      limit: 1000,
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
    },
  ).log();

await sdb.close();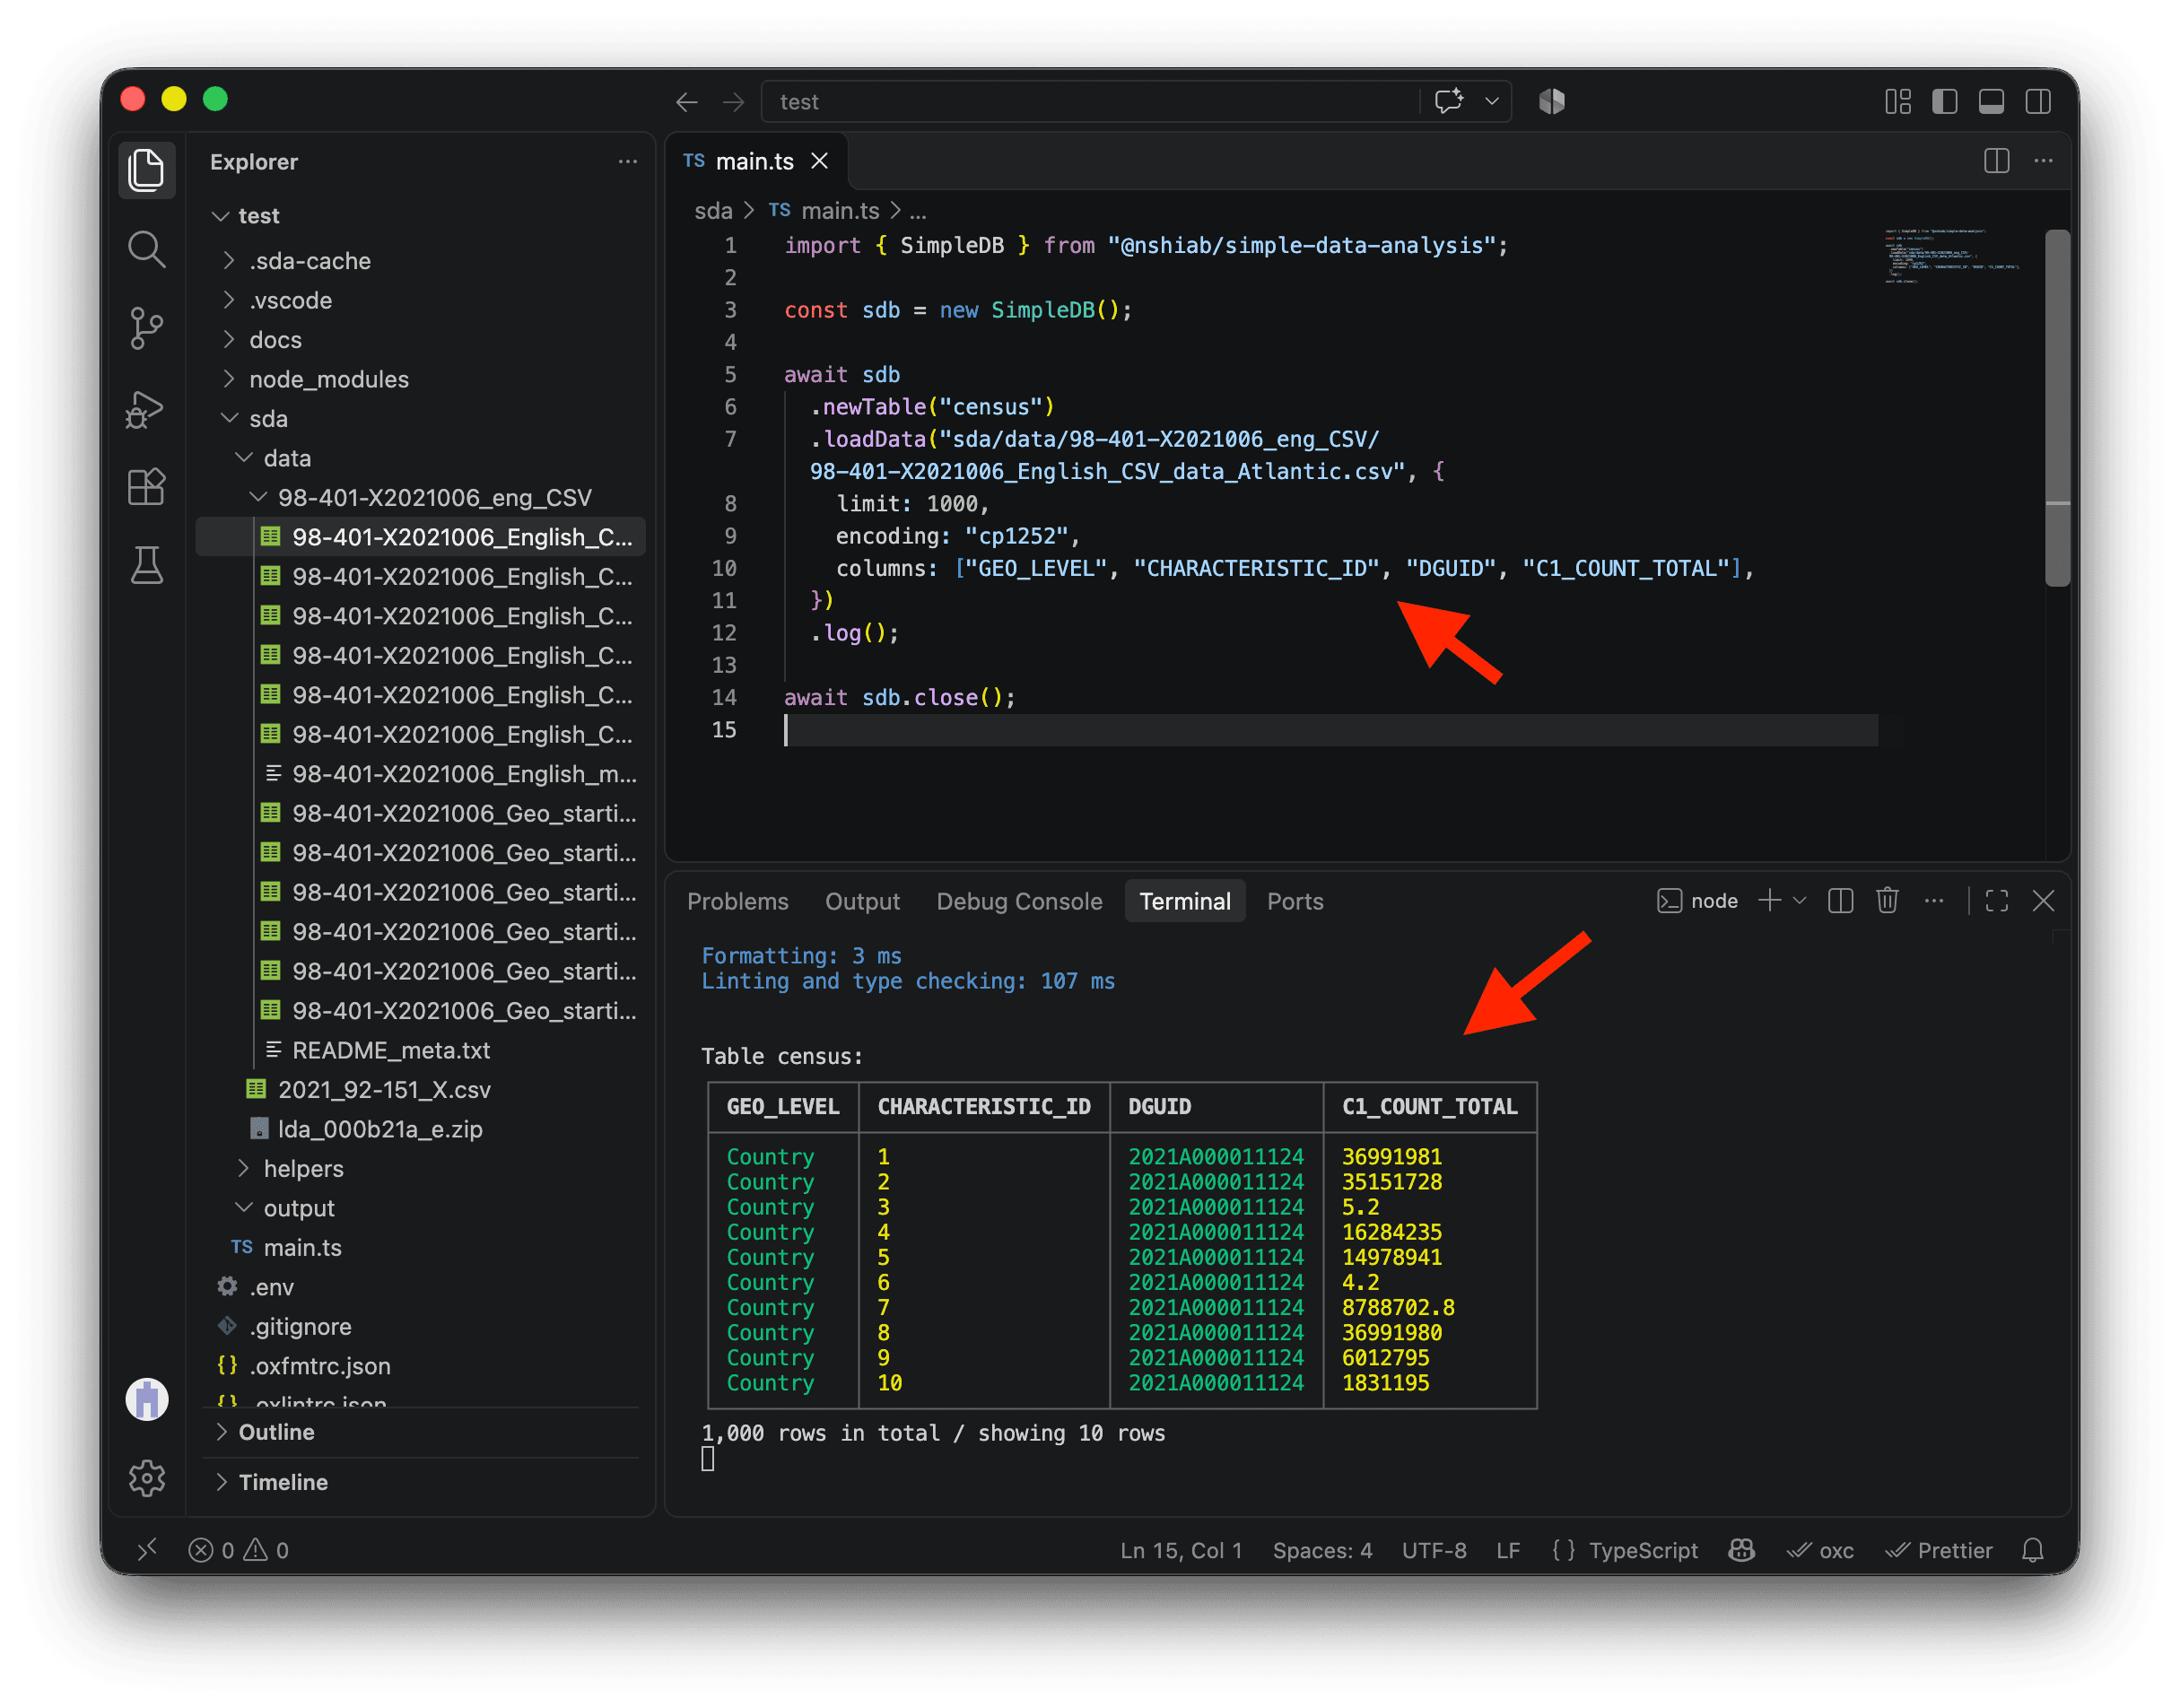
La colonne GEO_LEVEL affiche actuellement des lignes pour le pays. C’est parce que le fichier téléchargé contient le Canada, les provinces, les territoires, les divisions de recensement, les subdivisions de recensement et les aires de diffusion, alors que nous n’avons besoin que des aires de diffusion.
Nous pouvons utiliser l’option conditions pour ne garder que les lignes des aires de diffusion.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB();

await sdb
  .newTable("census")
  .loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_Atlantic.csv",
    {
      limit: 1000,
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  ).log();

await sdb.close();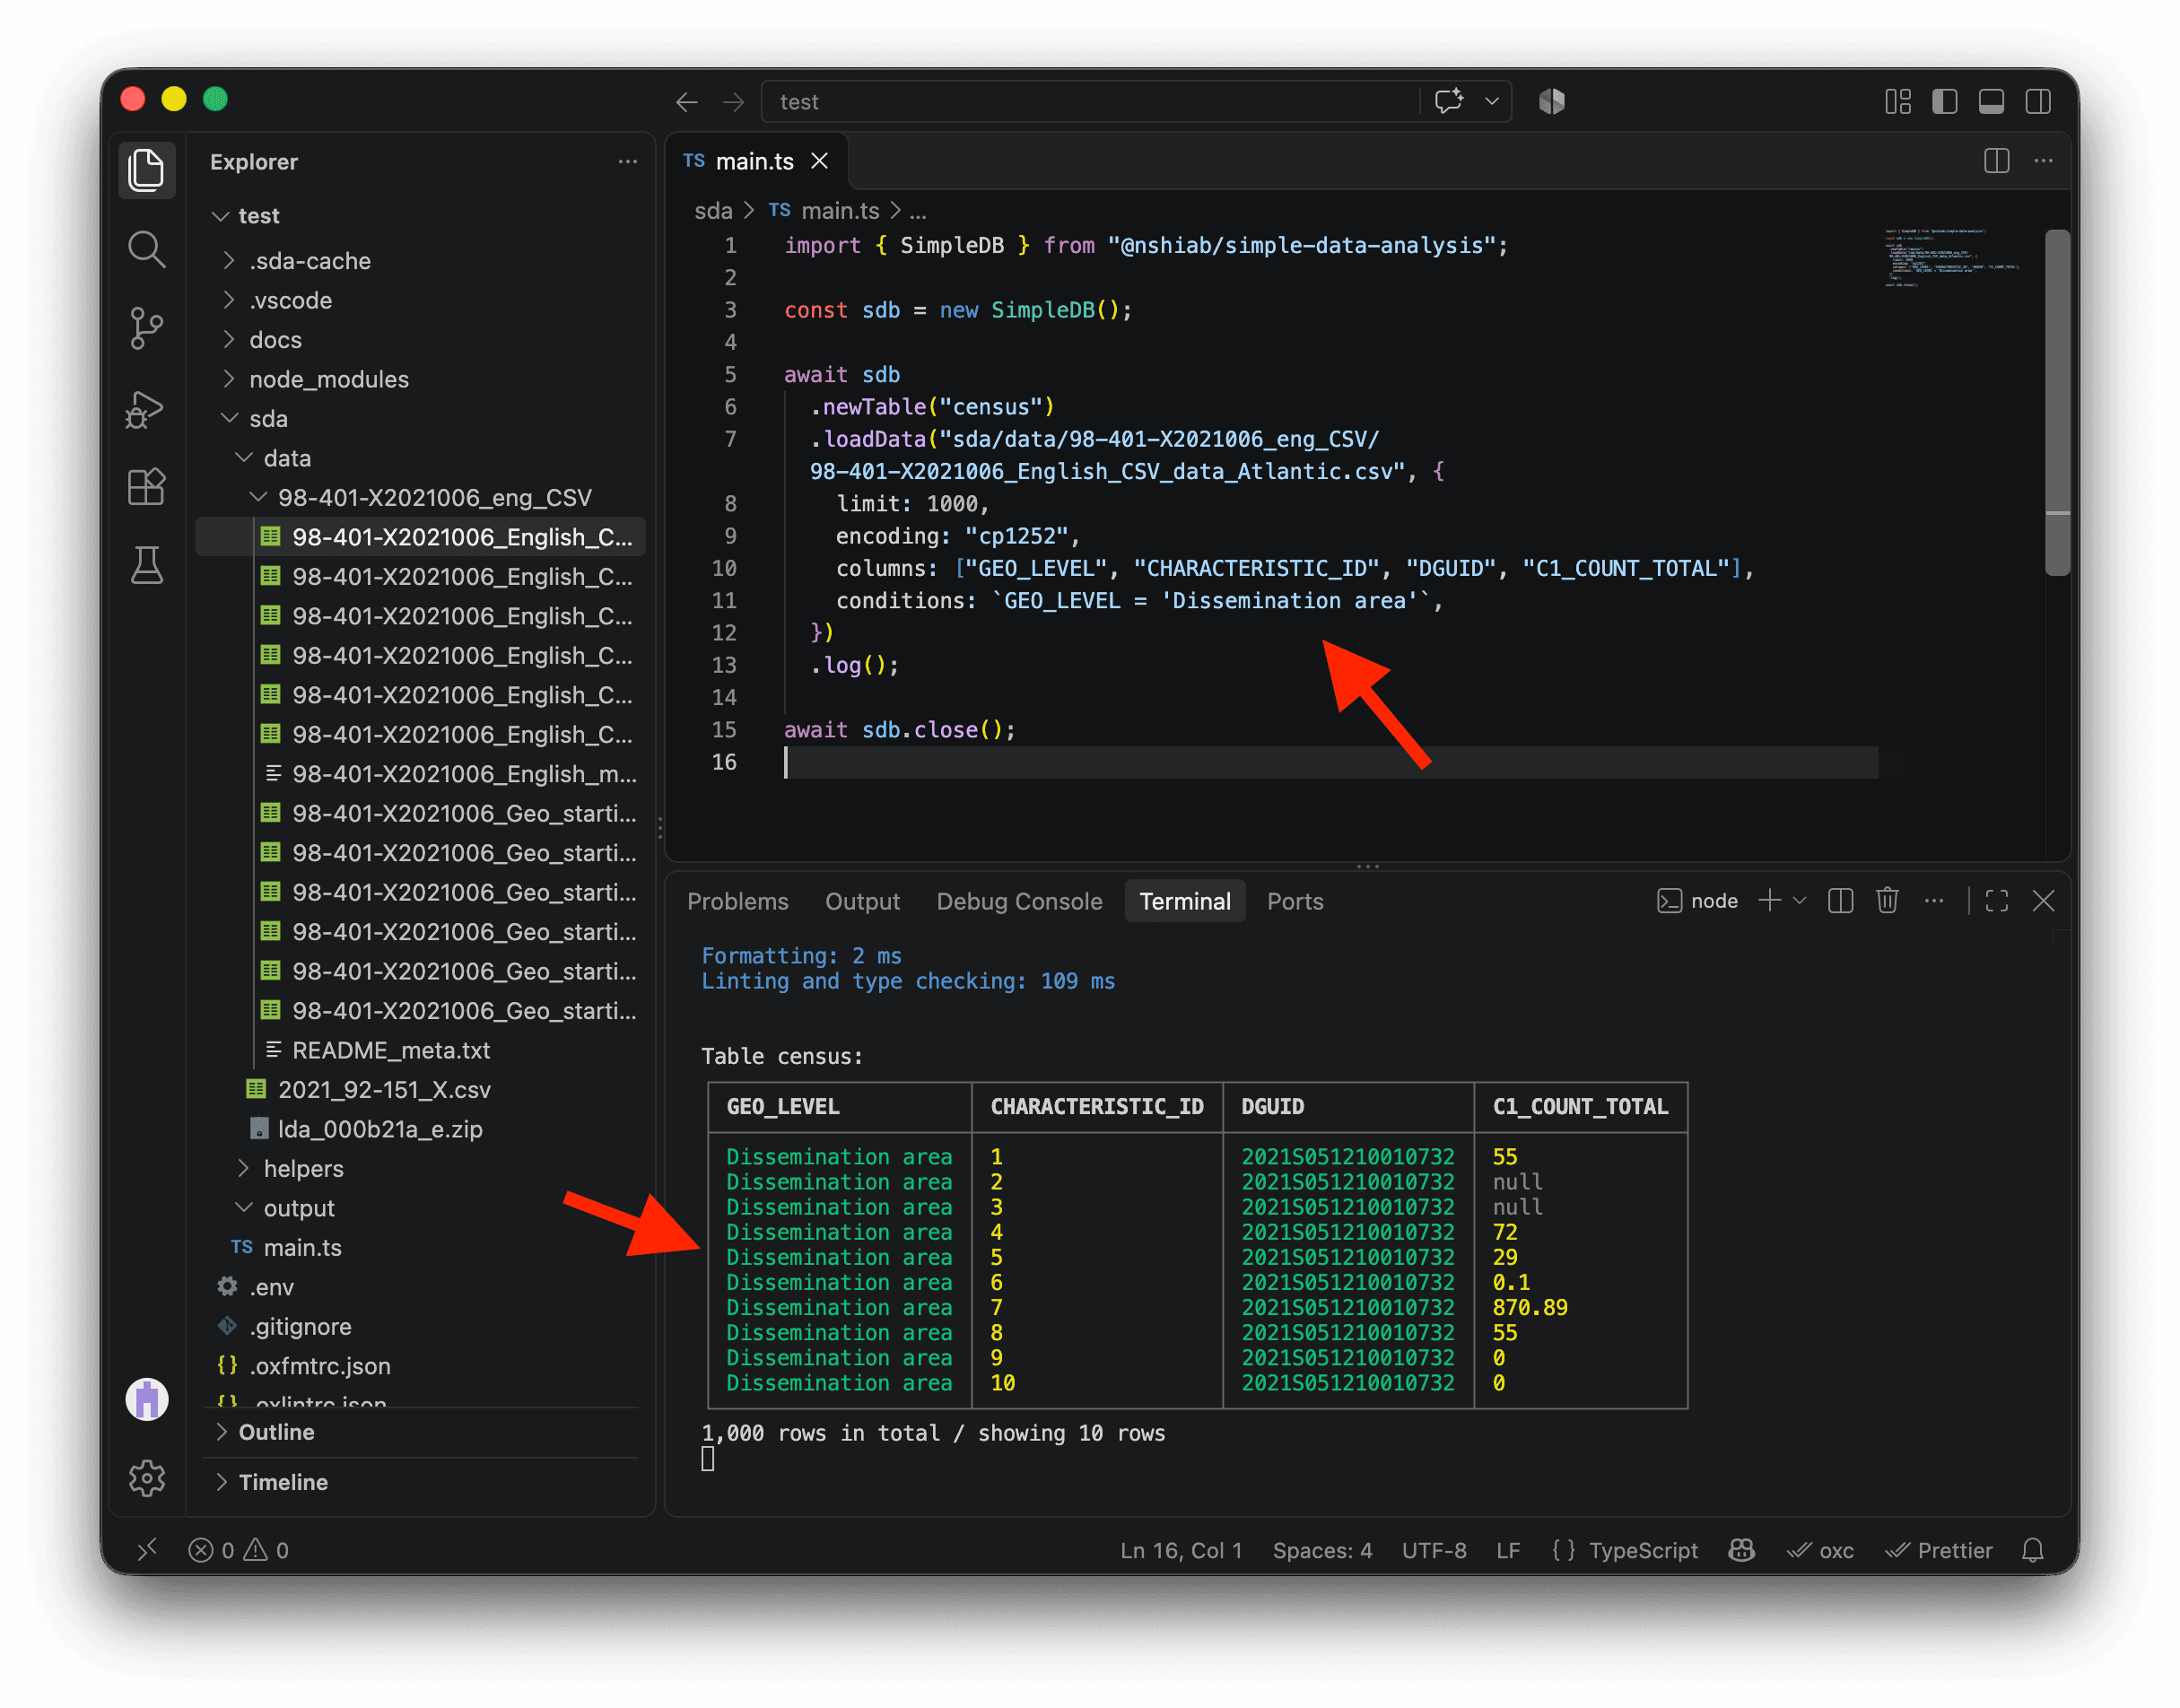
Nous pouvons maintenant retirer l’option limit et charger toutes les données du fichier CSV de l’Atlantique. Avant cela, utilisons la méthode cache et activons l’option cacheVerbose pour voir dans le terminal quelles données SDA met en cache et comment.
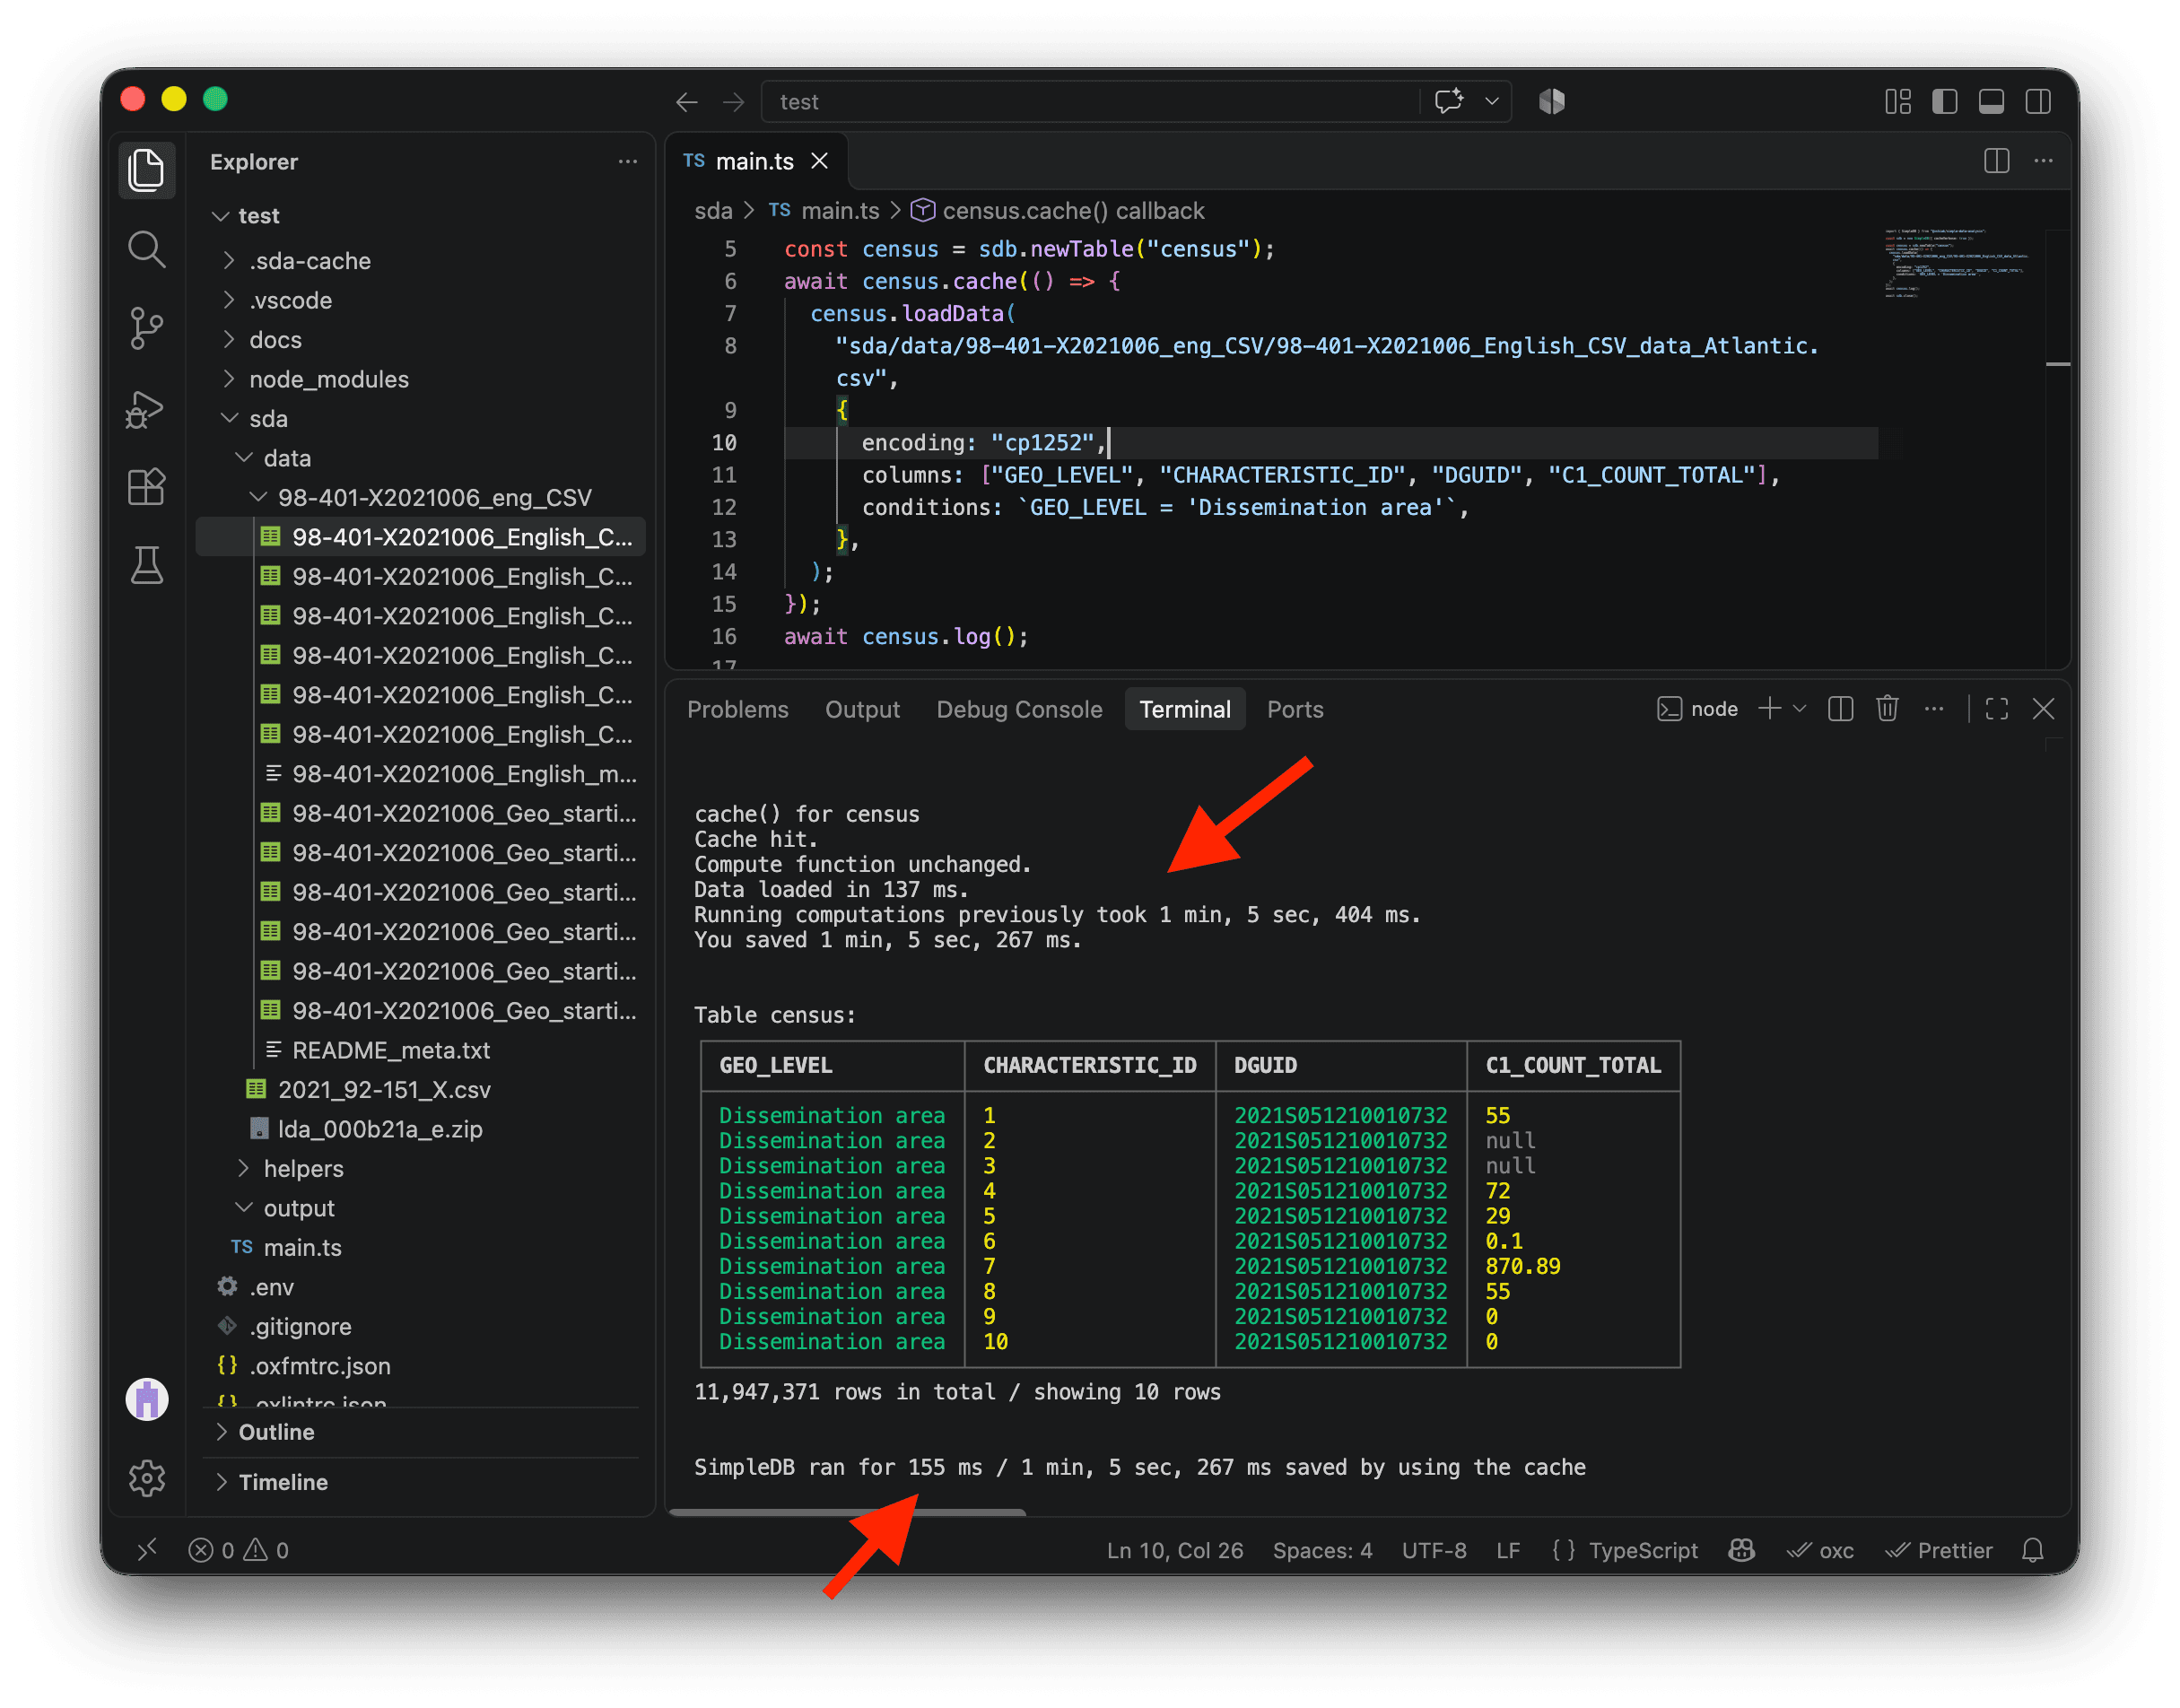
Au premier lancement, cache exécute le code que nous lui passons et enregistre la table obtenue dans un nouveau dossier .sda-cache. Aux lancements suivants, si le code n’a pas changé, SDA charge le résultat directement depuis le cache au lieu de relire le fichier d’origine, de convertir son encodage, de sélectionner ses colonnes et de filtrer ses lignes. C’est beaucoup plus rapide.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ cacheVerbose: true });

const census = sdb.newTable("census");
await census.cache(() => {
  census.loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_Atlantic.csv",
    {
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  );
});
await census.log();

await sdb.close();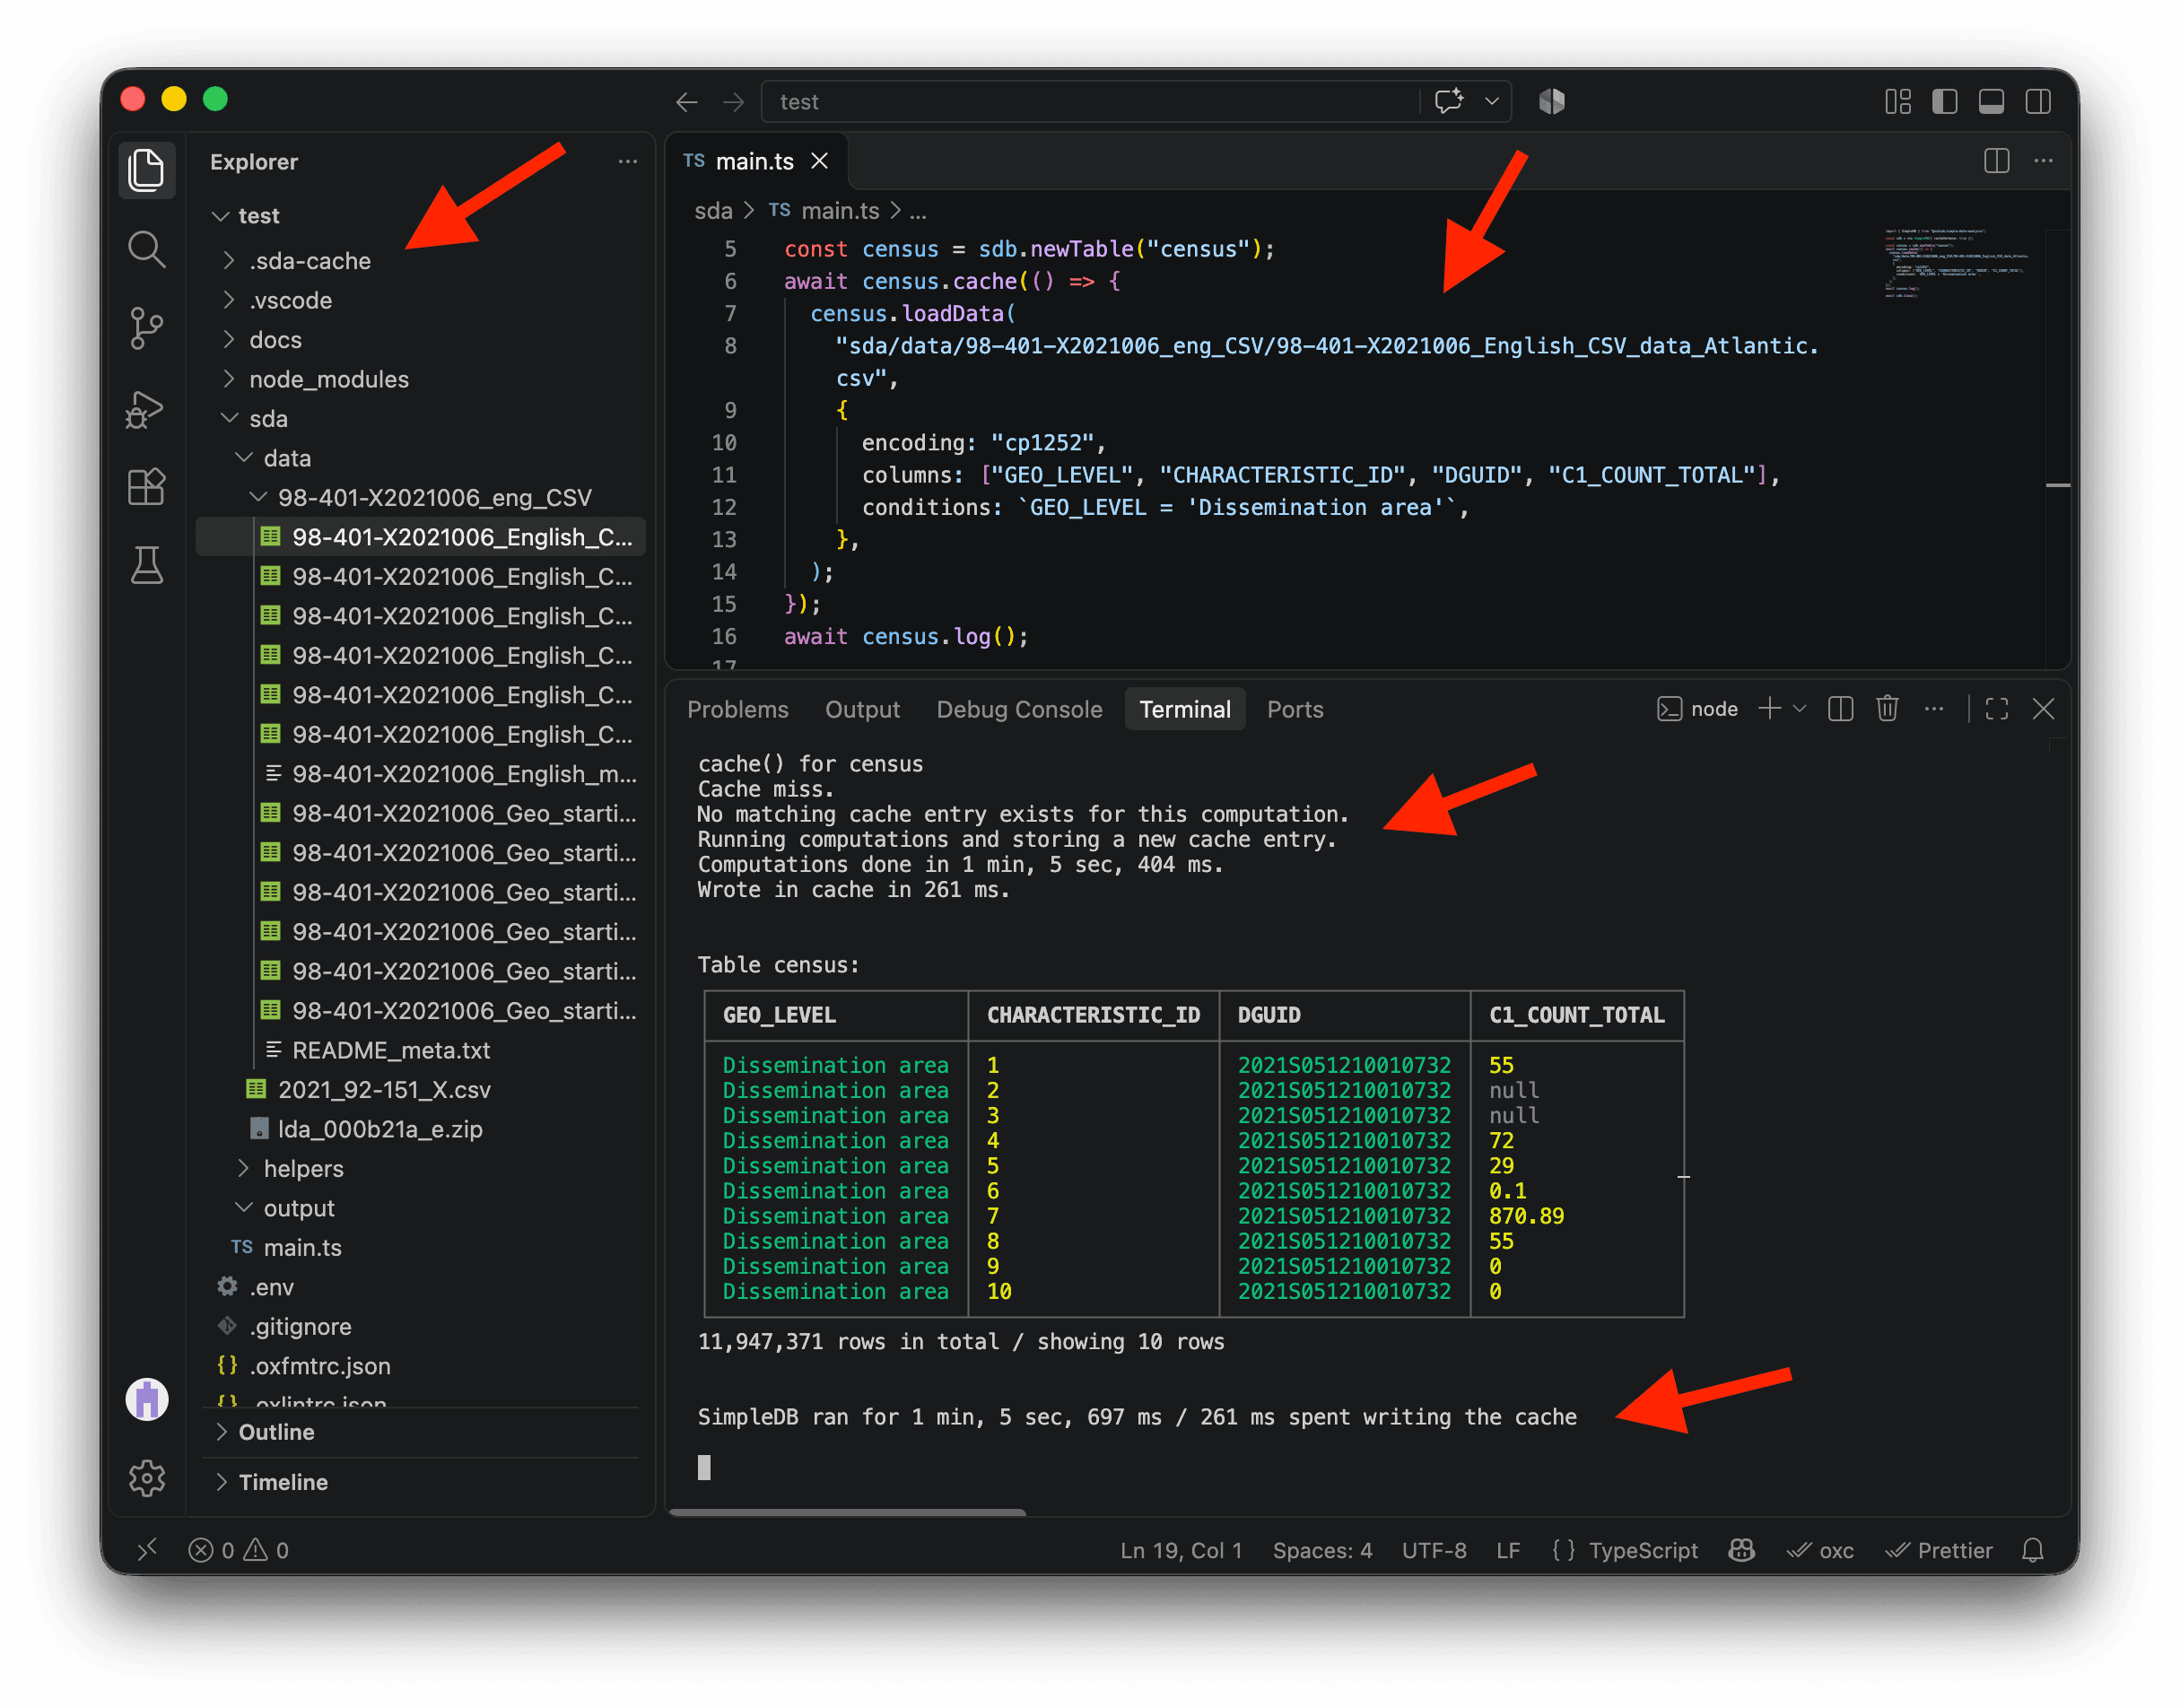
Sur mon ordinateur, le chargement de près de 12 millions de lignes a pris environ 1 minute et 6 secondes et a créé un nouveau dossier .sda-cache. Franchement, c’est plutôt lent pour SDA. La conversion du fichier CSV de Windows-1252 vers UTF-8 a pris la majeure partie de ce temps. Le chargement peut être beaucoup plus rapide quand les données sont déjà en UTF-8. Sur le même M4 Max, j’ai chargé un milliard de lignes en environ huit secondes pour le défi du milliard de lignes 😱. Si vous ne l’avez pas encore relevé, essayez-le après ce projet.
Enregistrez main.ts de nouveau sans modifier le code à l’intérieur de cache (COMMAND + S sur Mac ou CTRL + S sur Windows). SDA chargera les données directement depuis .sda-cache. Sur mon ordinateur, l’exécution complète avec le cache n’a pris que 155 millisecondes. C’est environ 424 fois plus rapide que la première exécution, qui a pris 1 minute, 5 secondes et 697 millisecondes. Voilà toute la beauté du cache ! ⚡
Pour vider tout le cache, exécutez npm run clean. Cette commande supprime .sda-cache et .tmp. Vous pouvez aussi supprimer ces dossiers manuellement.
Il est temps de charger les données du recensement pour l’ensemble des provinces et territoires. Regardez les noms des fichiers CSV : ils suivent tous le modèle 98-401-X2021006_English_CSV_data_[region].csv.
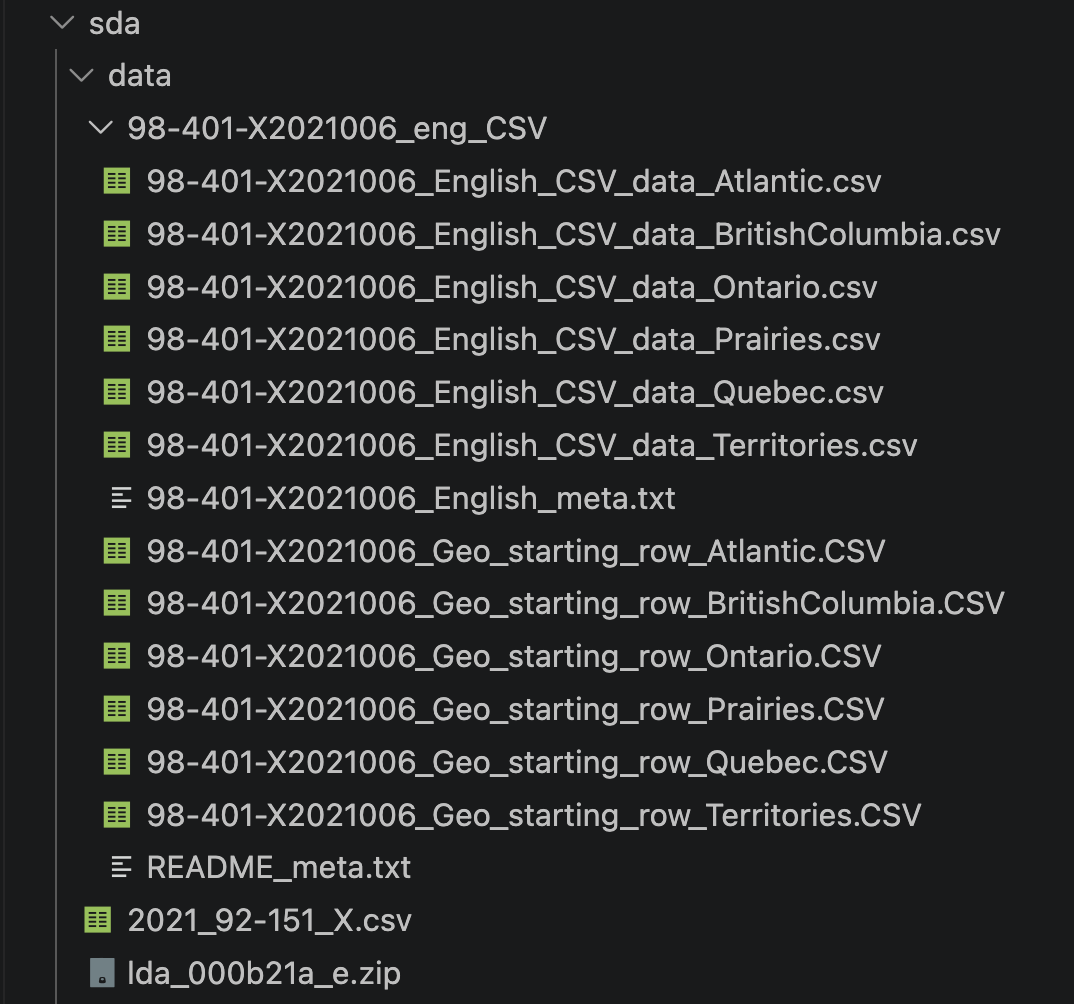
Nous pouvons remplacer Atlantic par le caractère générique * dans le chemin. SDA chargera 98-401-X2021006_English_CSV_data_Atlantic.csv, 98-401-X2021006_English_CSV_data_BritishColumbia.csv et tous les autres fichiers CSV dont le chemin suit le même modèle. Ils seront tous chargés directement dans la table census. Très pratique ! 🎉
⚠️ Le code ci-dessous chargera des millions et des millions de lignes. Selon la puissance de votre ordinateur, cela pourrait prendre longtemps. Mettez le code à jour, enregistrez main.ts et soyez patients.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ cacheVerbose: true });

const census = sdb.newTable("census");
await census.cache(() => {
  census.loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
    {
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  );
});
await census.log();

await sdb.close();
Sur mon ordinateur, ce premier chargement a pris environ 13 minutes. La majeure partie de ce temps a servi à convertir les données de Windows-1252 en UTF-8, plutôt qu’à lire les fichiers CSV. Le résultat est maintenant en cache. Je n’aurai donc plus à attendre aussi longtemps lorsque je relancerai le même code. Notre table contient maintenant plus de 152 millions de lignes ! 🤭
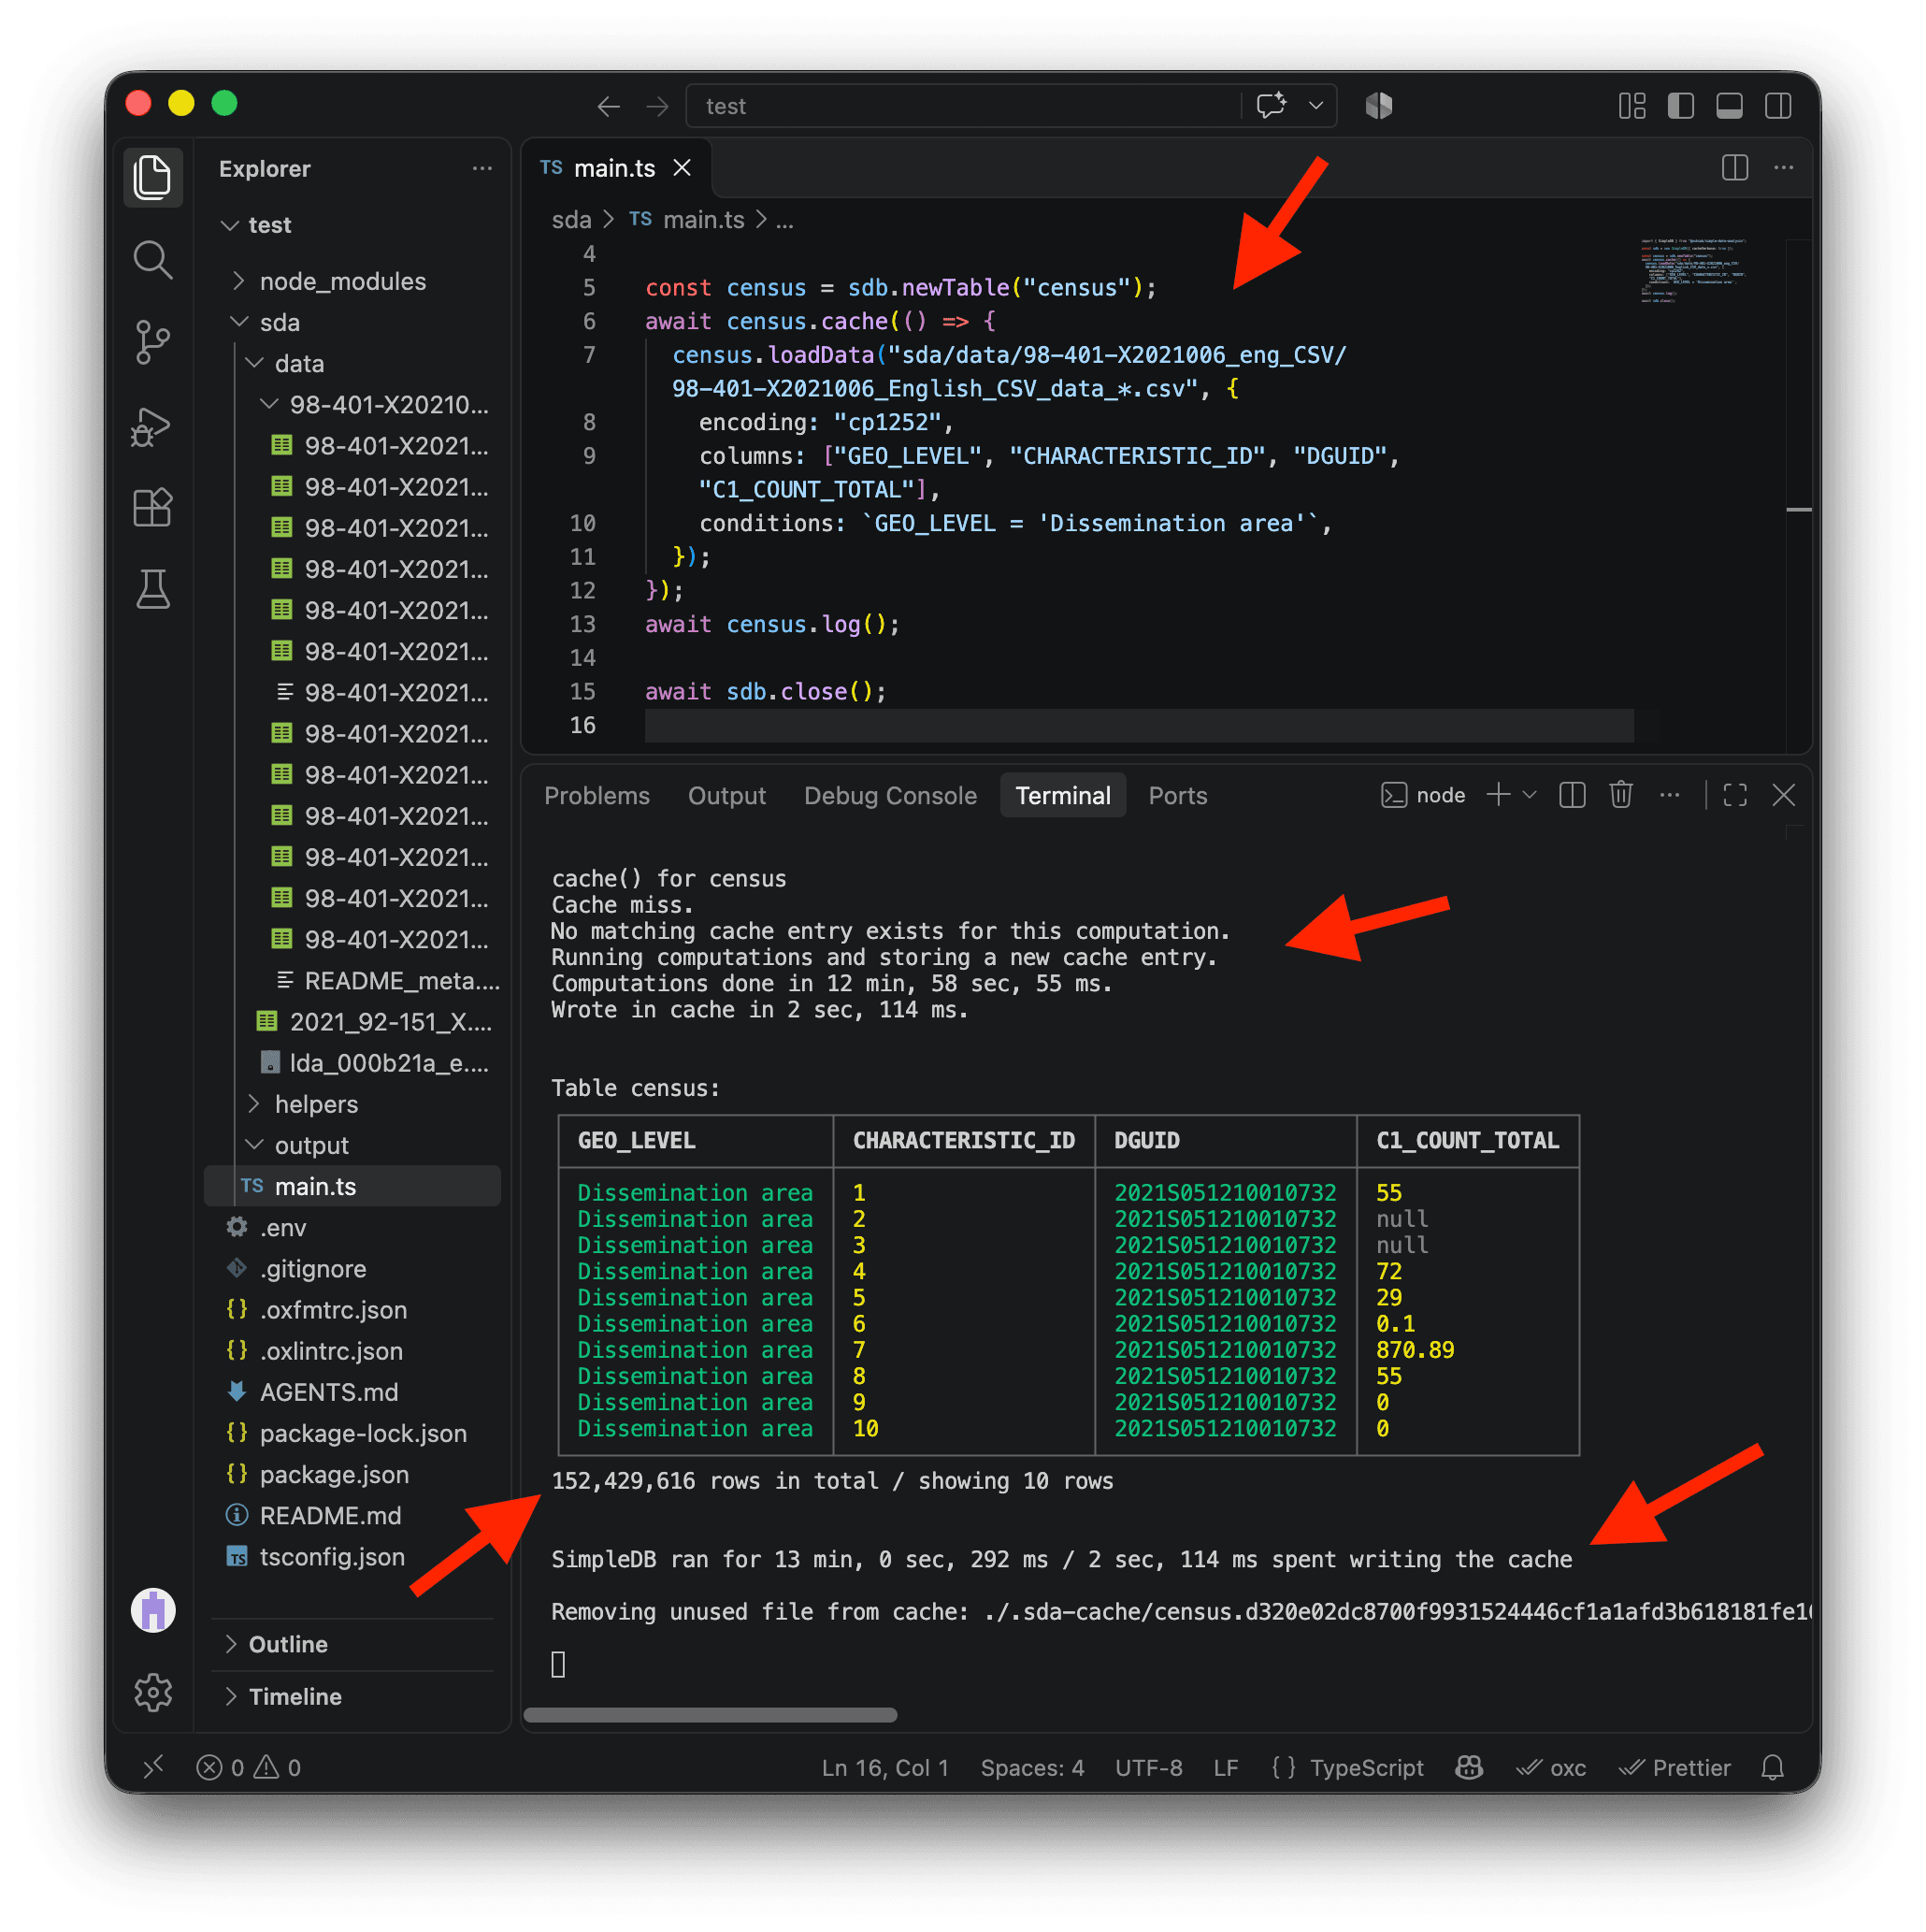
Selon la mémoire vive de votre ordinateur, un dossier .tmp peut apparaître dans votre projet. Si les données dépassent la mémoire disponible, SDA utilise ce dossier pour stocker des morceaux traités pendant son travail. Ce dossier peut devenir assez volumineux. Vous pouvez supprimer .tmp manuellement, même si je ne m’en préoccupe généralement pas. La commande npm run clean le supprimera aussi, mais attention : elle effacera également toutes les données en cache dans .sda-cache.
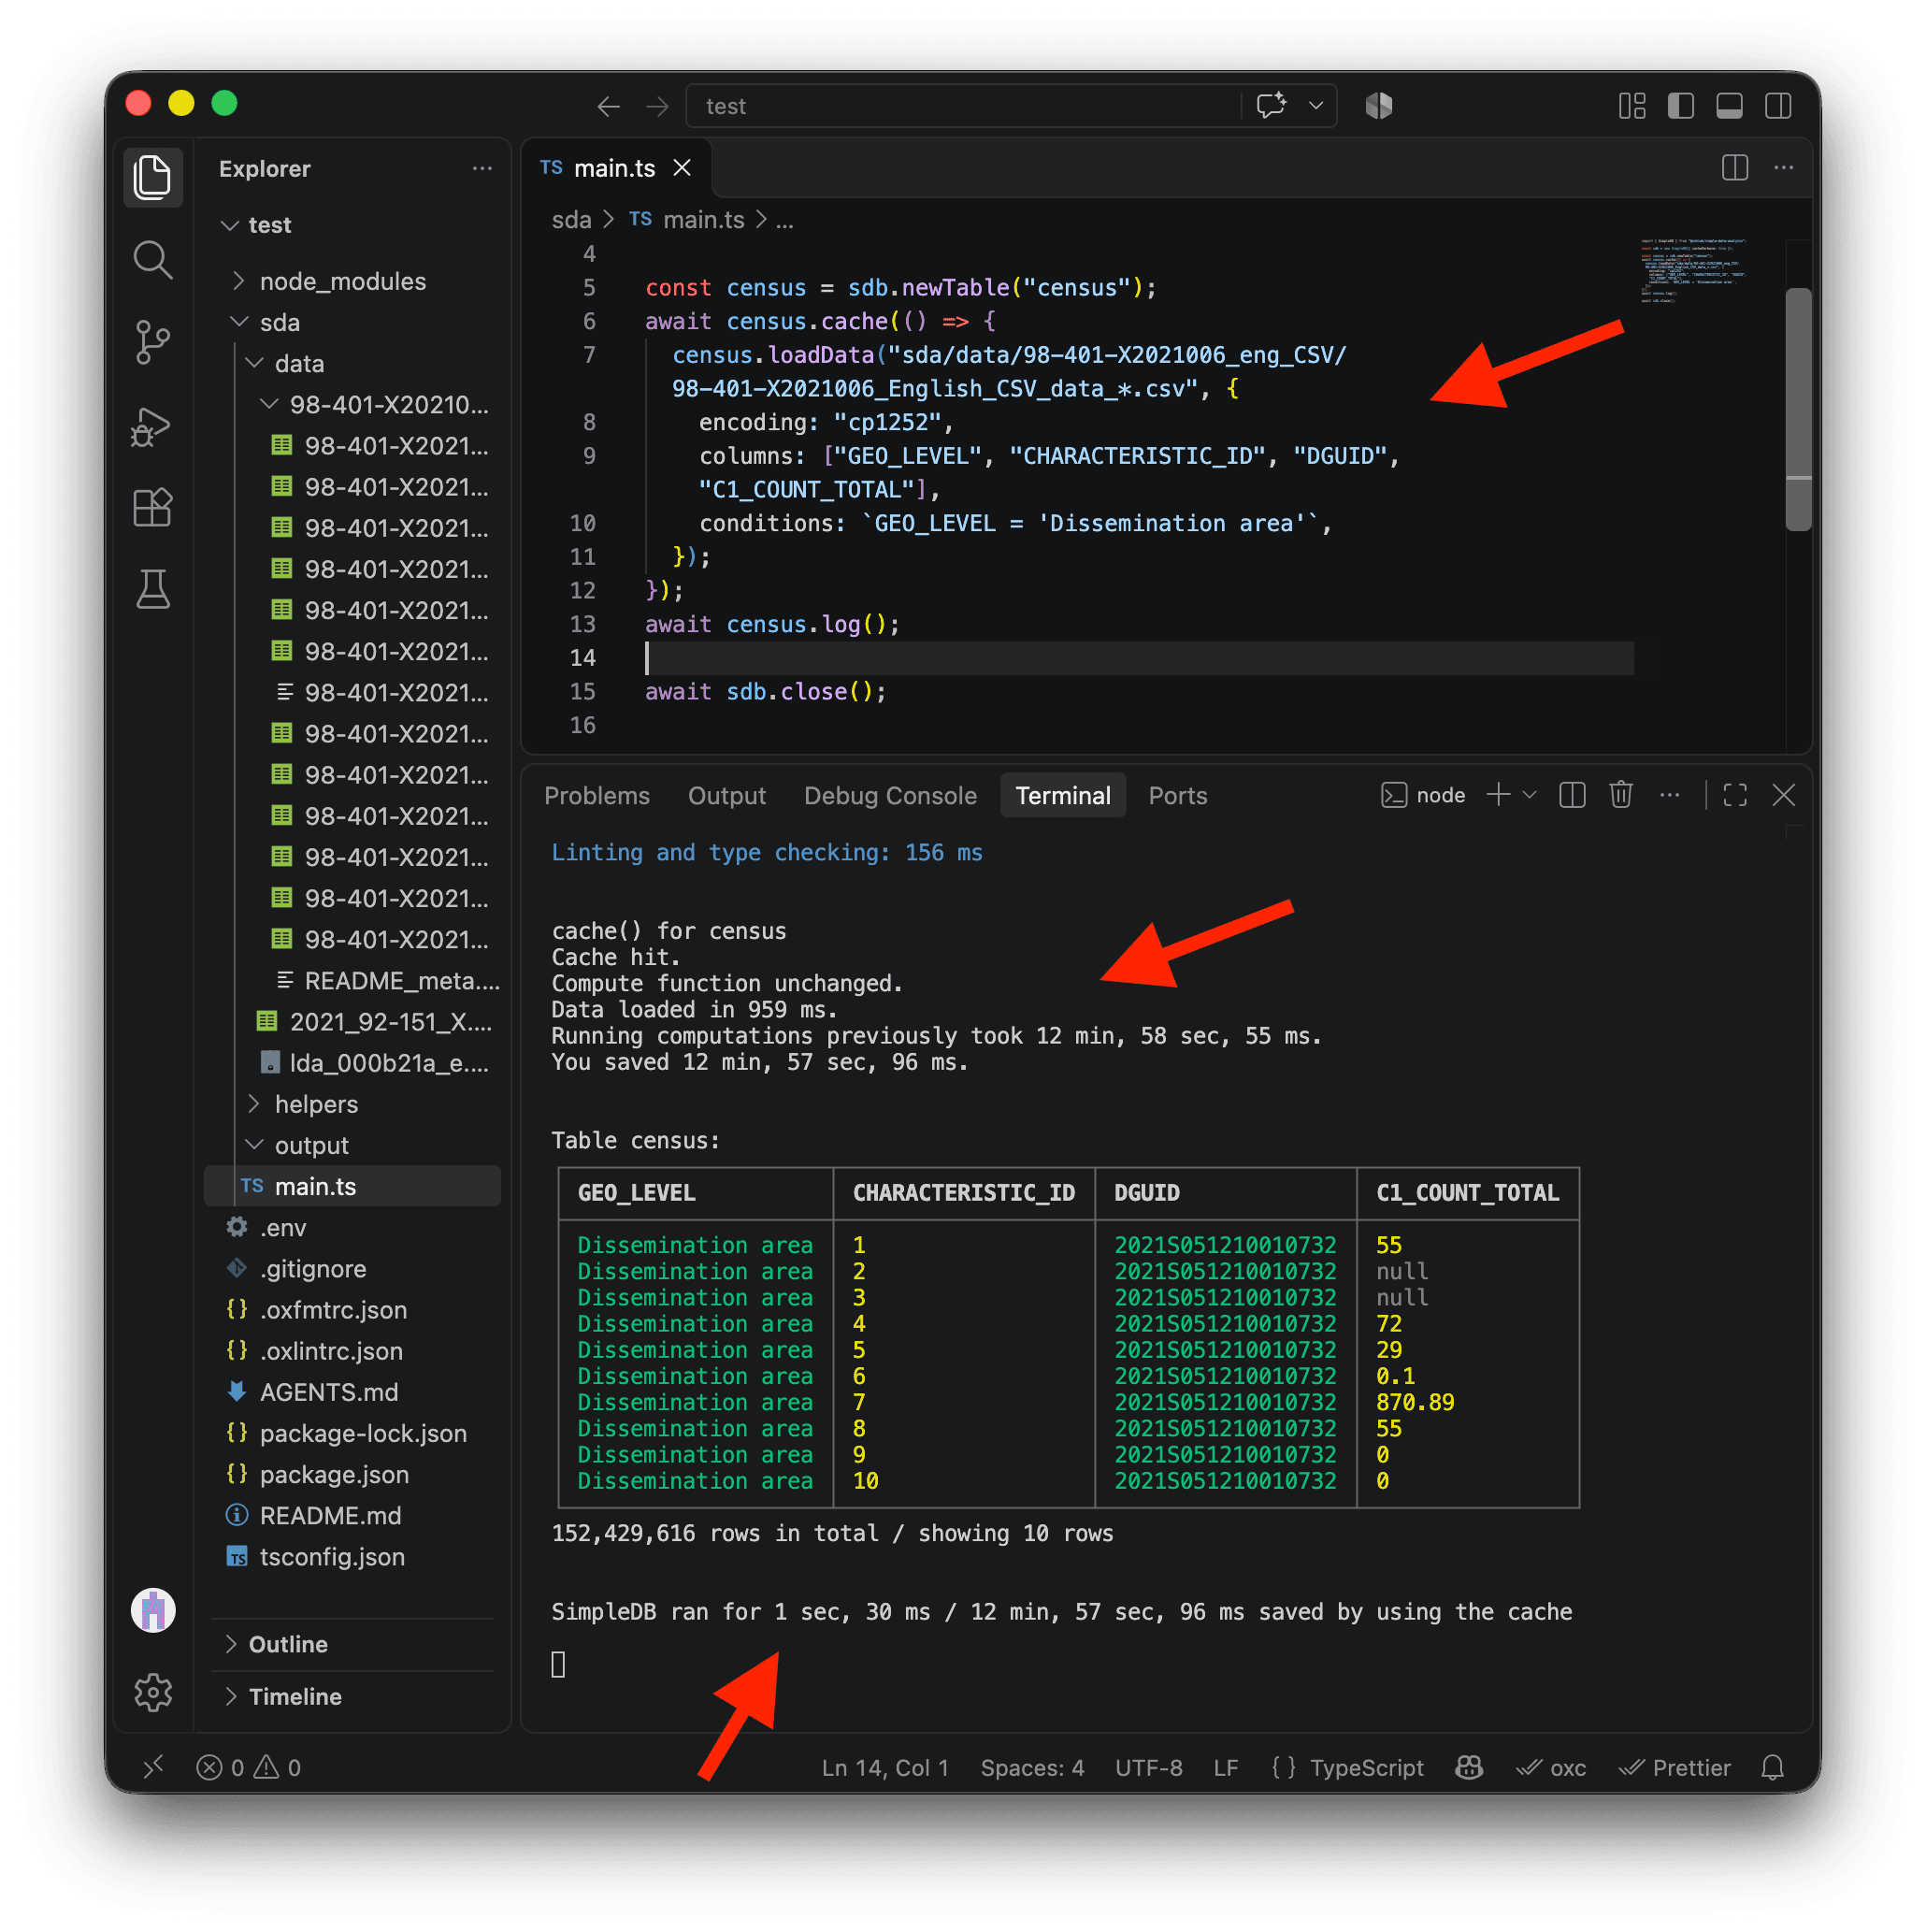
Enregistrez main.ts de nouveau ou relancez le script sans modifier le code à l’intérieur de cache. Sur mon ordinateur, l’exécution complète avec le cache a pris seulement 1 seconde et 30 millisecondes, soit environ 758 fois plus vite qu’au premier lancement. Une vitesse incroyable ! 😎
Filtrer les variables du recensement
Rafraîchissons-nous la mémoire. Notre question est la suivante :
- Pour chaque région métropolitaine canadienne, quelles aires de diffusion ont un revenu des ménages supérieur ou inférieur à la médiane ?
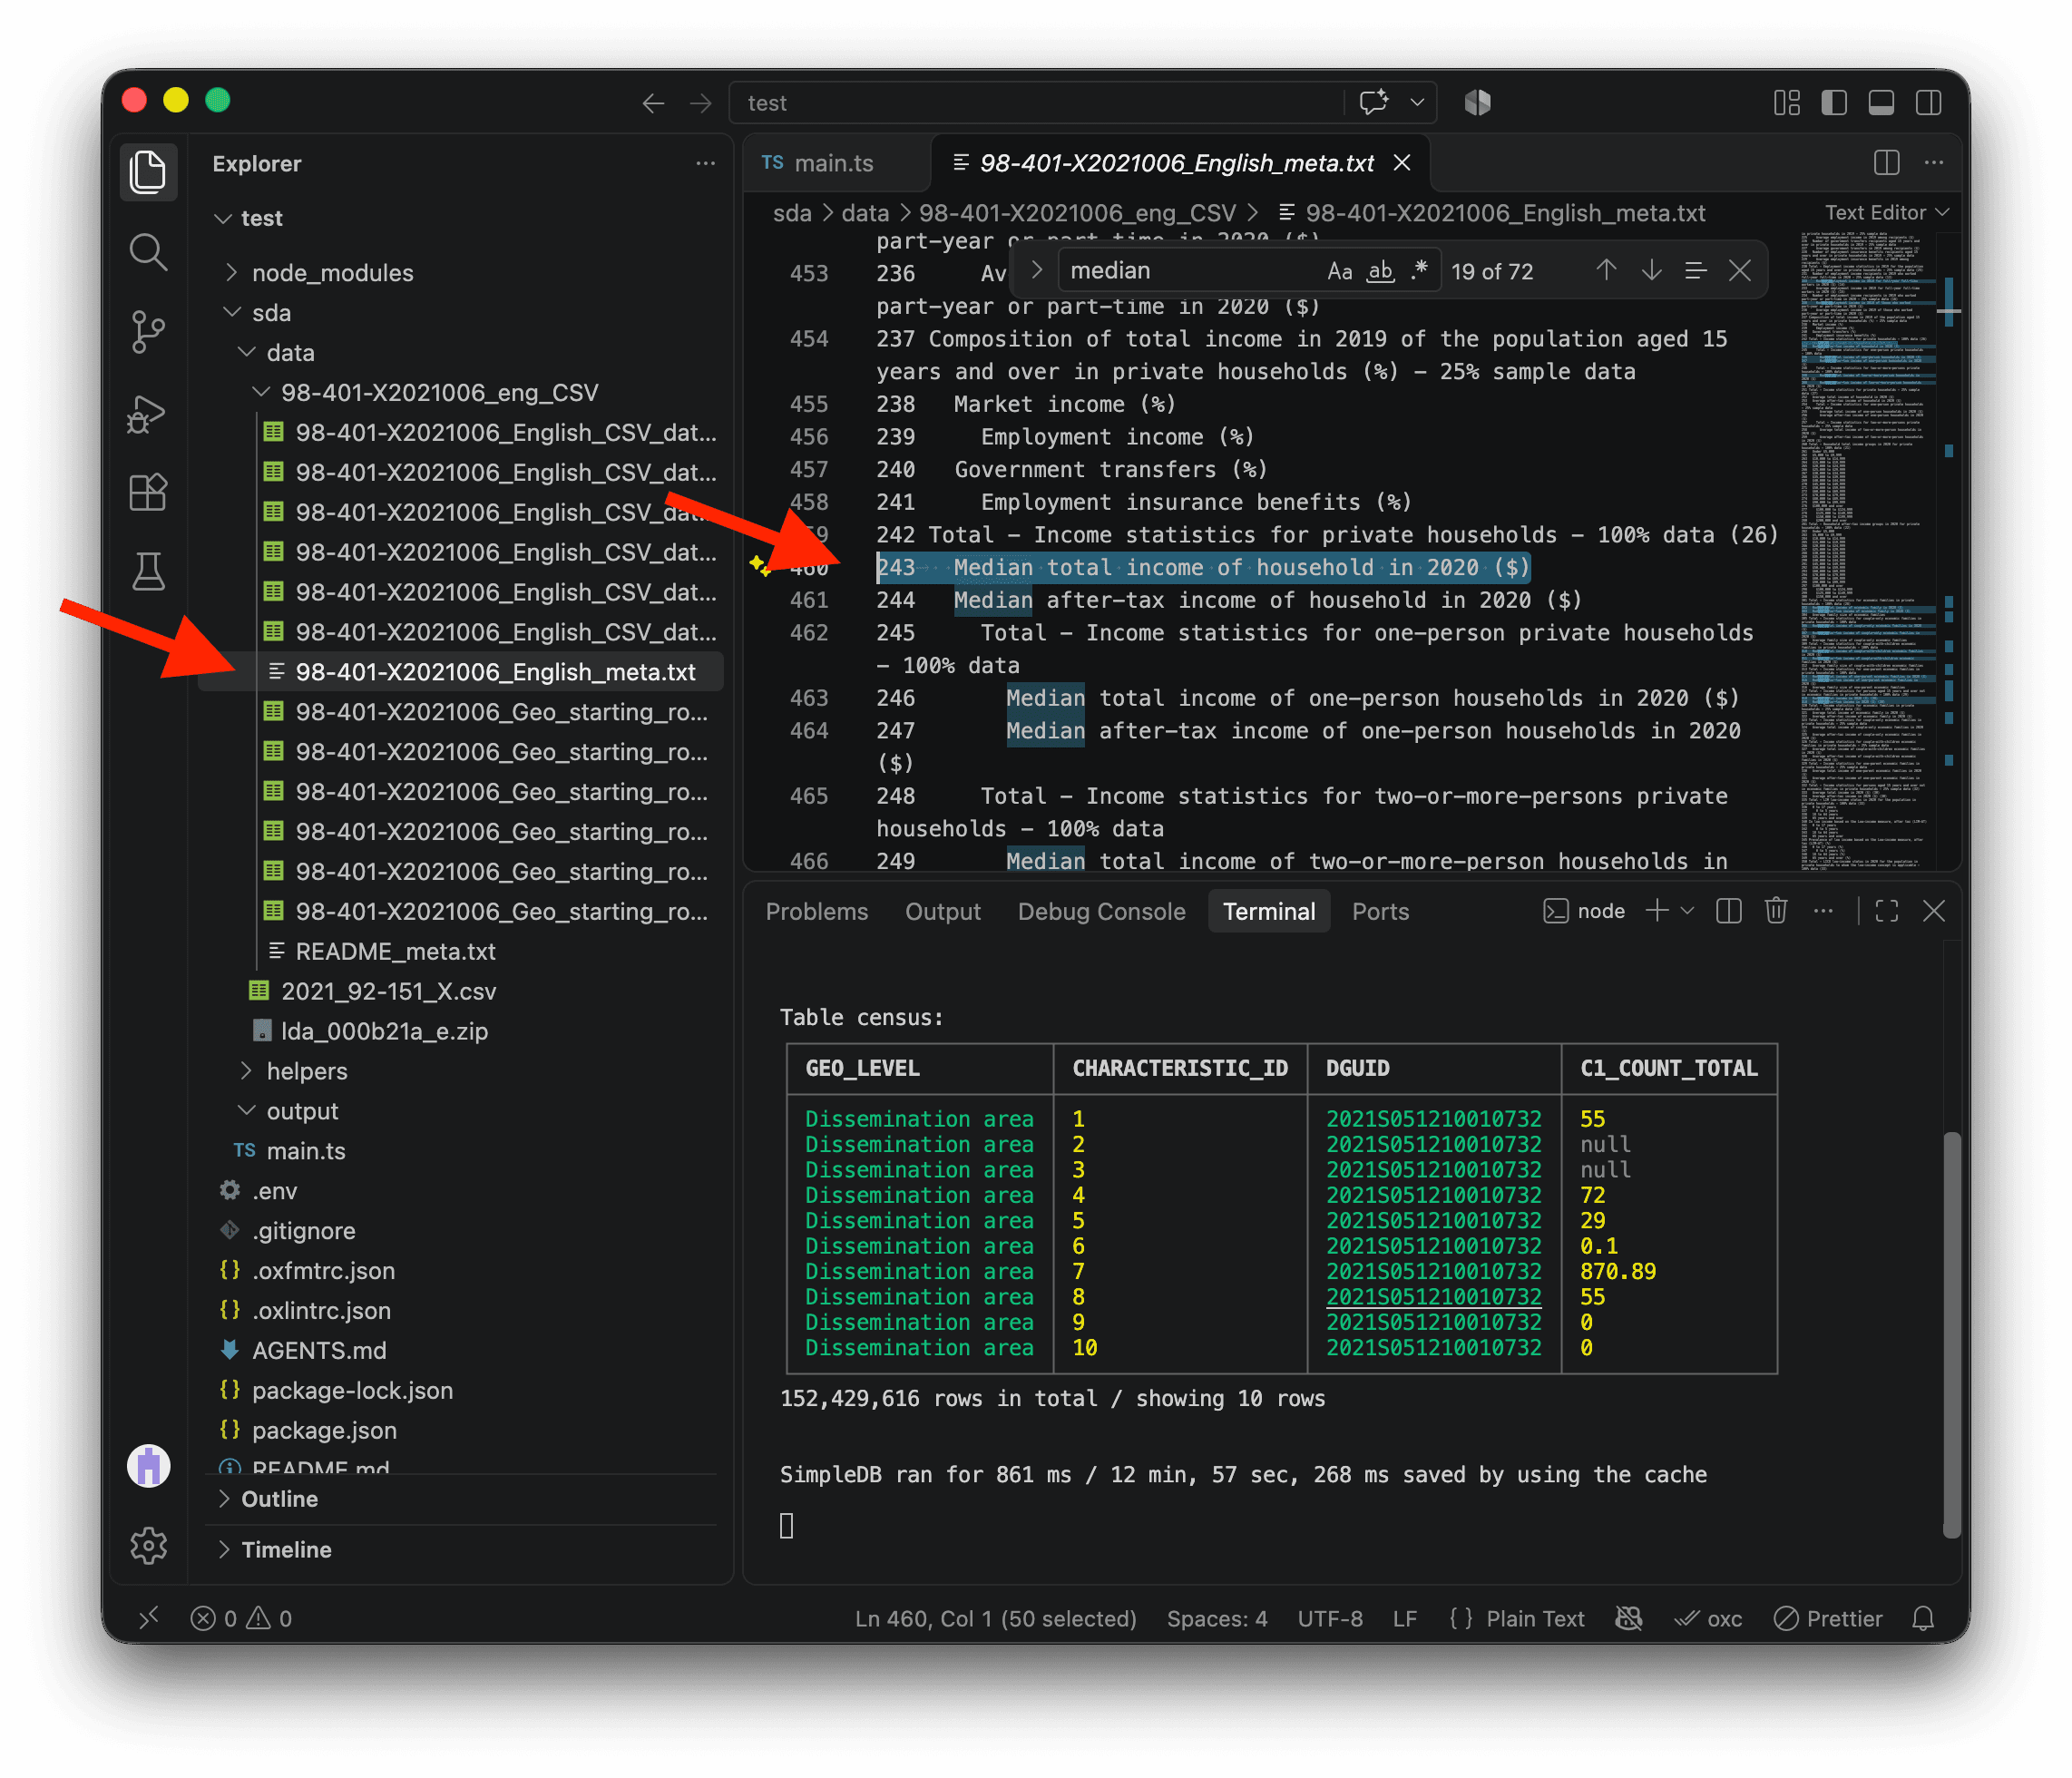
Pour trouver la variable du revenu total des ménages, ouvrez 98-401-X2021006_English_meta.txt dans le dossier des données du recensement. Ce fichier répertorie toutes les variables et indique que CHARACTERISTIC_ID vaut 243 pour Median total income of household in 2020 ($).
Dans la capture d’écran ci-dessous, j’ai utilisé la recherche pour le trouver rapidement (COMMAND + F sur Mac ou CTRL + F sur Windows).
Nous pouvons utiliser keepValues pour ne sélectionner que les lignes où CHARACTERISTIC_ID vaut 243.
⚠️ Ajoutez bien keepValues après la méthode cache, comme ci-dessous. Si vous modifiez le code à l’intérieur de cache, SDA réexécutera tout le bloc et rechargera les données d’origine. Une fois les 152 millions de lignes chargées depuis le cache, SDA les réduit très vite à environ 57 000 lignes. Nous n’avons donc pas besoin de mettre cette étape en cache.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ cacheVerbose: true });

const census = sdb.newTable("census");
await census.cache(() => {
  census.loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
    {
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  );
});
await census
  .keepValues({ CHARACTERISTIC_ID: 243 })
  .log();

await sdb.close();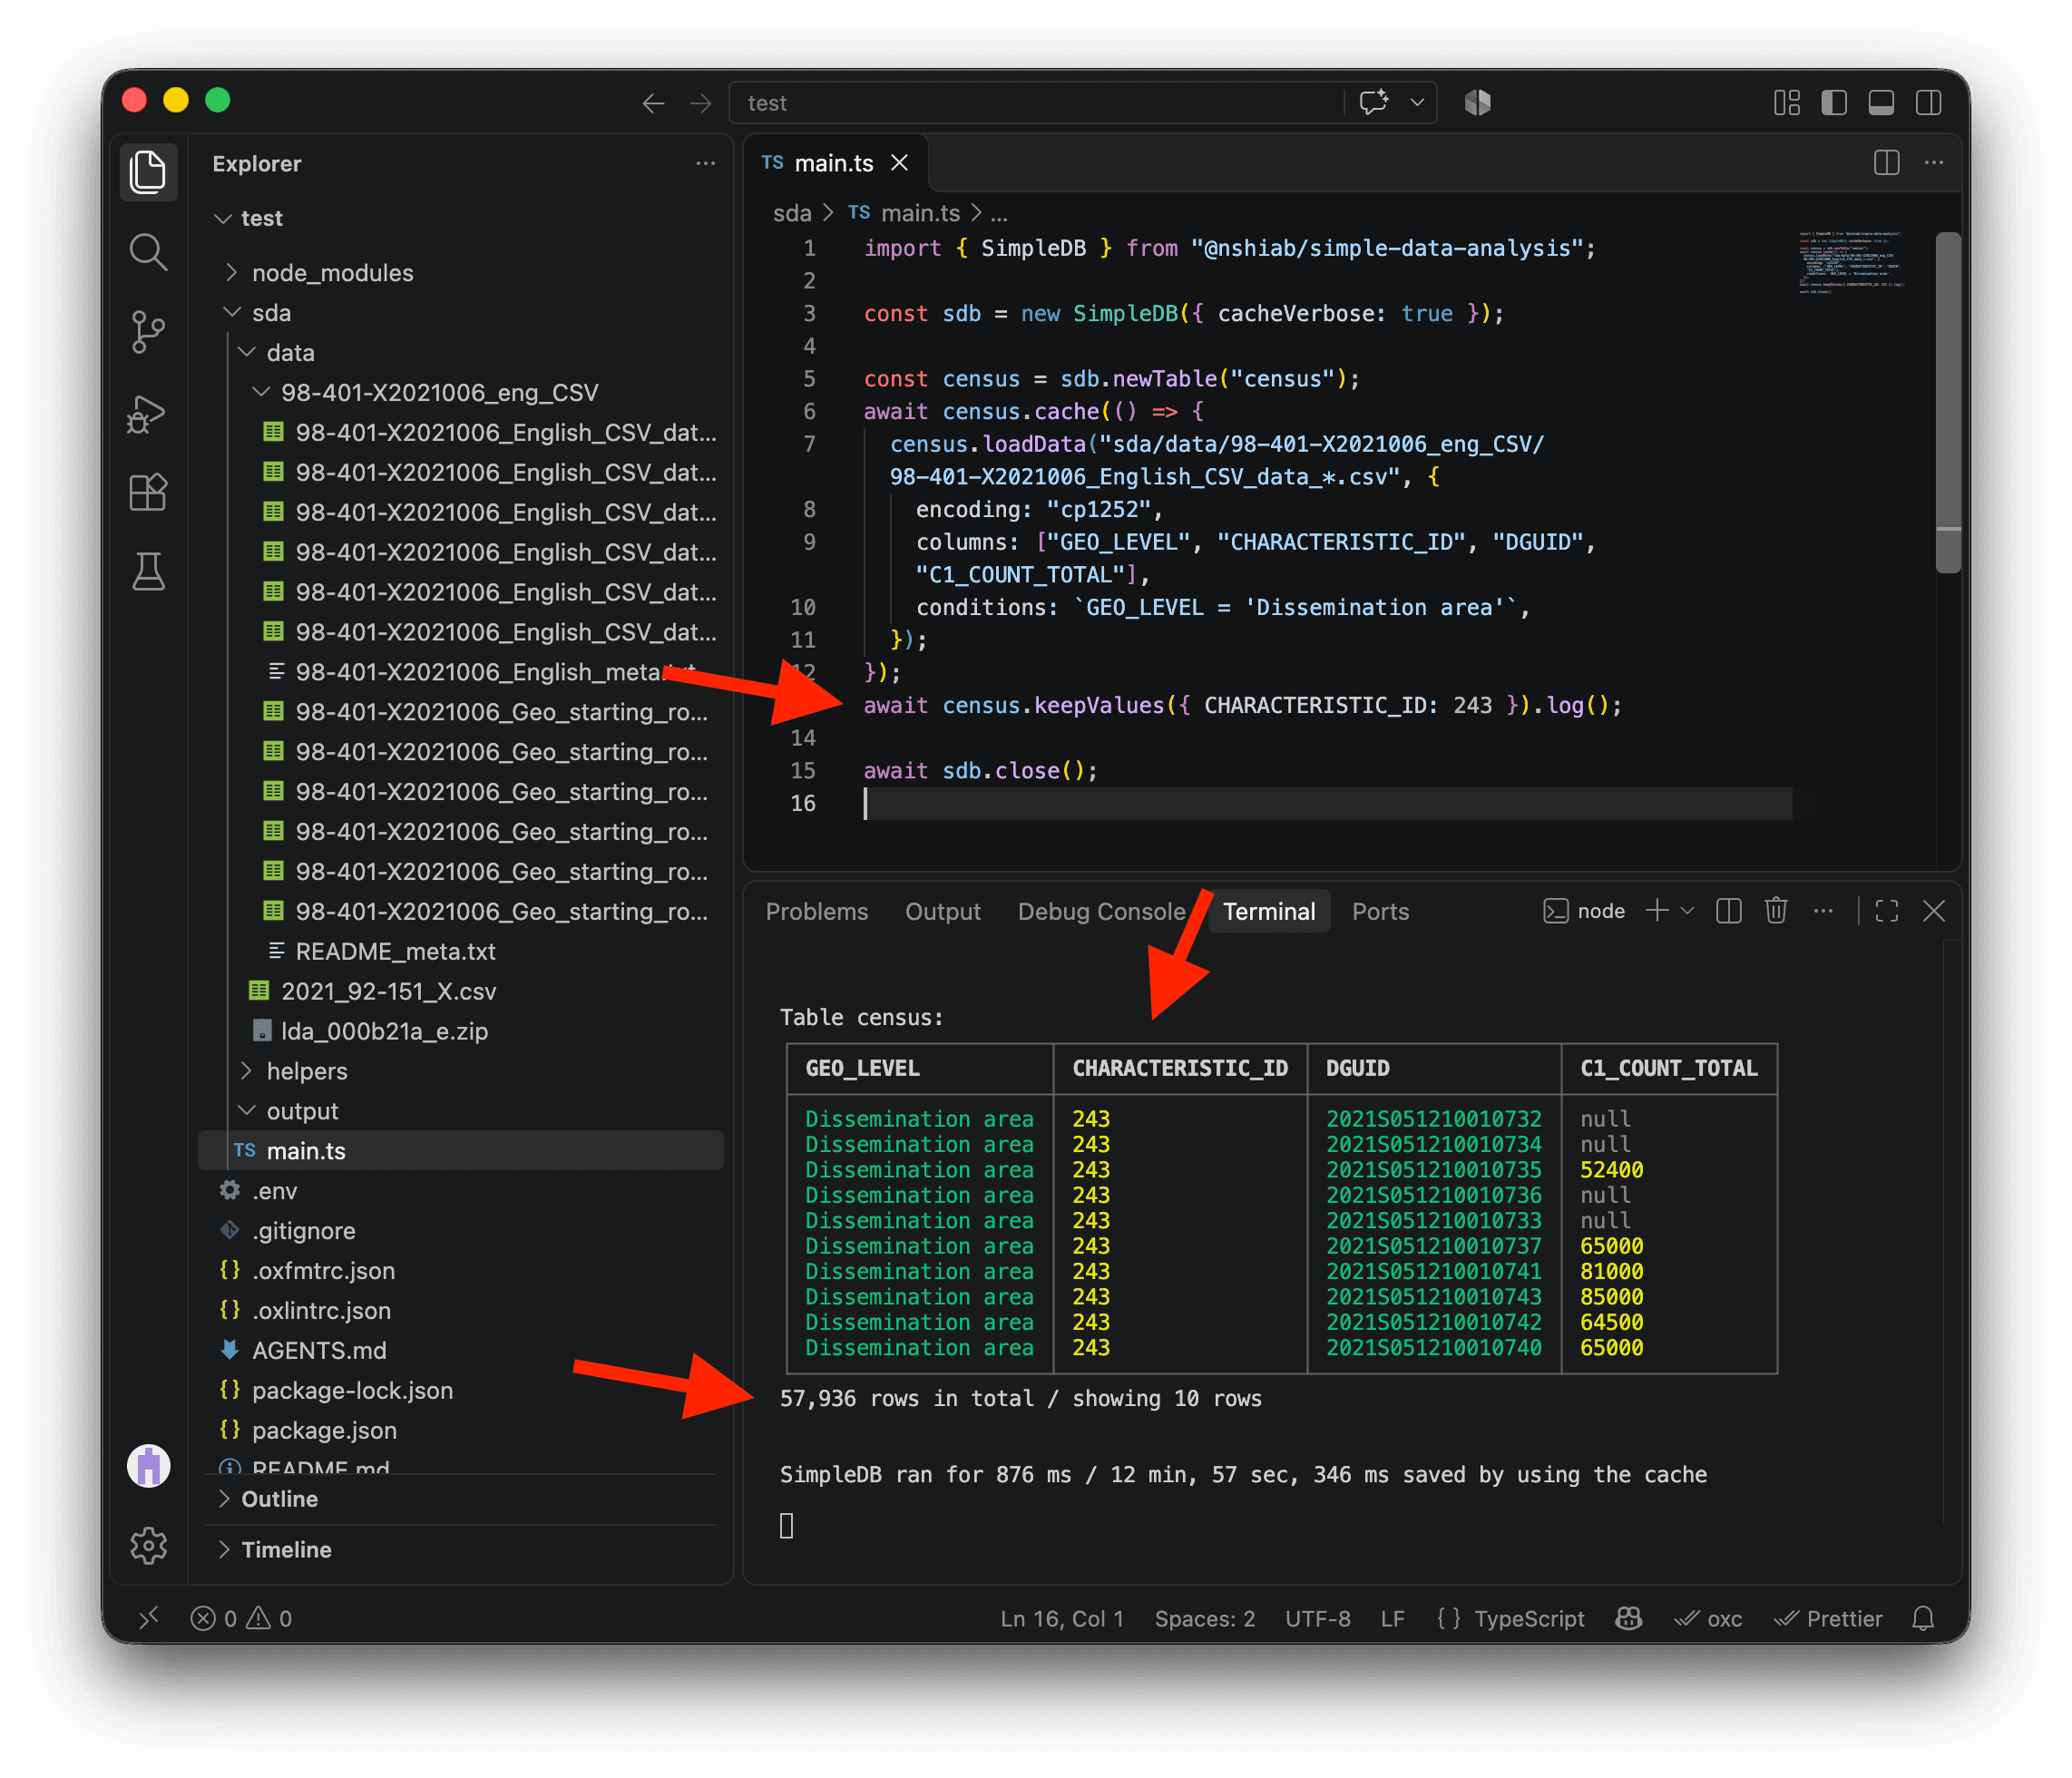
Ça se présente bien ! Nous avons le revenu médian pour chaque aire de diffusion. Il nous reste à ajouter le nom des régions métropolitaines.
Les régions métropolitaines
Pour obtenir le nom des régions métropolitaines, nous utiliserons le Fichier des attributs géographiques de 2021 téléchargé plus tôt, enregistré sous 2021_92-151_X.csv. Ce jeu de données contient beaucoup de colonnes, mais j’ai parcouru la documentation pour vous. Il ne nous en faut que deux :
DADGUID_ADIDUGD, un identifiant correspondant à celui des aires de diffusion dans les données du recensementCMANAME_RMRNOM, le nom de la région métropolitaine correspondante
Ce fichier utilise aussi l’encodage Windows-1252. Nous reprendrons donc les options encoding, columns et conditions pour ne charger que les données nécessaires. La condition conserve les régions métropolitaines, tandis que removeDuplicates produit des lignes uniques pour les prochaines étapes. Avec renameColumns, l’identifiant des aires de diffusion s’appelle DGUID dans la table census, qui contient les données du recensement, comme dans la table names, qui contient le nom des régions métropolitaines.
Nous mettrons aussi cette étape en cache. Le premier lancement prend quelques secondes, mais les suivants sont presque instantanés.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ cacheVerbose: true });

const census = sdb.newTable("census");
await census.cache(() => {
  census.loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
    {
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  );
});
await census
  .keepValues({ CHARACTERISTIC_ID: 243 })
  .log();

const names = sdb.newTable("names");
await names.cache(() => {
  names.loadData("sda/data/2021_92-151_X.csv", {
    encoding: "cp1252",
    columns: ["DADGUID_ADIDUGD", "CMANAME_RMRNOM"],
    conditions: `CMATYPE_RMRGENRE = 'B'`,
  })
    .removeDuplicates()
    .renameColumns({
      DADGUID_ADIDUGD: "DGUID",
    });
});
await names.log();

await sdb.close();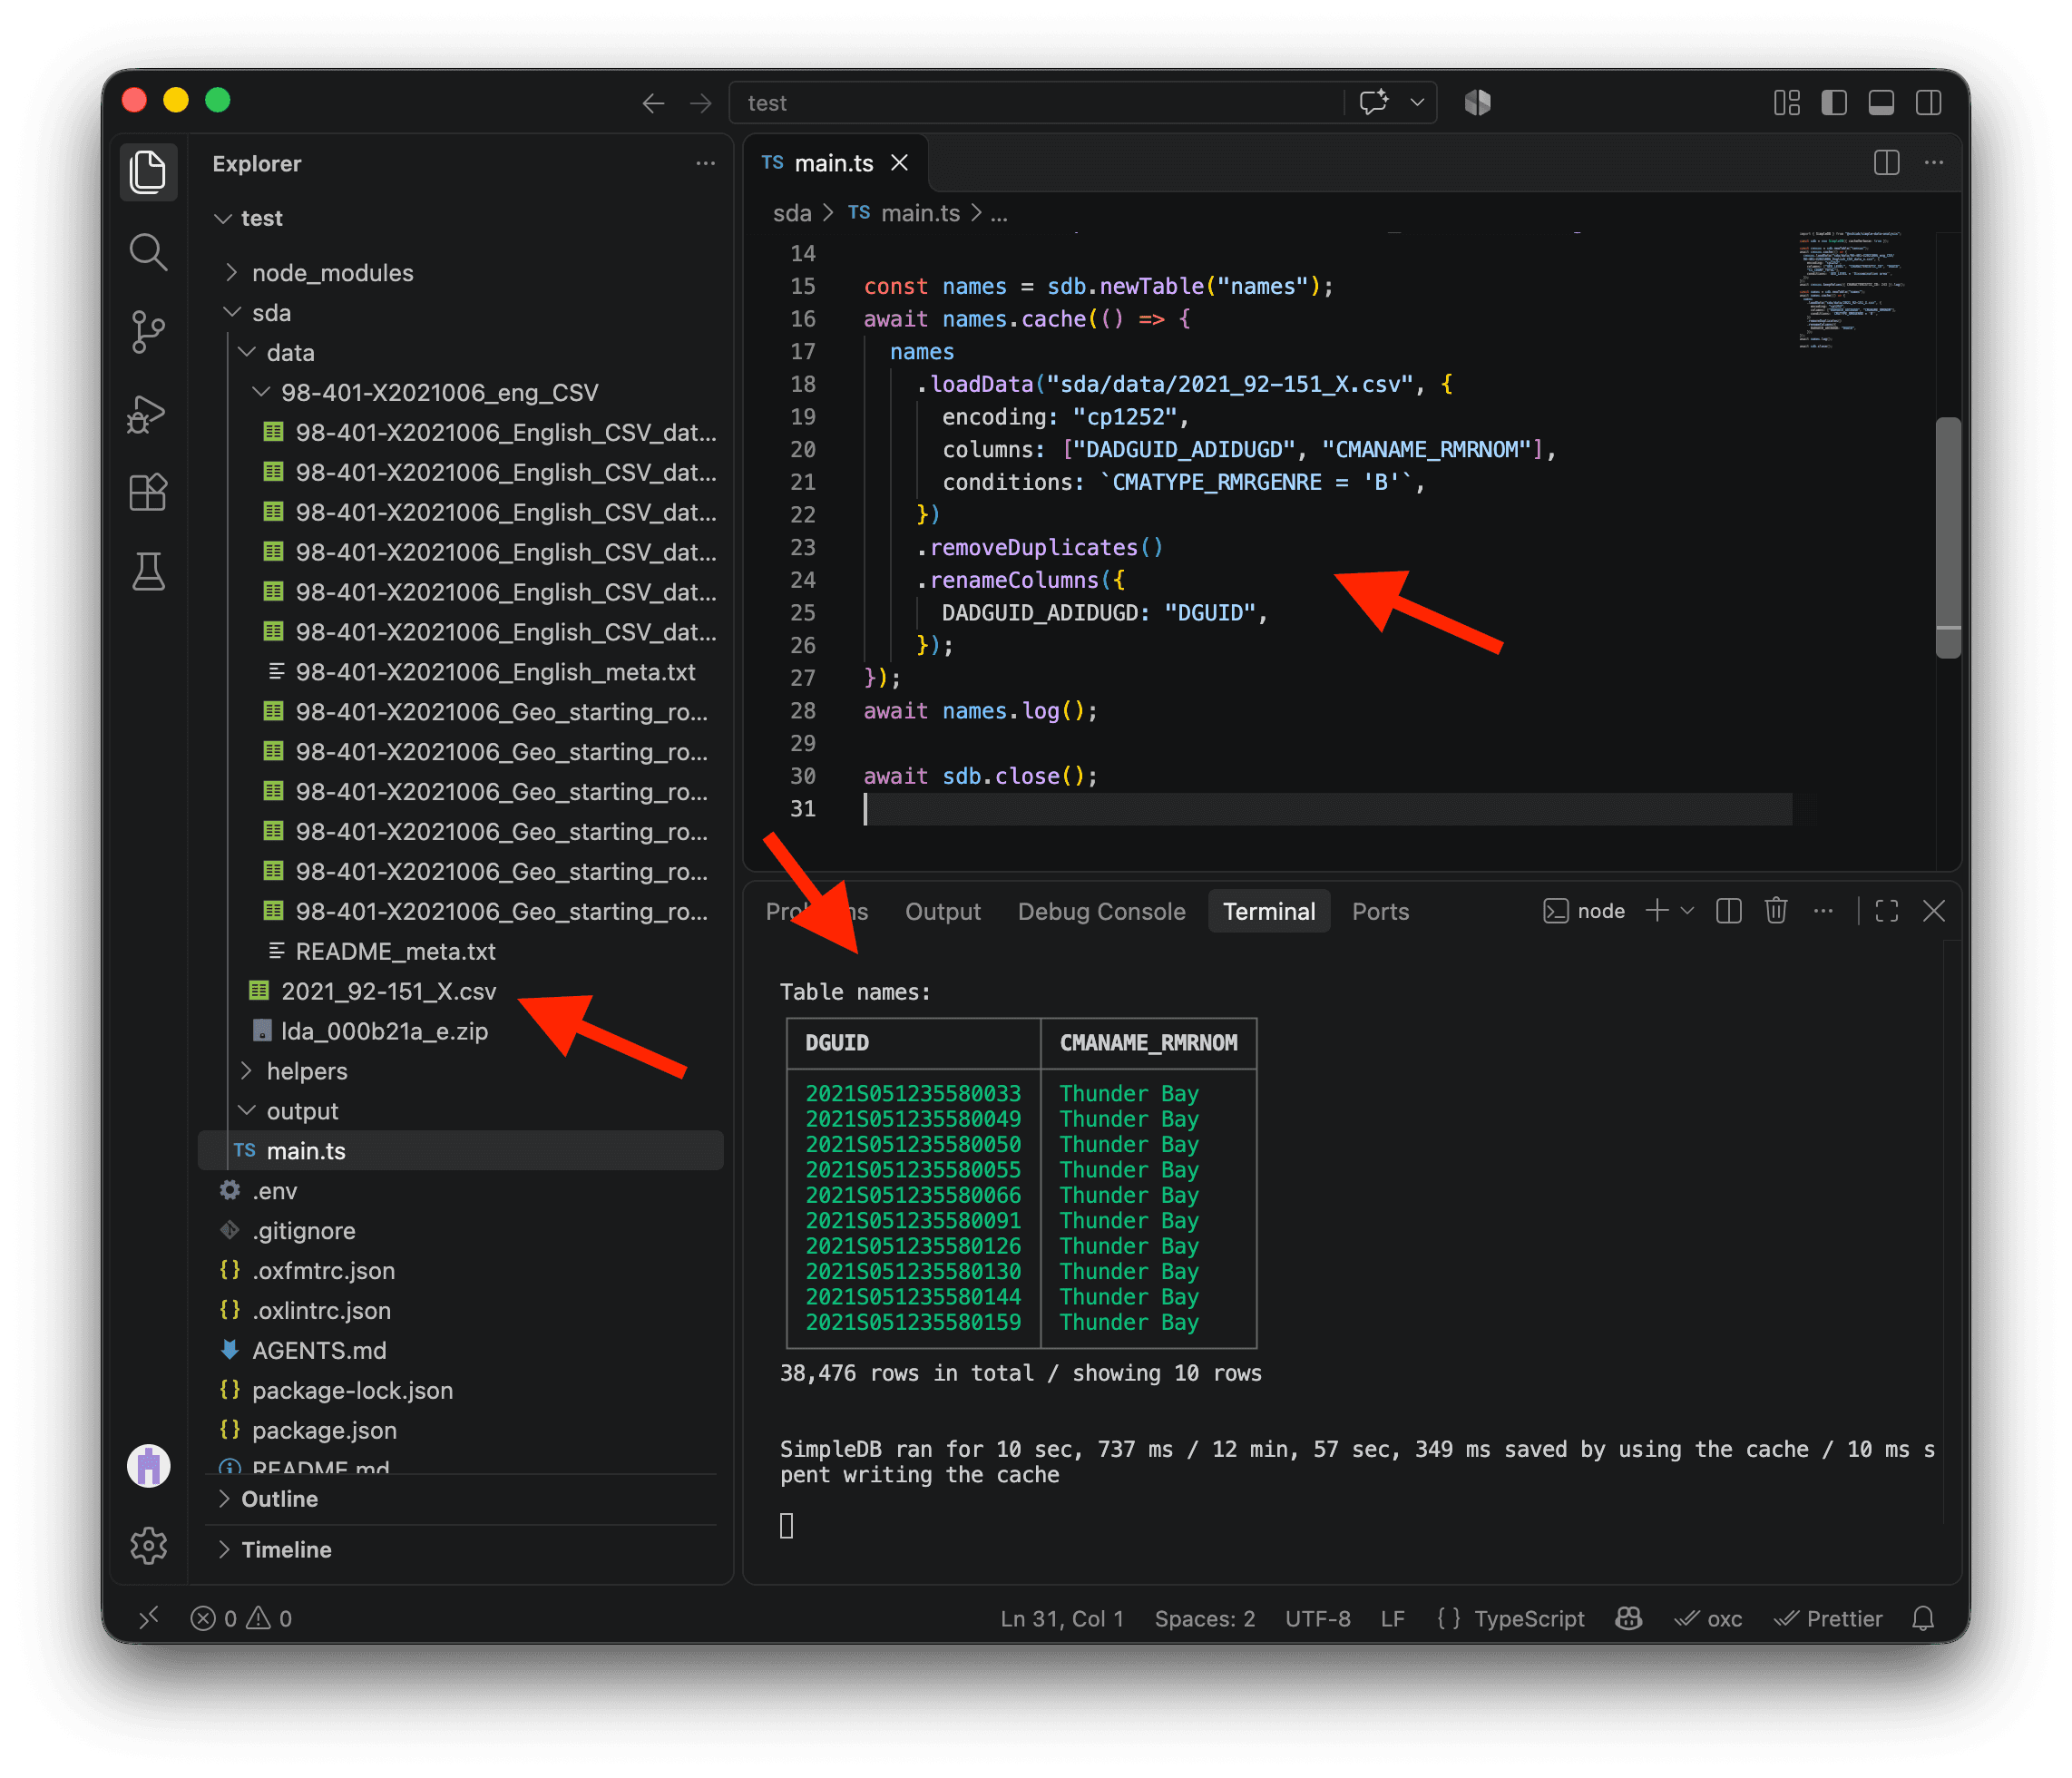
Vous avez peut-être remarqué que la table names compte environ 38 000 lignes, contre environ 57 000 pour census. C’est parce que les aires de diffusion n’appartiennent pas toutes à une région métropolitaine.
Il ne reste qu’à joindre la table census à la table names. La méthode join trouve automatiquement leur colonne commune DGUID et ajoute le bon nom de région métropolitaine à chaque aire de diffusion correspondante. Nos données du recensement et les noms des régions métropolitaines se trouvent maintenant dans la même table ! 🎉
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ cacheVerbose: true });

const census = sdb.newTable("census");
await census.cache(() => {
  census.loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
    {
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  );
});
await census
  .keepValues({ CHARACTERISTIC_ID: 243 })
  .log();

const names = sdb.newTable("names");
await names.cache(() => {
  names.loadData("sda/data/2021_92-151_X.csv", {
    encoding: "cp1252",
    columns: ["DADGUID_ADIDUGD", "CMANAME_RMRNOM"],
    conditions: `CMATYPE_RMRGENRE = 'B'`,
  })
    .removeDuplicates()
    .renameColumns({
      DADGUID_ADIDUGD: "DGUID",
    });
});
await names.log();

await census
  .join(names)
  .log();

await sdb.close();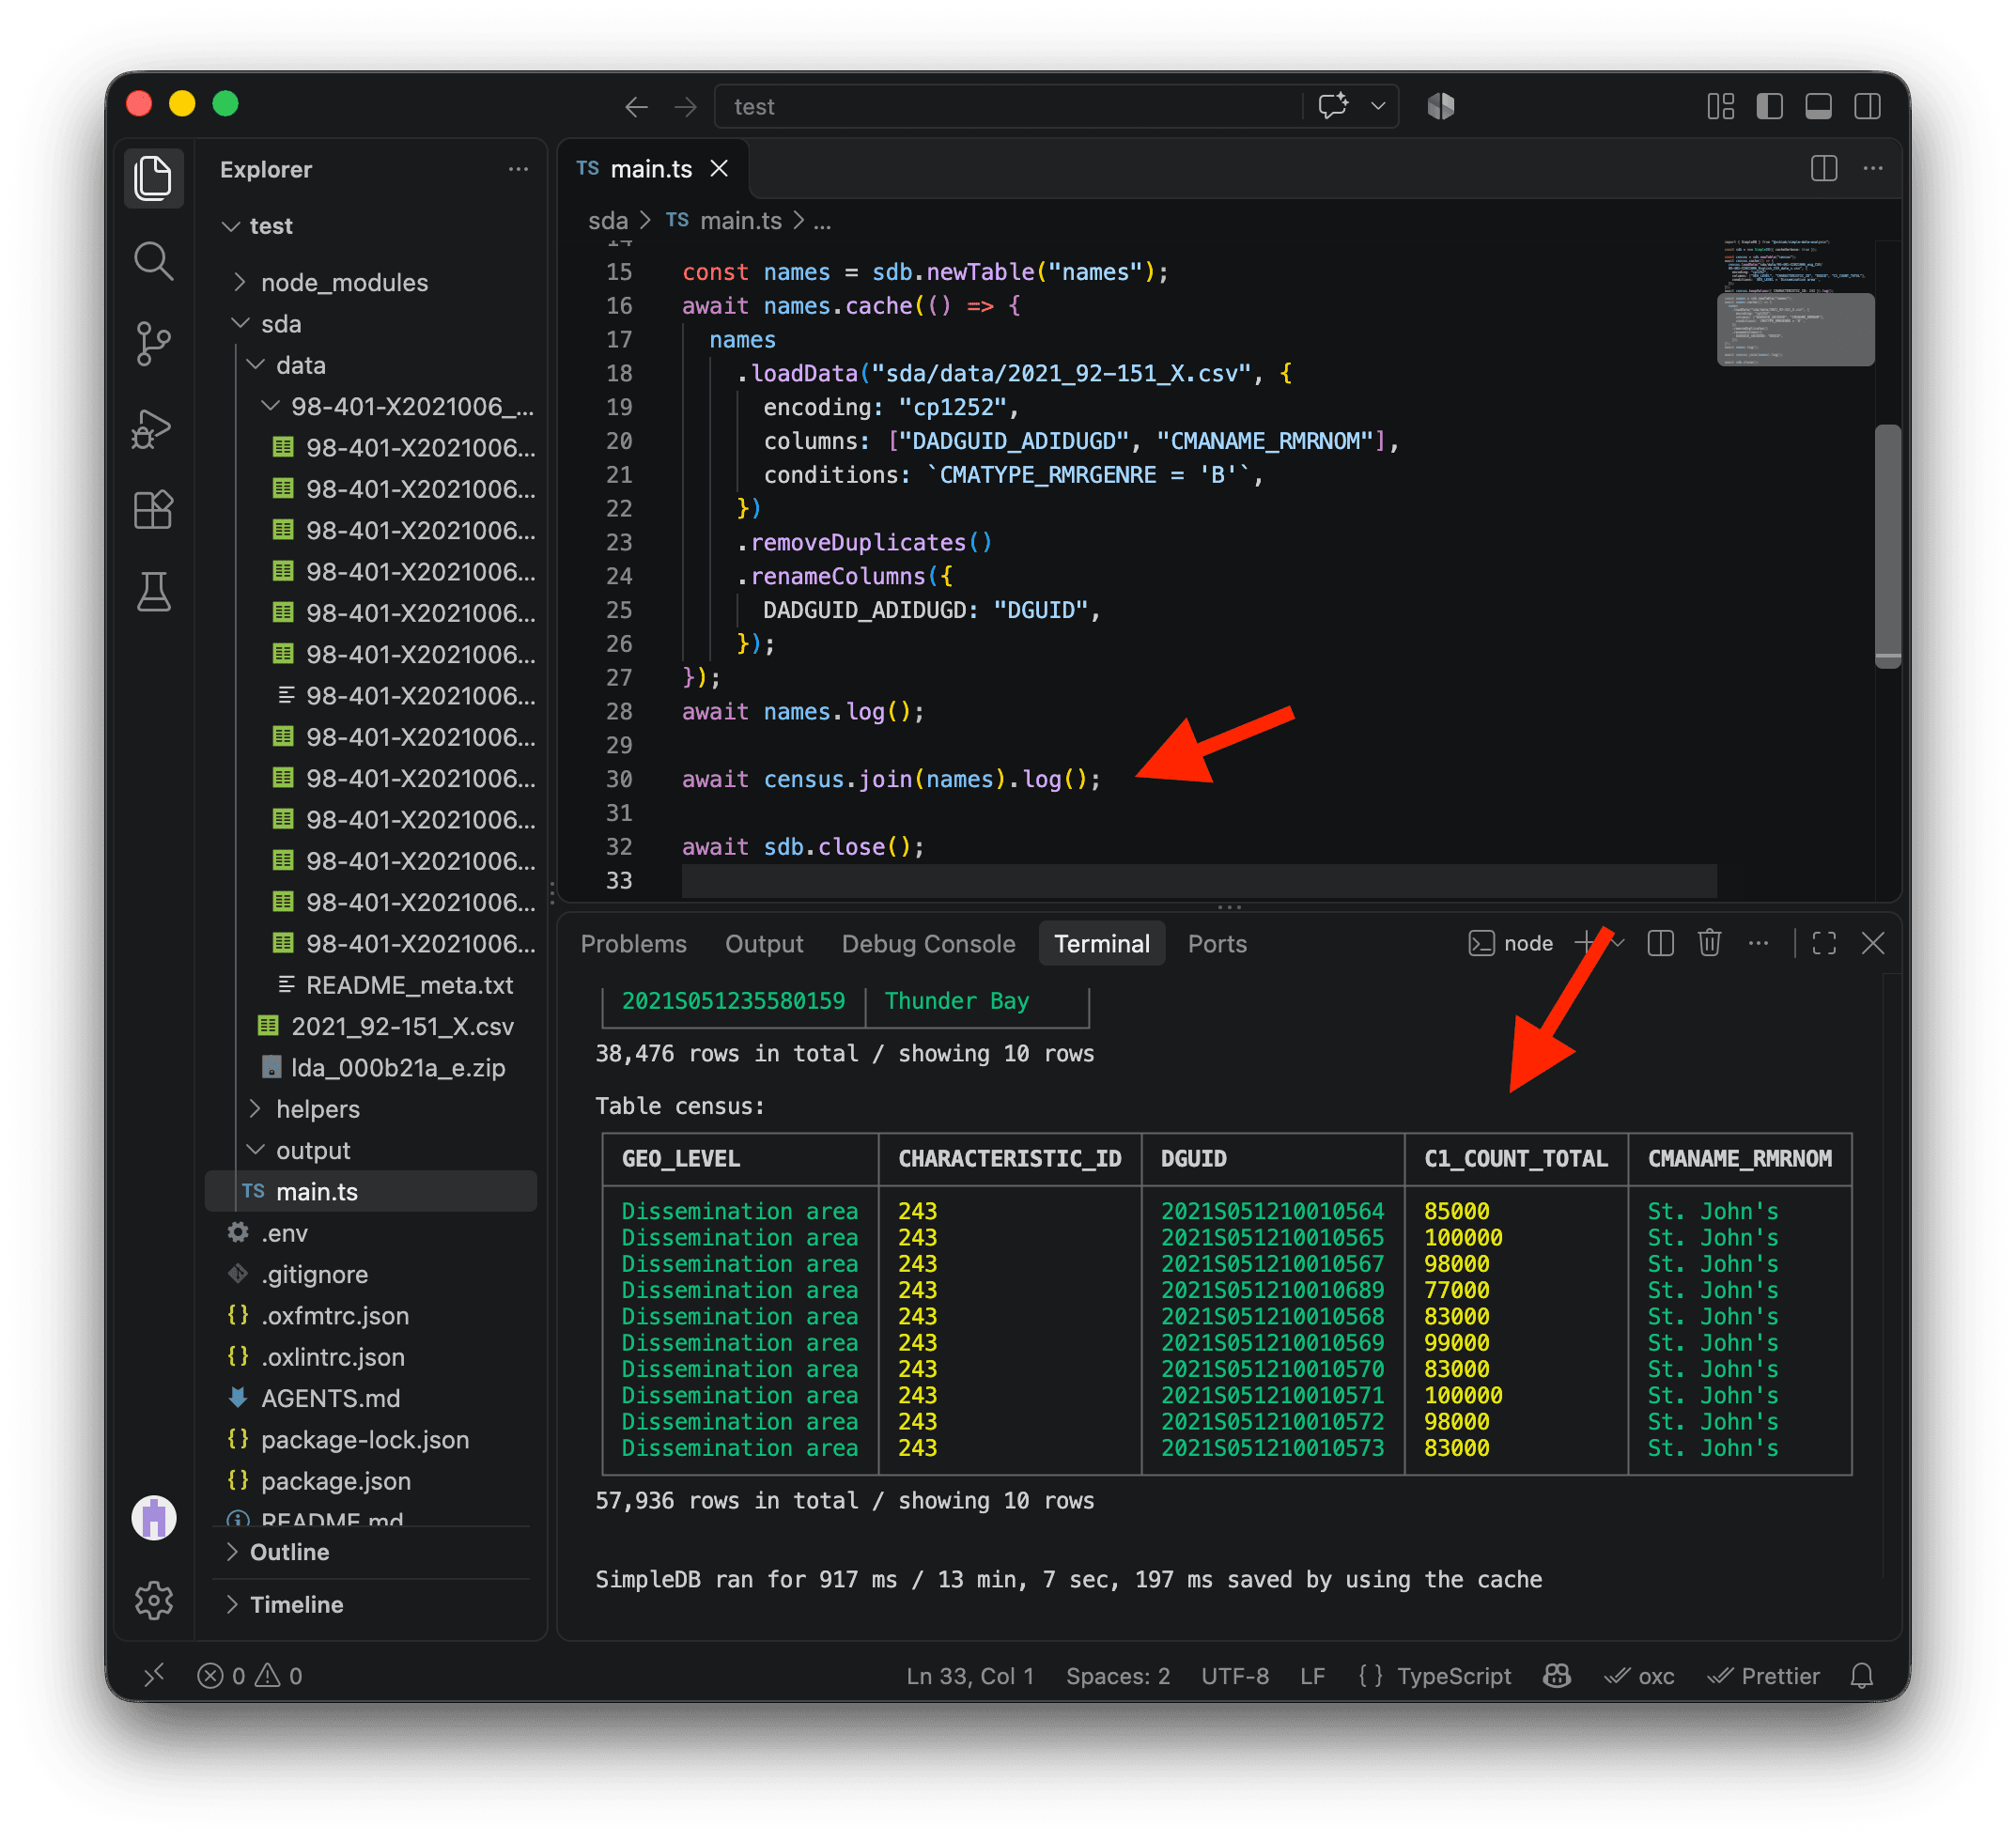
Simplifier les géométries
Pour créer une carte, nous avons besoin des frontières des aires de diffusion. Nous les avons téléchargées plus tôt dans le fichier ZIP lda_000b21a_e.zip (et je vous ai demandé de ne pas le décompresser 😬).
Statistique Canada fournit des données géospatiales très détaillées. Mais pour dessiner nos cartes, nous n’avons pas besoin d’autant de détails. Une version simplifiée suffira et accélérera l’exécution du code.
Un de mes outils préférés pour simplifier les données géospatiales est mapshaper.org . Si vous avez un compte, donnez-lui une ⭐ sur GitHub !
Ouvrez le site Web et glissez-déposez lda_000b21a_e.zip sur la page. Vous ne pouvez pas le faire depuis VS Code : utilisez plutôt Finder ou l’Explorateur de fichiers.
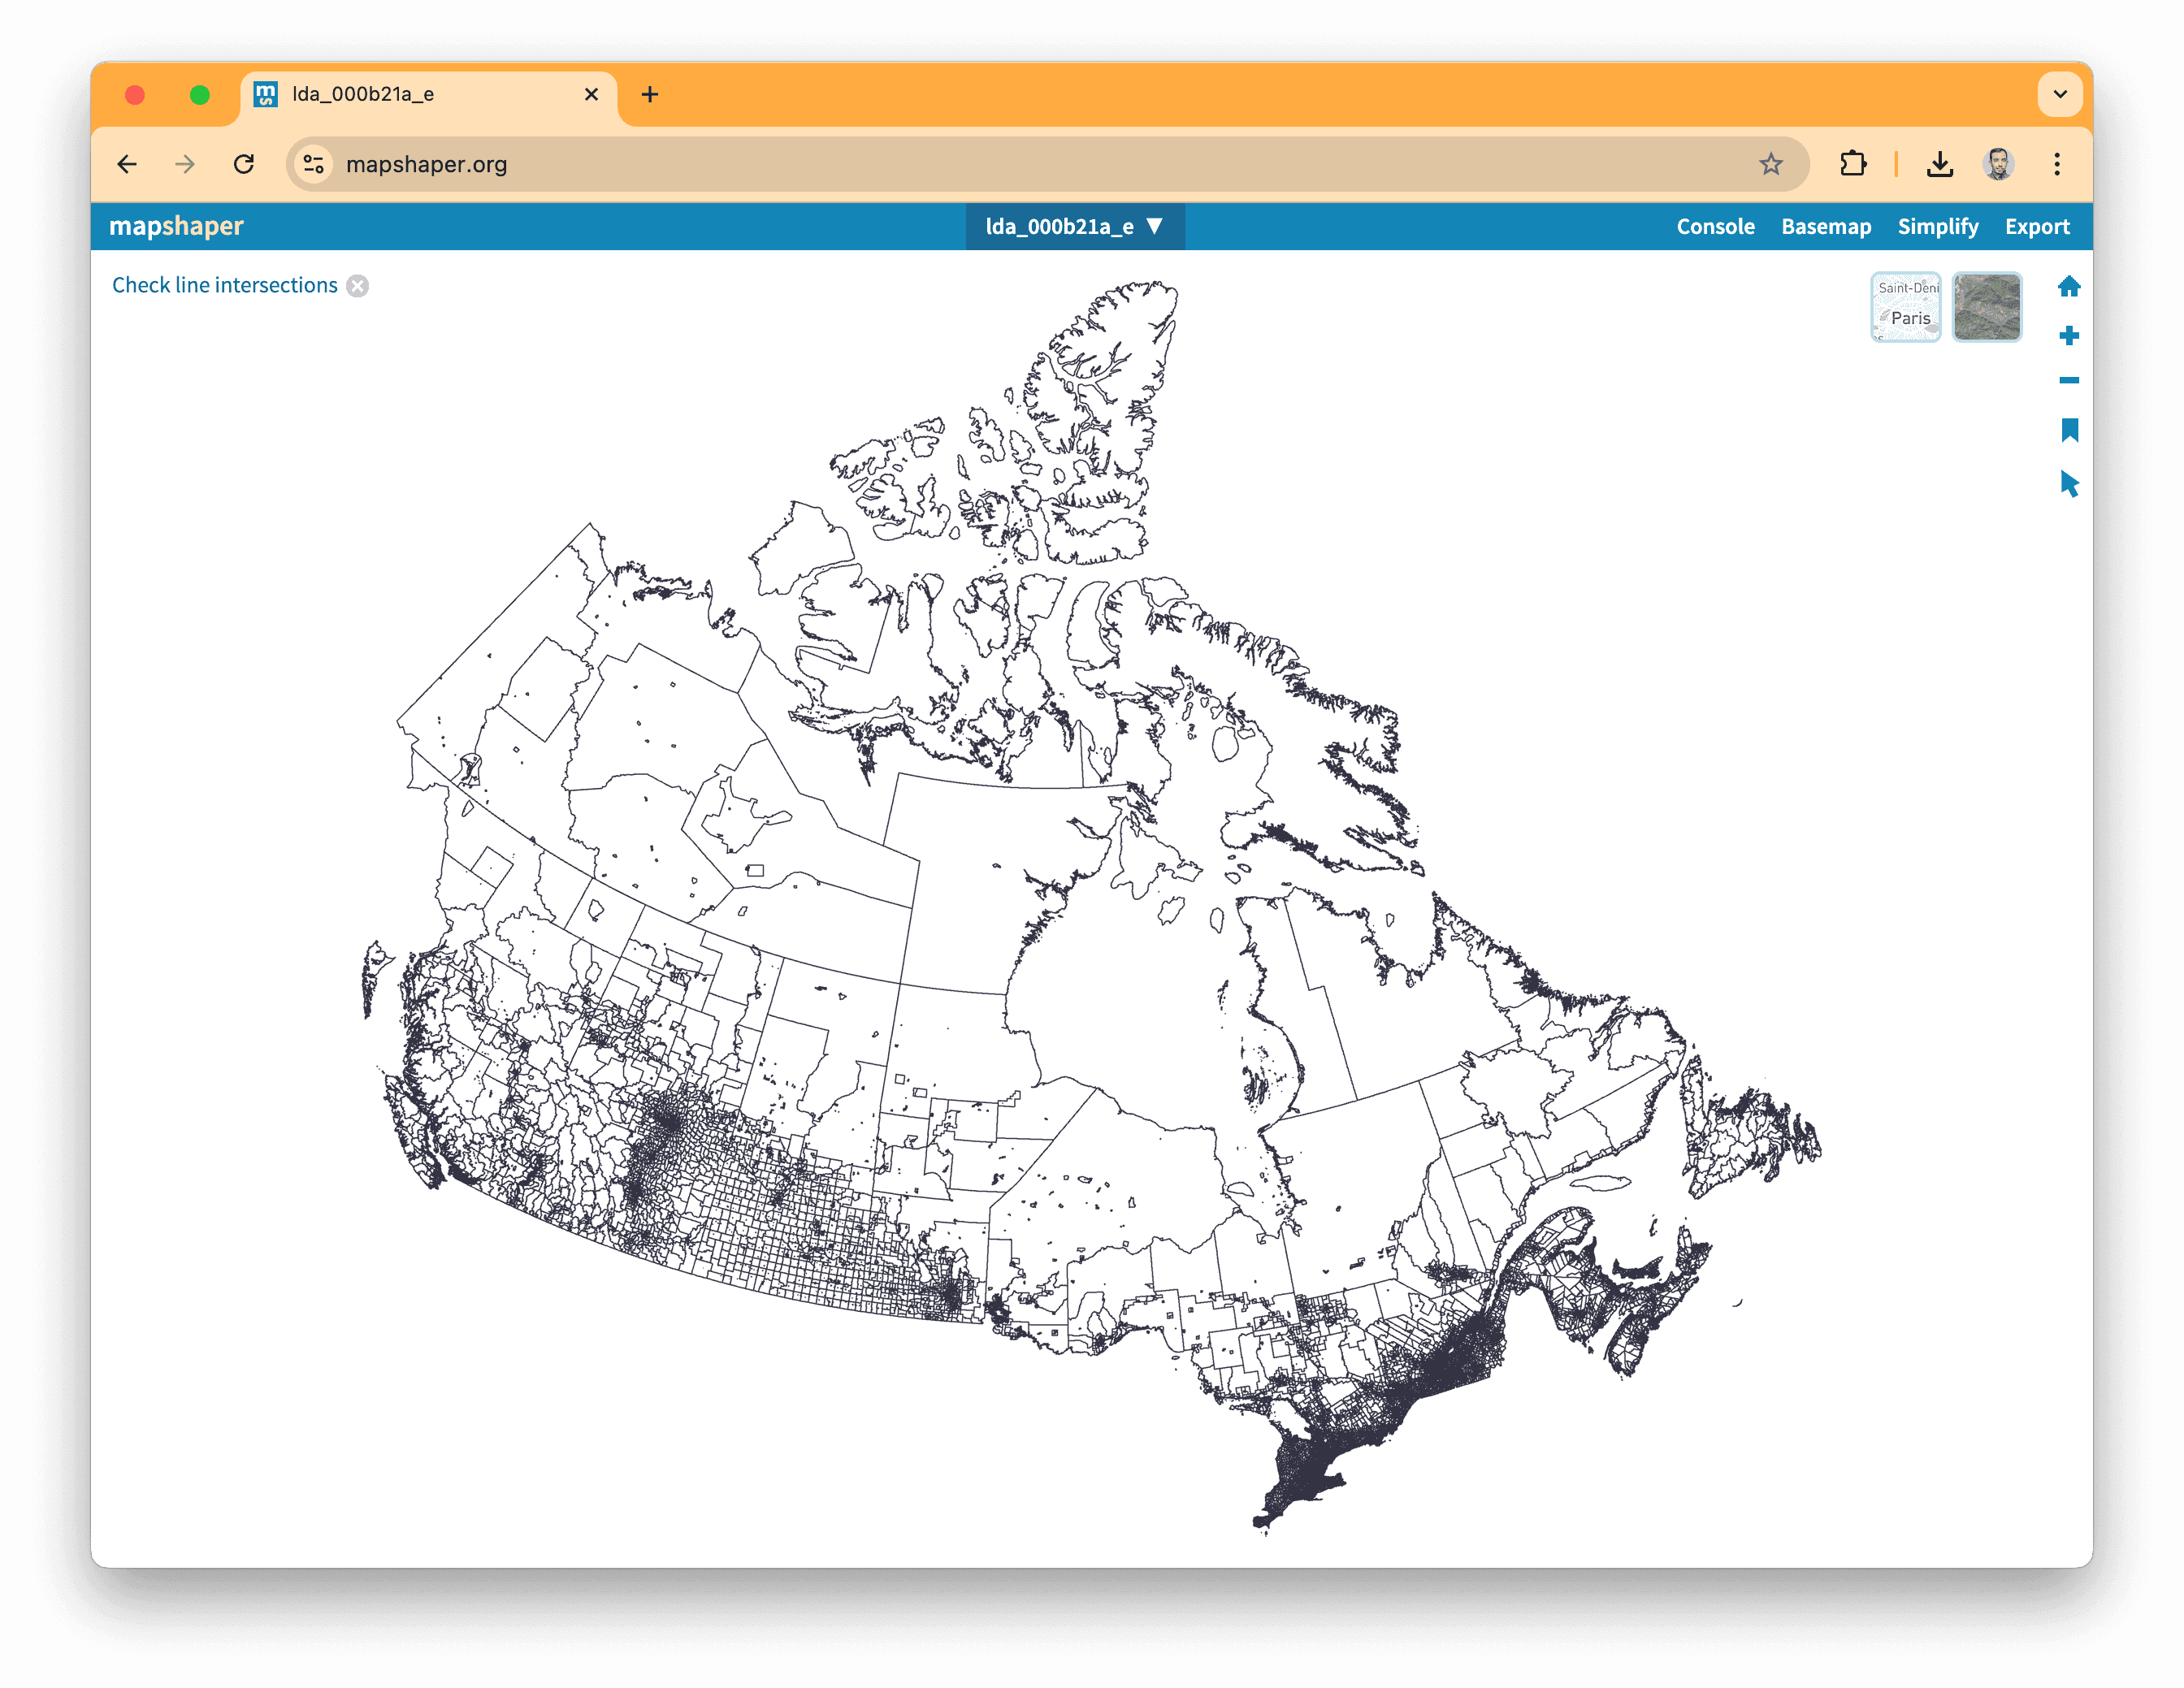
Après quelques secondes, vous verrez toutes les aires de diffusion.
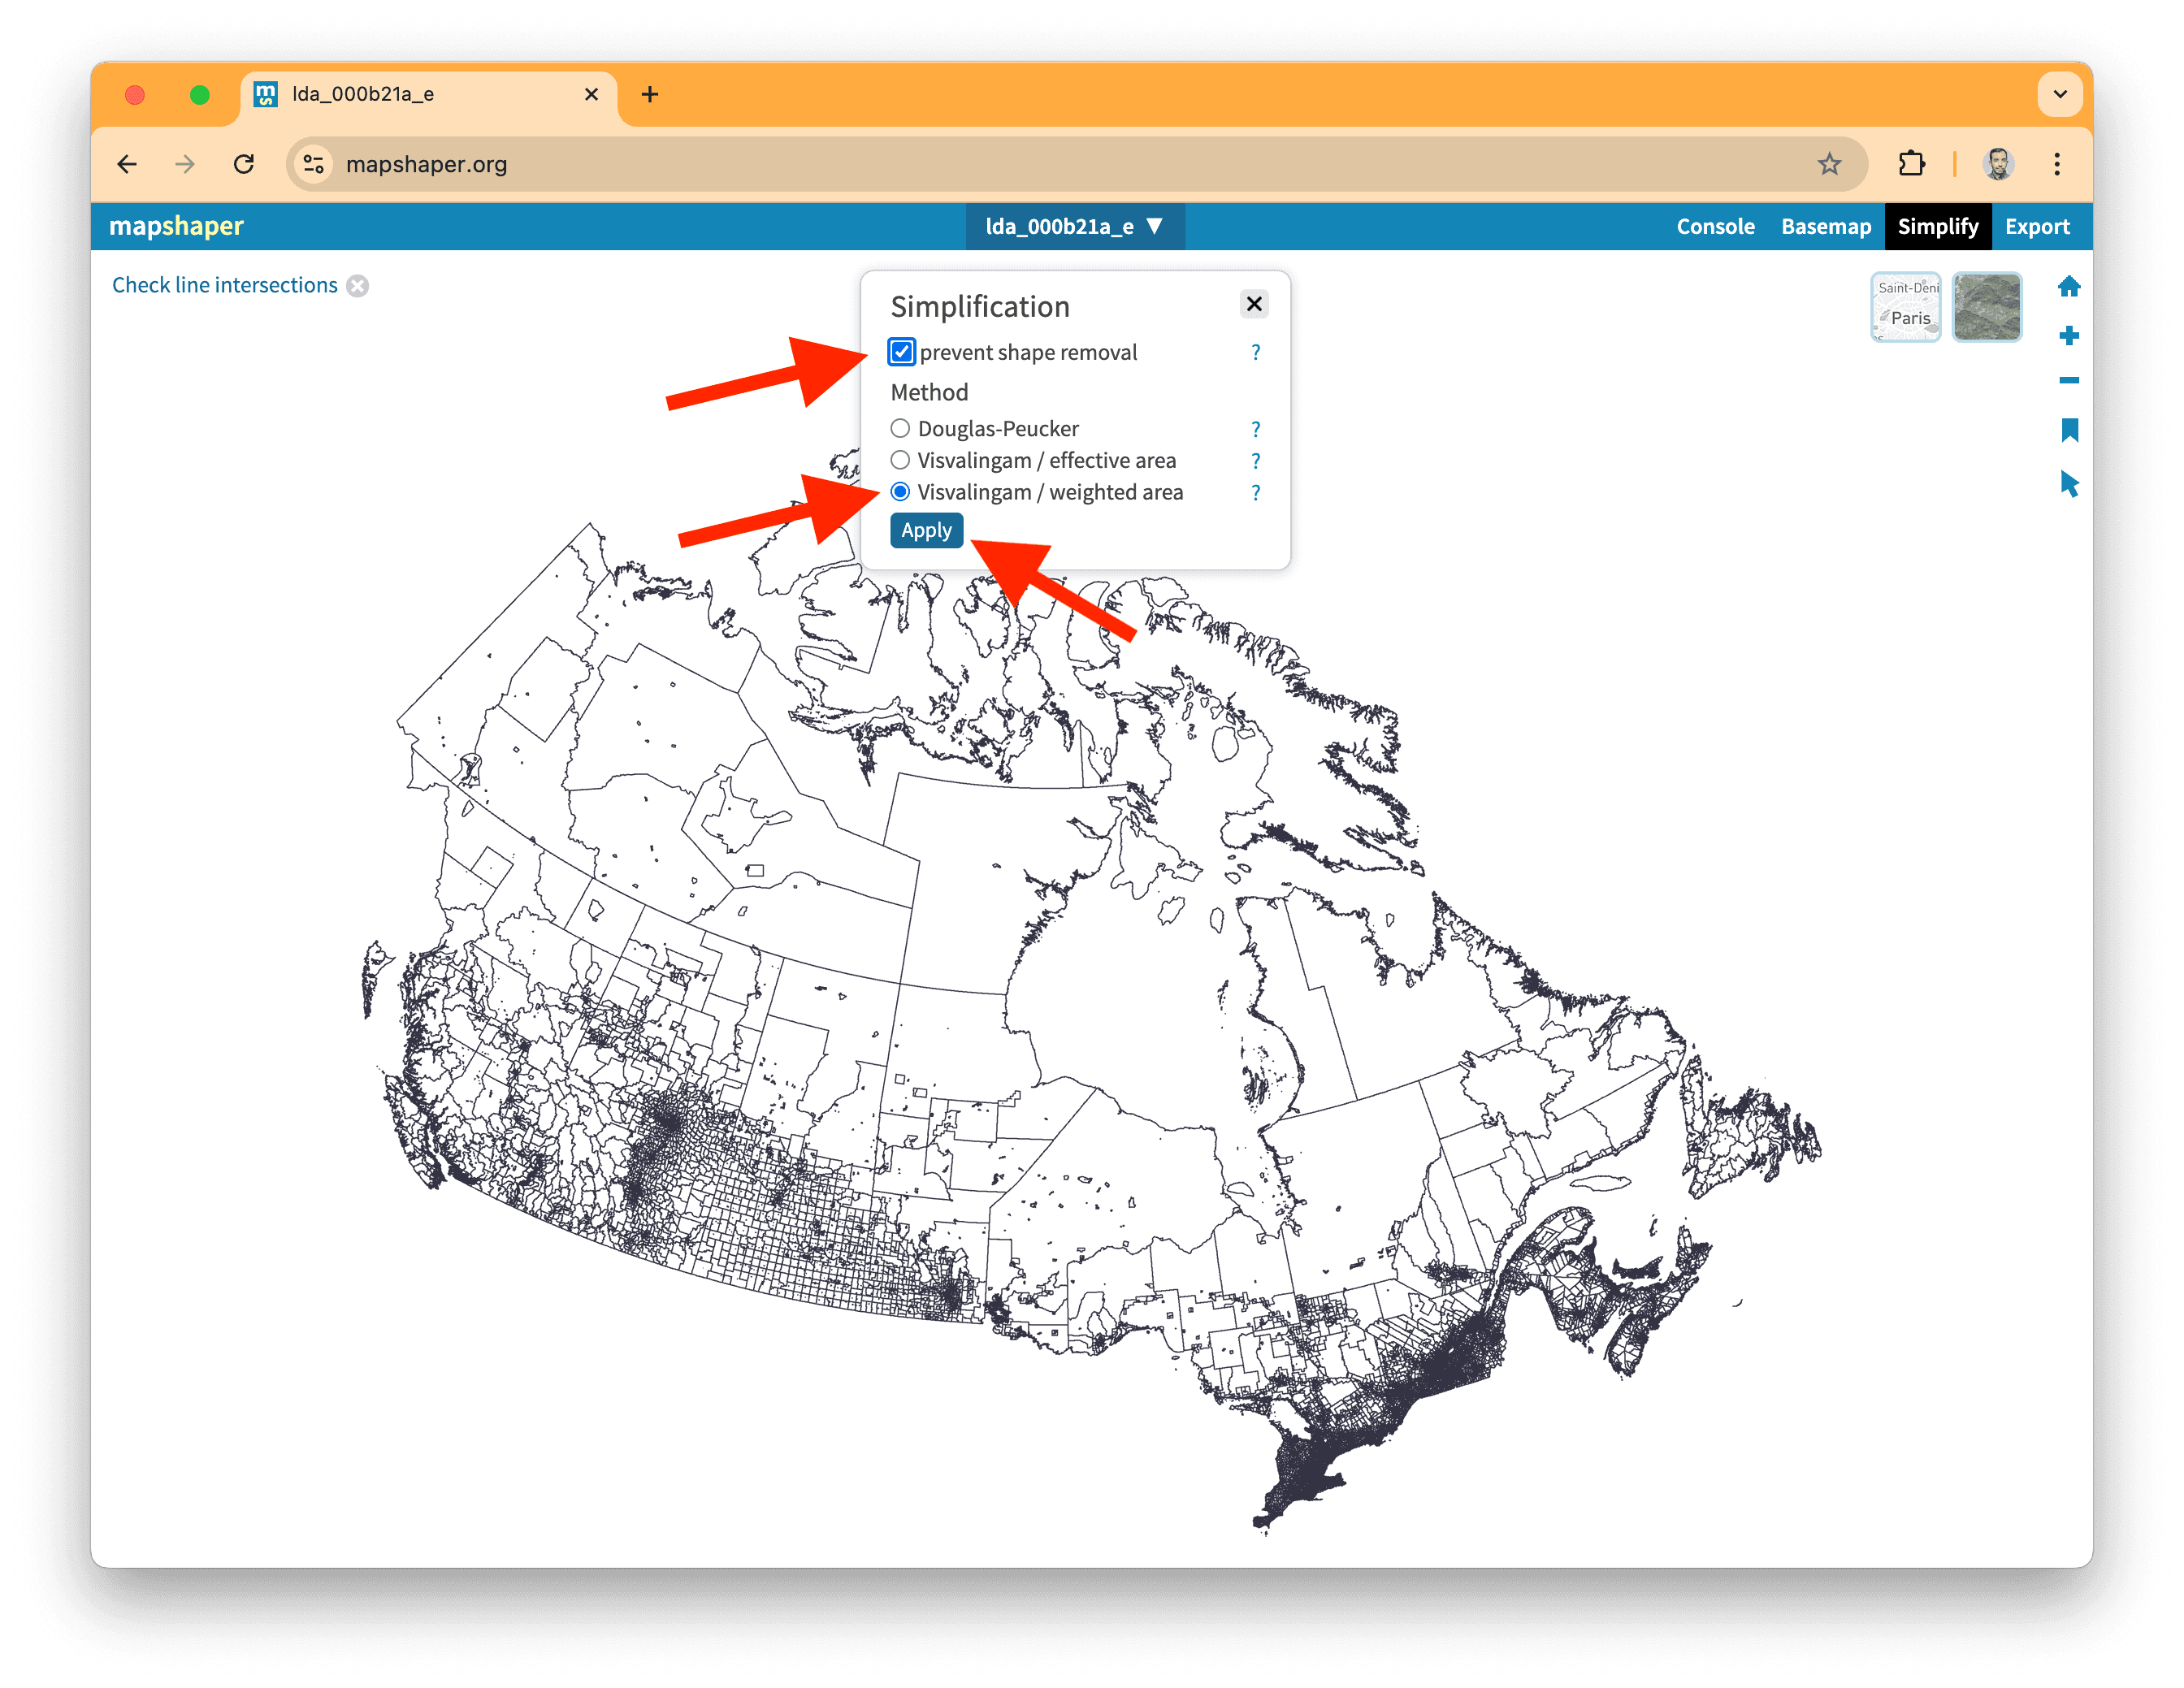
Cliquez sur Simplify en haut à droite et sélectionnez les options suivantes :
prevent shape removalVisvalingam / weighted area
Cliquez sur Apply !
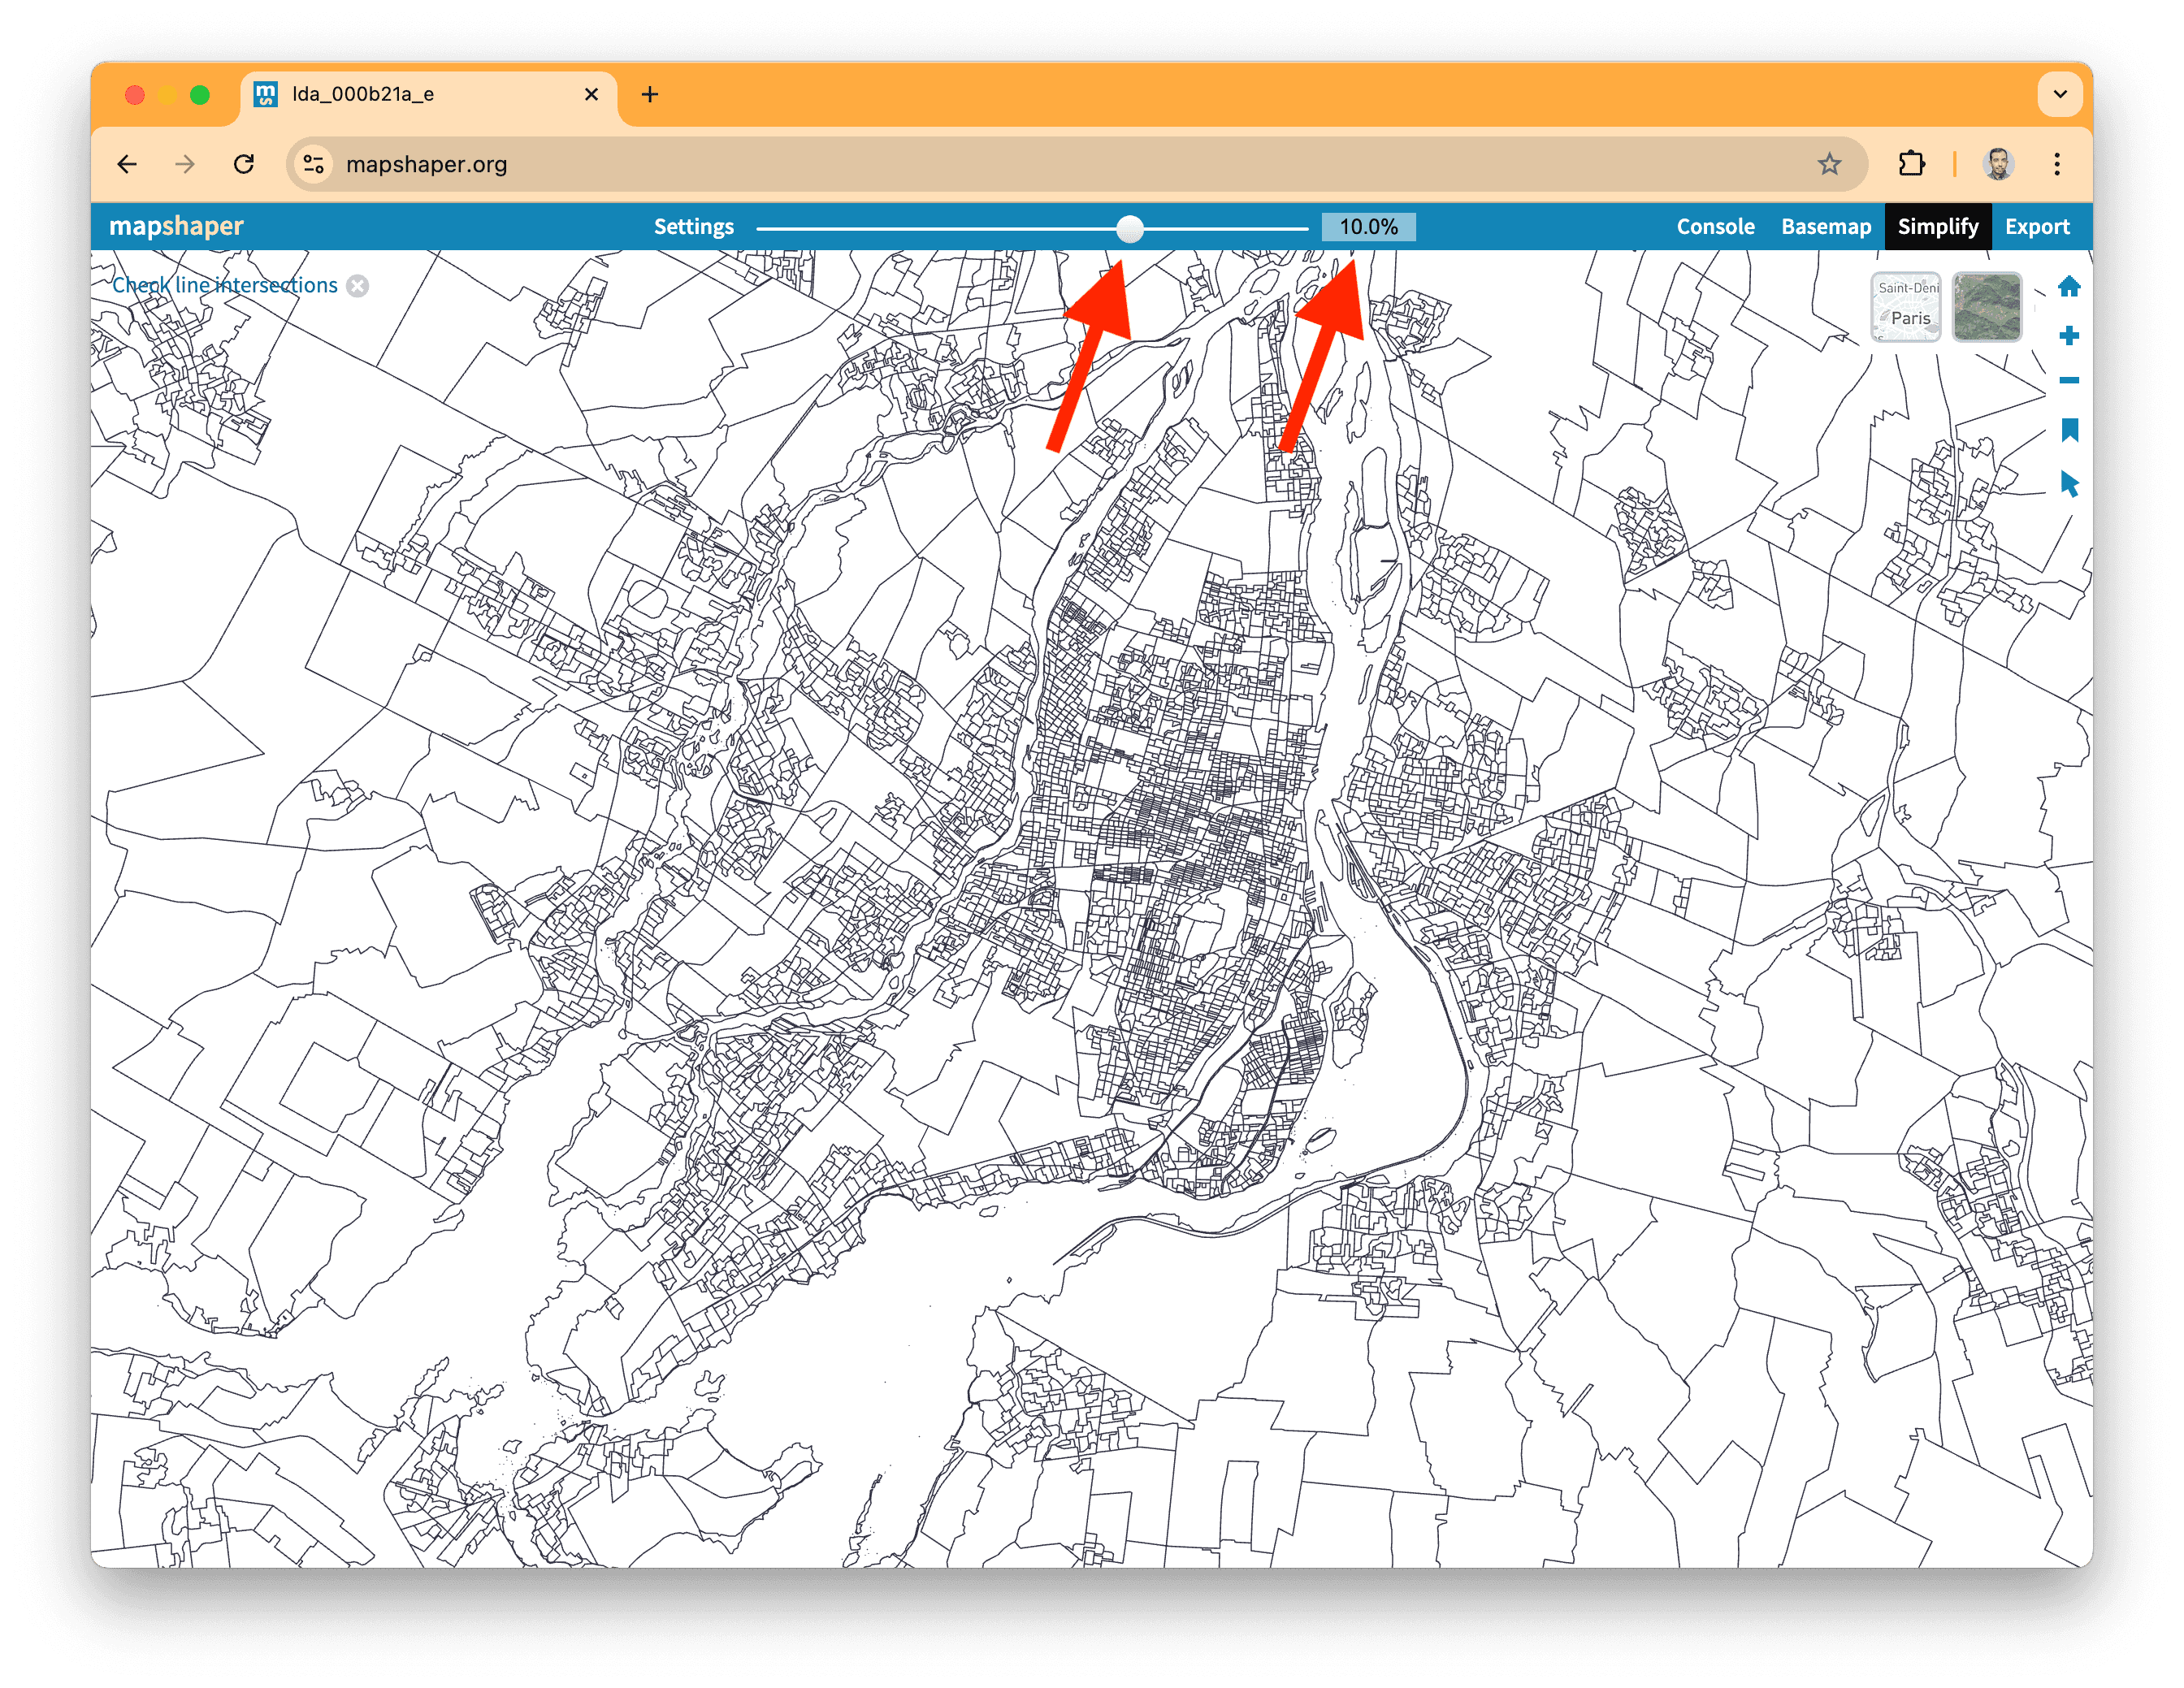
Pour l’étape suivante, je zoome habituellement sur une zone dense, comme Montréal. Ensuite, avec le curseur du haut, je cherche un seuil de simplification qui préserve la forme générale des polygones.
Ici, 10 % fonctionne bien. Vous pouvez aussi taper directement le pourcentage voulu.
Il ne reste qu’à exporter les données simplifiées !
Cliquez sur Export en haut à droite, conservez le format d’origine Shapefile, puis cliquez de nouveau sur Export.
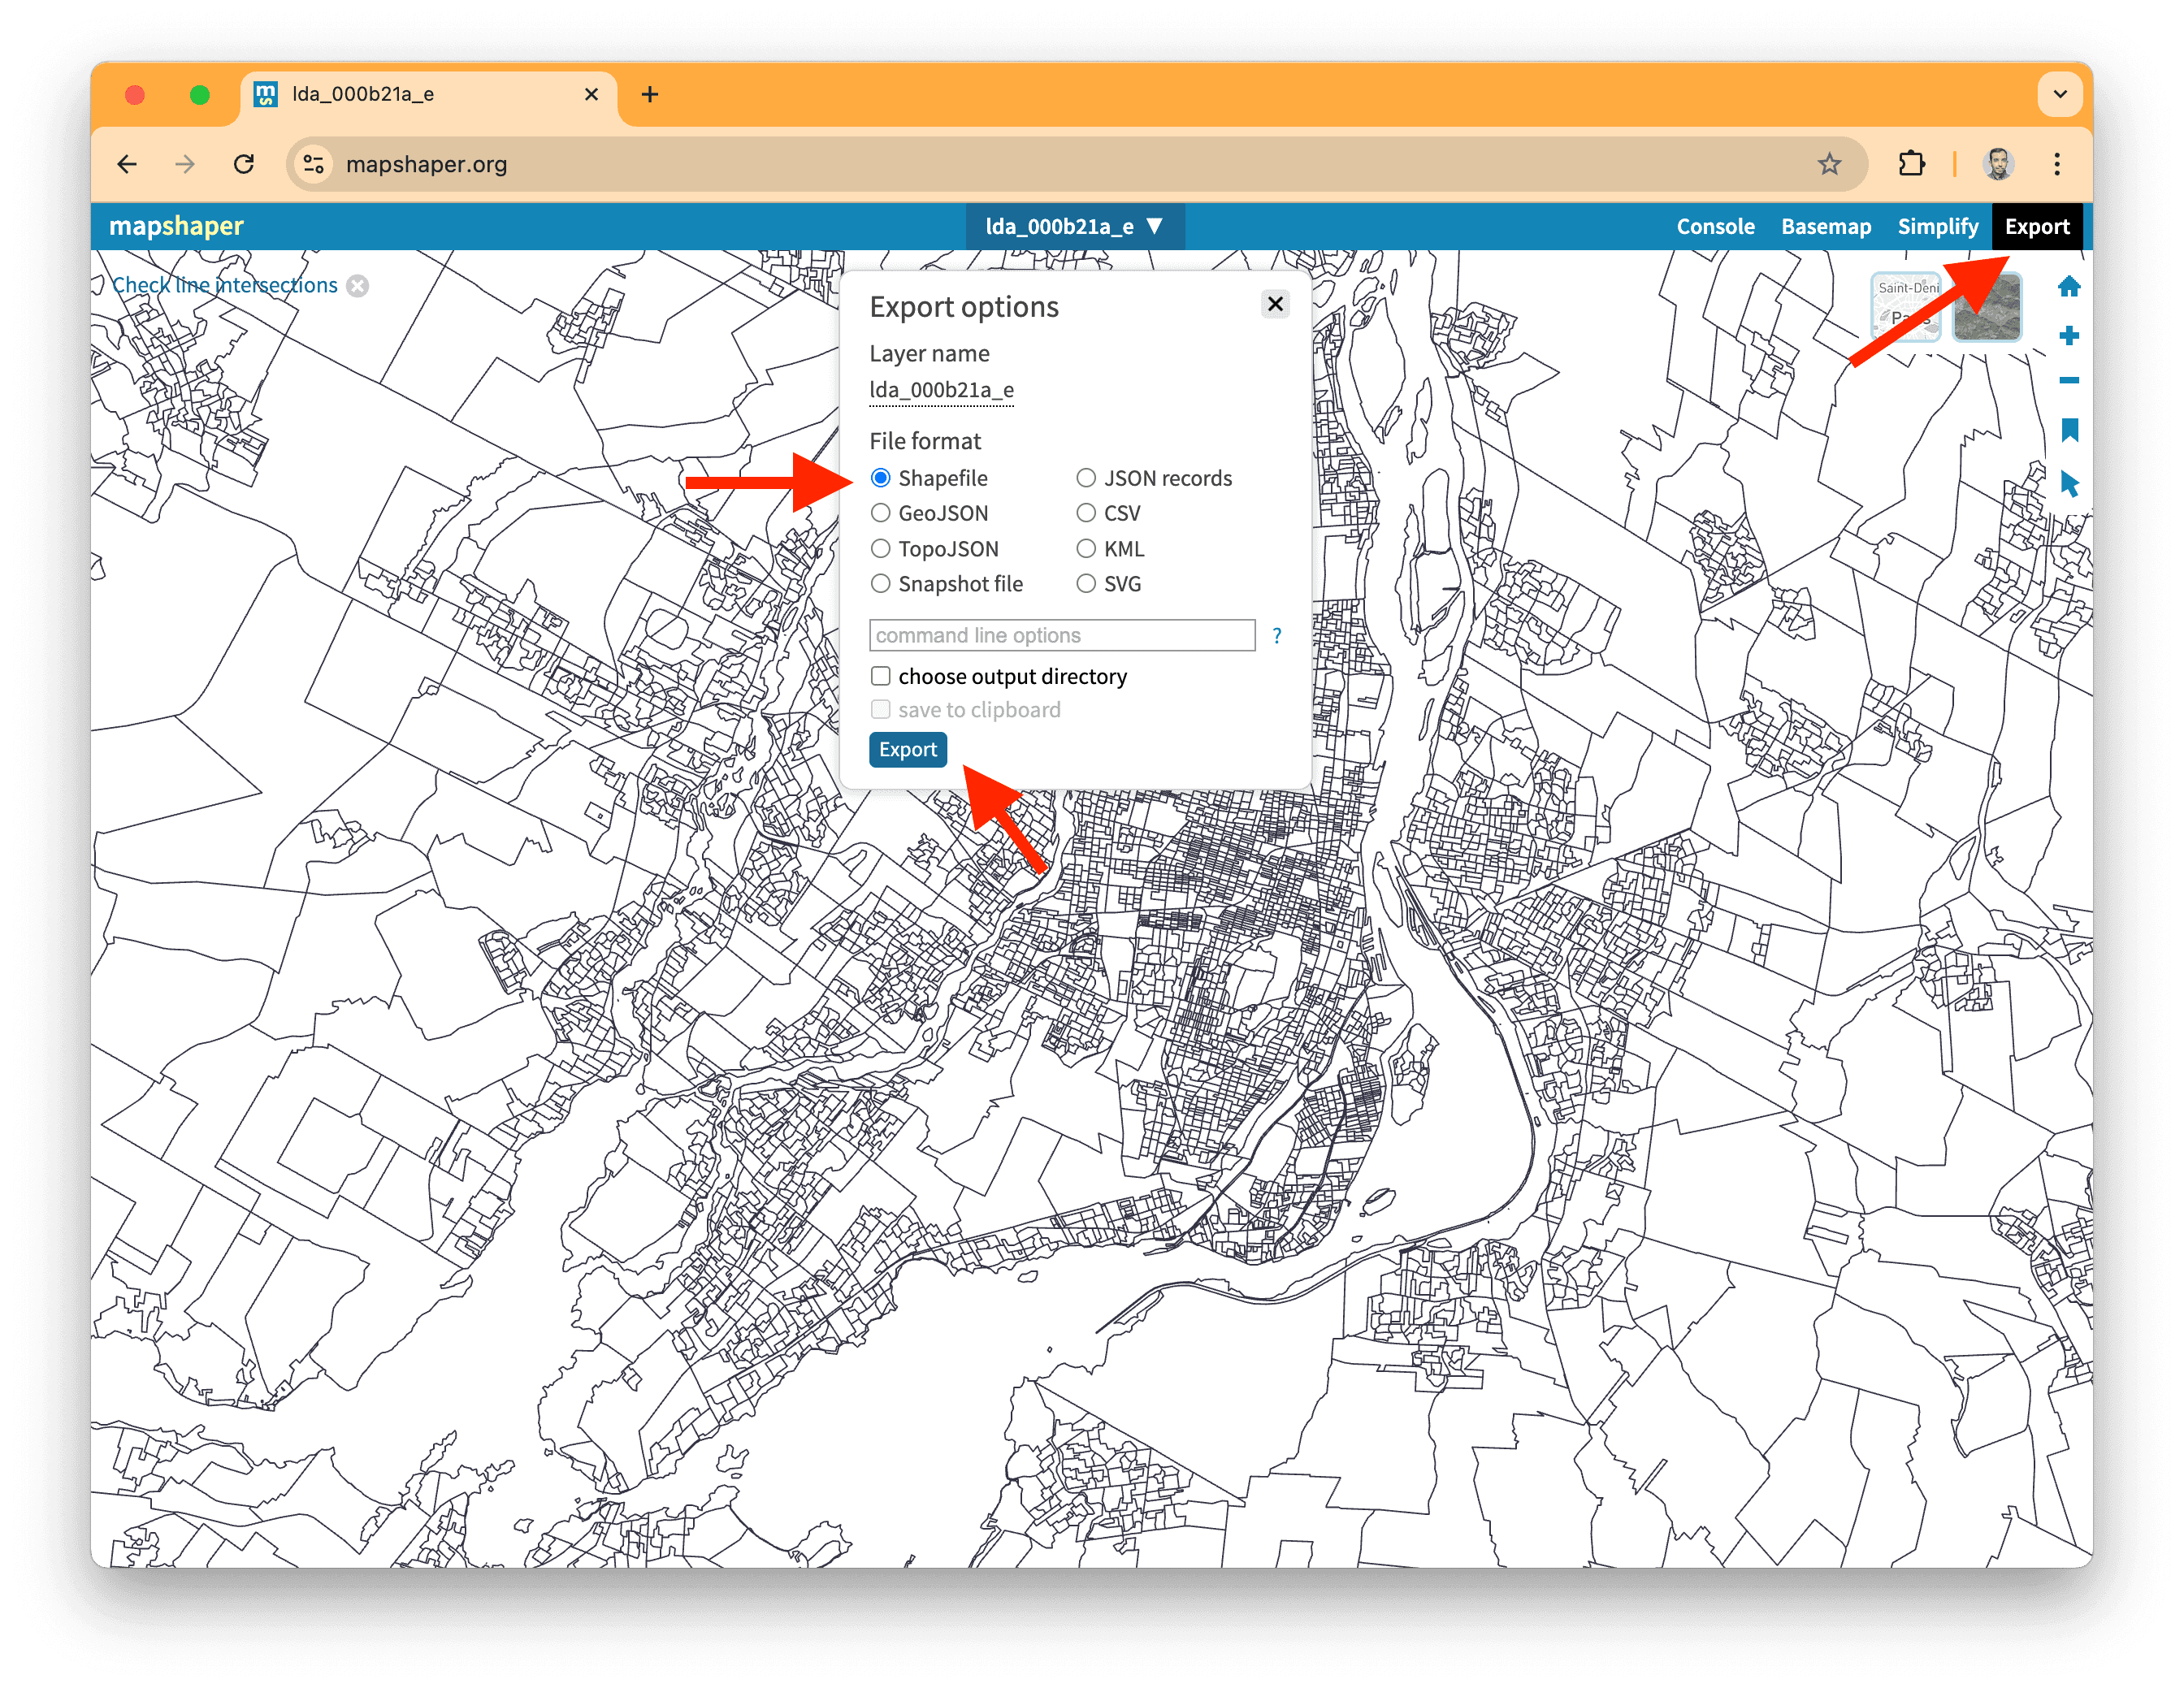
Renommez le fichier lda_000b21a_e.shp.zip (j’ai ajouté .shp.zip à l’extension pour aider SDA à reconnaître le Shapefile), puis déplacez-le dans le dossier data.
Nos données géospatiales ne pèsent plus que 27 Mo au lieu de 197 Mo, ce qui accélérera les calculs et la création des cartes !
Au lieu de 197 Mo, nos données géospatiales ne pèsent plus que 27 Mo, ce qui accélérera les calculs et la création des cartes !
Charger les géométries
Pour charger les géométries, nous utilisons loadGeoData plutôt que loadData. Cette méthode conserve les frontières et leurs coordonnées dans une colonne spatiale geom. Comme d’habitude, nous utilisons cache pour accélérer les prochaines étapes.
N’oubliez pas de donner l’extension .shp.zip à votre Shapefile simplifié. Le shp est important pour SDA : sans lui, la librairie ne reconnaît pas le fichier comme un Shapefile et ne peut pas le charger correctement.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ cacheVerbose: true });

const census = sdb.newTable("census");
await census.cache(() => {
  census.loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
    {
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  );
});
await census
  .keepValues({ CHARACTERISTIC_ID: 243 })
  .log();

const names = sdb.newTable("names");
await names.cache(() => {
  names.loadData("sda/data/2021_92-151_X.csv", {
    encoding: "cp1252",
    columns: ["DADGUID_ADIDUGD", "CMANAME_RMRNOM"],
    conditions: `CMATYPE_RMRGENRE = 'B'`,
  })
    .removeDuplicates()
    .renameColumns({
      DADGUID_ADIDUGD: "DGUID",
    });
});
await names.log();

await census
  .join(names)
  .log();

const disseminationAreas = sdb.newTable("disseminationAreas");
await disseminationAreas.cache(() => {
  disseminationAreas.loadGeoData("sda/data/lda_000b21a_e.shp.zip");
});
await disseminationAreas.log();

await sdb.close();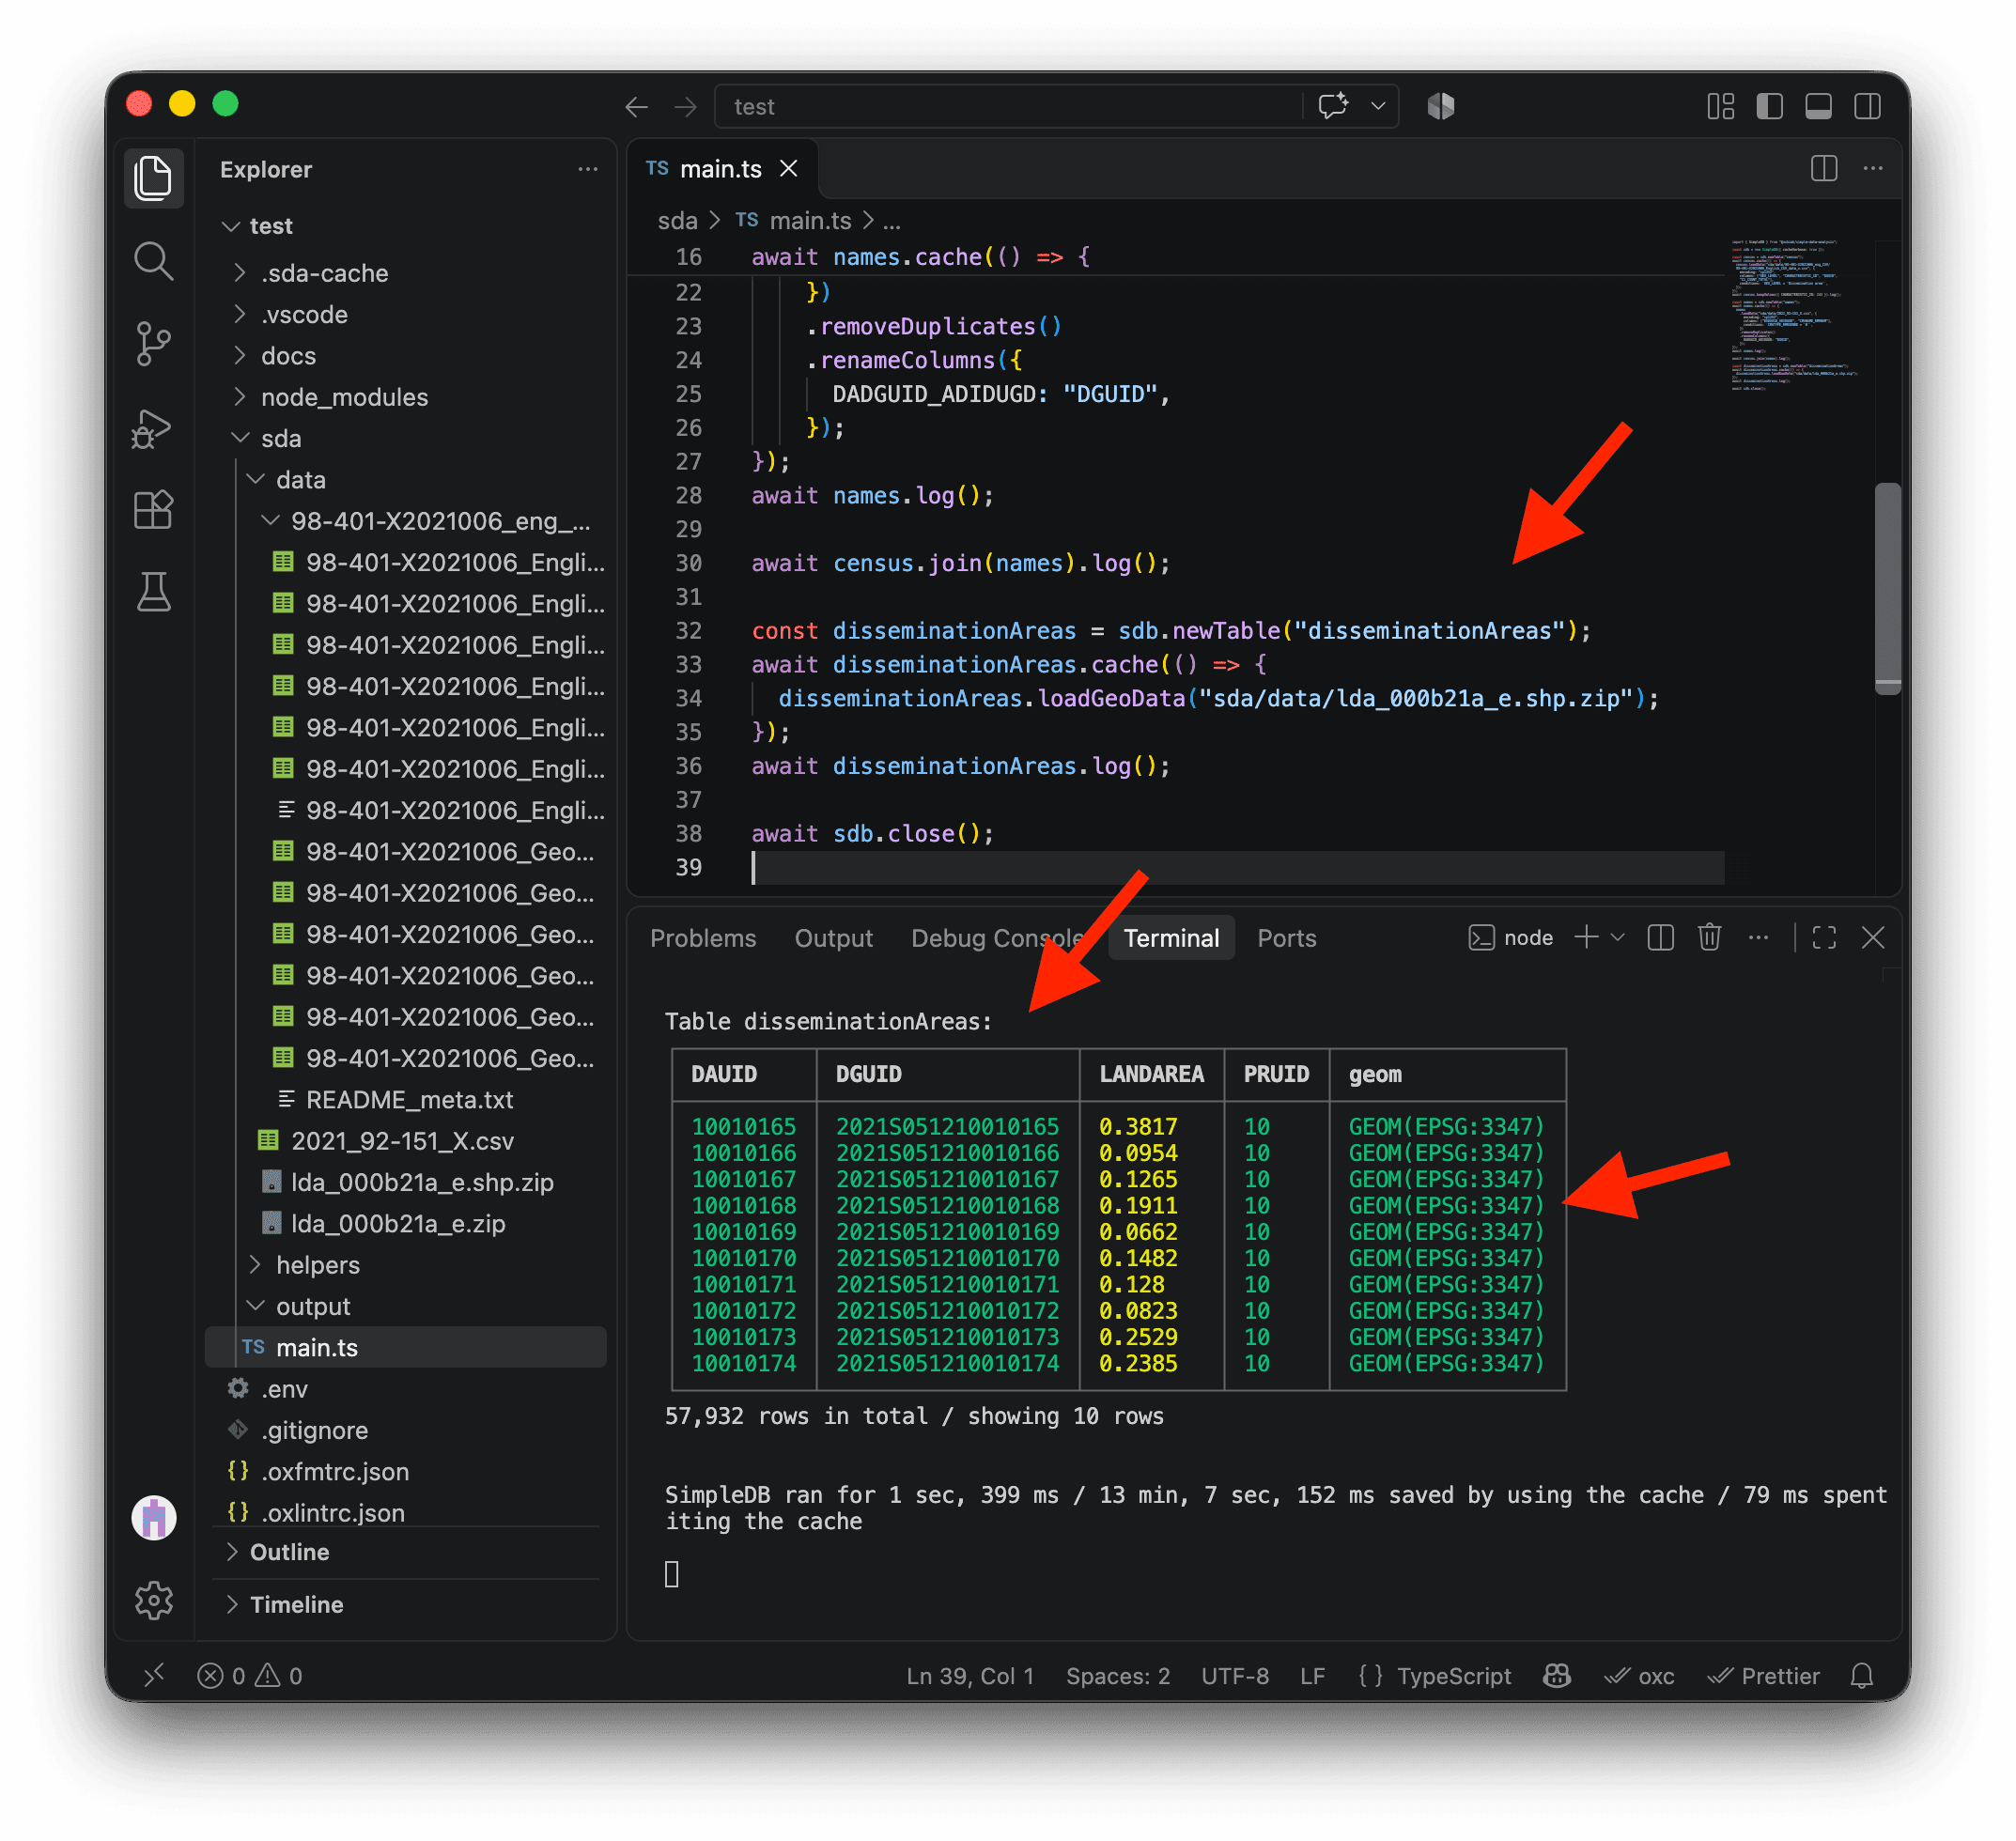
Les données géospatiales se chargent sans problème. Nous voyons les 57 932 aires de diffusion sous forme de lignes, avec leurs propriétés et leurs géométries.
Cependant, la projection pose problème. Dans la colonne geom, nous voyons GEOM(EPSG:3347). C’est la projection conique conforme de Lambert utilisée par Statistique Canada, dont les coordonnées sont mesurées en mètres. SDA peut l’utiliser, mais plusieurs méthodes, notamment celles qui dessinent les cartes, nécessitent EPSG:4326, une projection courante exprimée en degrés de latitude et de longitude.
Nous pouvons utiliser l’option toEPSG4326: true pour convertir les géométries dans le bon format.
Profitons-en pour ne conserver que les colonnes qui nous intéressent :
DGUID, l’identifiant unique des aires de diffusion que nous utiliserons pour joindre les géométries aux données du recensement.geom, qui contient les géométries.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ cacheVerbose: true });

const census = sdb.newTable("census");
await census.cache(() => {
  census.loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
    {
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  );
});
await census
  .keepValues({ CHARACTERISTIC_ID: 243 })
  .log();

const names = sdb.newTable("names");
await names.cache(() => {
  names.loadData("sda/data/2021_92-151_X.csv", {
    encoding: "cp1252",
    columns: ["DADGUID_ADIDUGD", "CMANAME_RMRNOM"],
    conditions: `CMATYPE_RMRGENRE = 'B'`,
  })
    .removeDuplicates()
    .renameColumns({
      DADGUID_ADIDUGD: "DGUID",
    });
});
await names.log();

await census
  .join(names)
  .log();

const disseminationAreas = sdb.newTable("disseminationAreas");
await disseminationAreas.cache(() => {
  disseminationAreas.loadGeoData("sda/data/lda_000b21a_e.shp.zip", {
    toEPSG4326: true,
    columns: ["DGUID", "geom"],
  });
});
await disseminationAreas.log();

await sdb.close();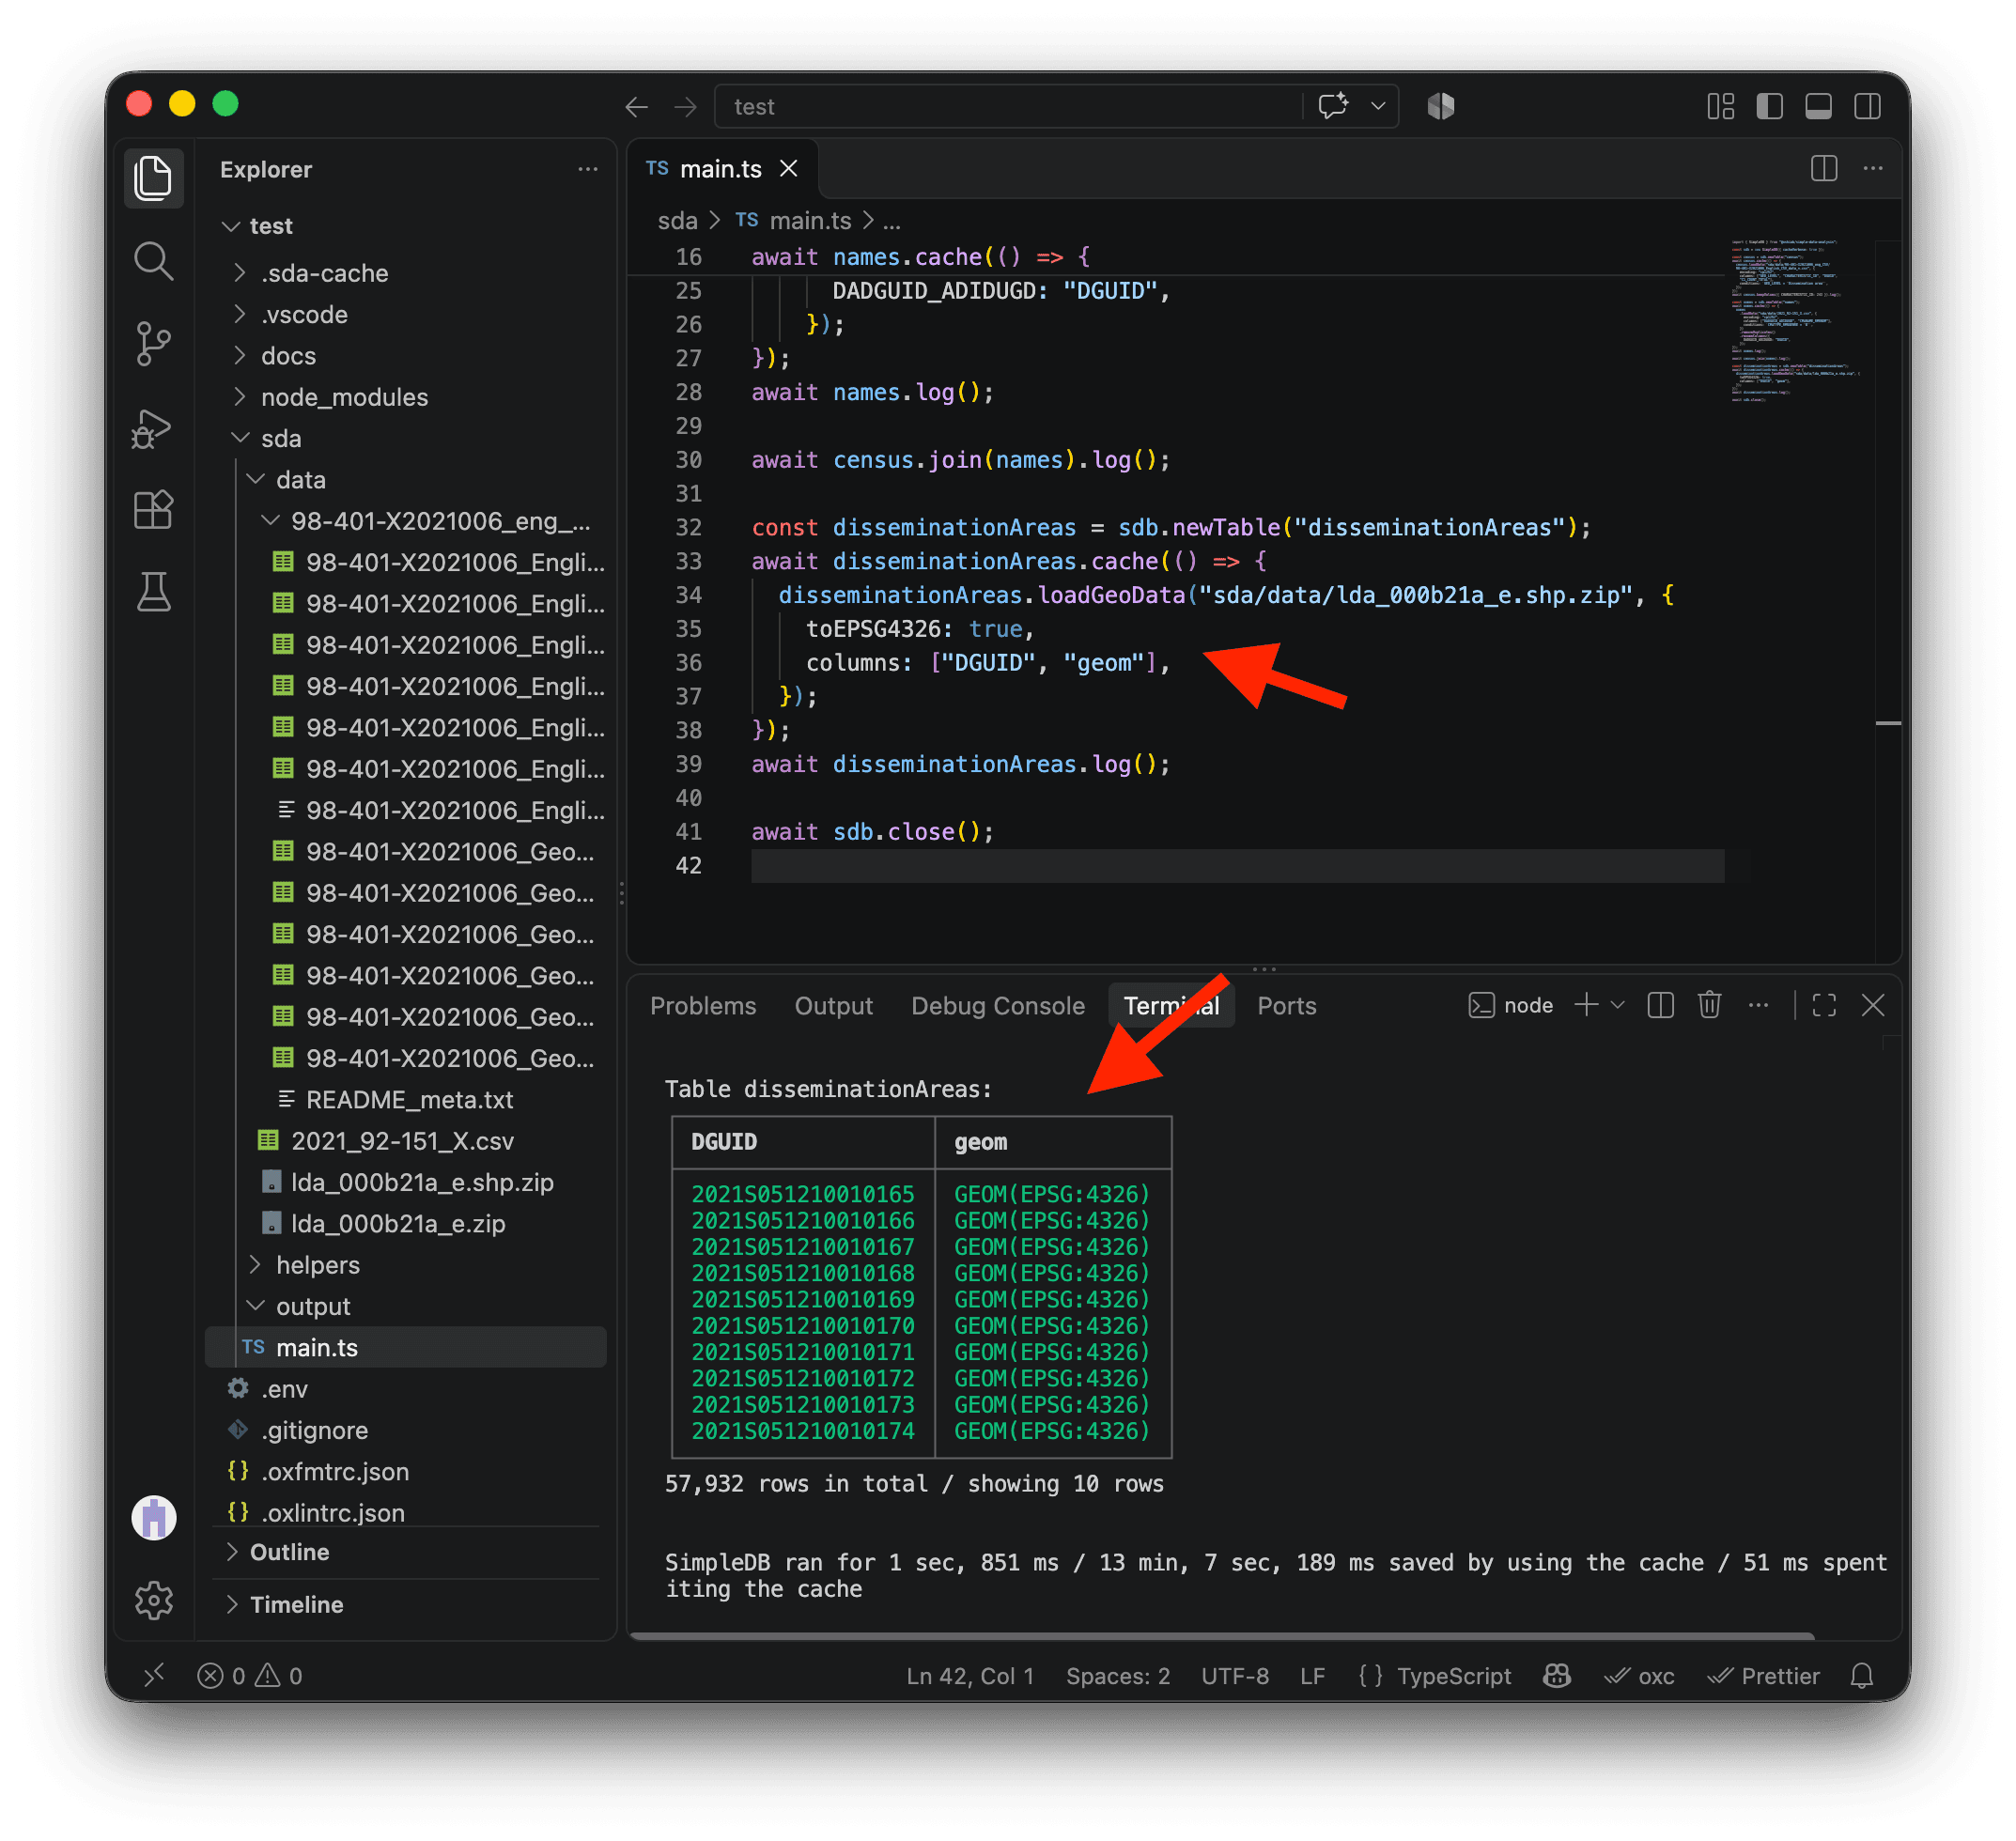
Nous voyons maintenant GEOM(EPSG:4326) dans la colonne geom, ce qui confirme que les géométries utilisent la bonne projection. Nous avons aussi conservé DGUID, l’identifiant unique qui nous permettra d’associer les frontières aux aires de diffusion du recensement.
La dernière étape consiste à joindre les frontières des aires de diffusion aux données du recensement, puis à appeler removeMissing(). Nous ne gardons ainsi que les aires dotées d’une géométrie et d’une valeur dans C1_COUNT_TOTAL. Nous avons maintenant 37 590 aires de diffusion avec presque tout ce qu’il nous faut pour créer notre carte ! 🗺️
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ cacheVerbose: true });

const census = sdb.newTable("census");
await census.cache(() => {
  census.loadData(
    "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
    {
      encoding: "cp1252",
      columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
      conditions: `GEO_LEVEL = 'Dissemination area'`,
    },
  );
});
await census
  .keepValues({ CHARACTERISTIC_ID: 243 })
  .log();

const names = sdb.newTable("names");
await names.cache(() => {
  names.loadData("sda/data/2021_92-151_X.csv", {
    encoding: "cp1252",
    columns: ["DADGUID_ADIDUGD", "CMANAME_RMRNOM"],
    conditions: `CMATYPE_RMRGENRE = 'B'`,
  })
    .removeDuplicates()
    .renameColumns({
      DADGUID_ADIDUGD: "DGUID",
    });
});
await names.log();

await census
  .join(names)
  .log();

const disseminationAreas = sdb.newTable("disseminationAreas");
await disseminationAreas.cache(() => {
  disseminationAreas.loadGeoData("sda/data/lda_000b21a_e.shp.zip", {
    toEPSG4326: true,
    columns: ["DGUID", "geom"],
  });
});
await disseminationAreas
  .join(census)
  .removeMissing()
  .log();

await sdb.close();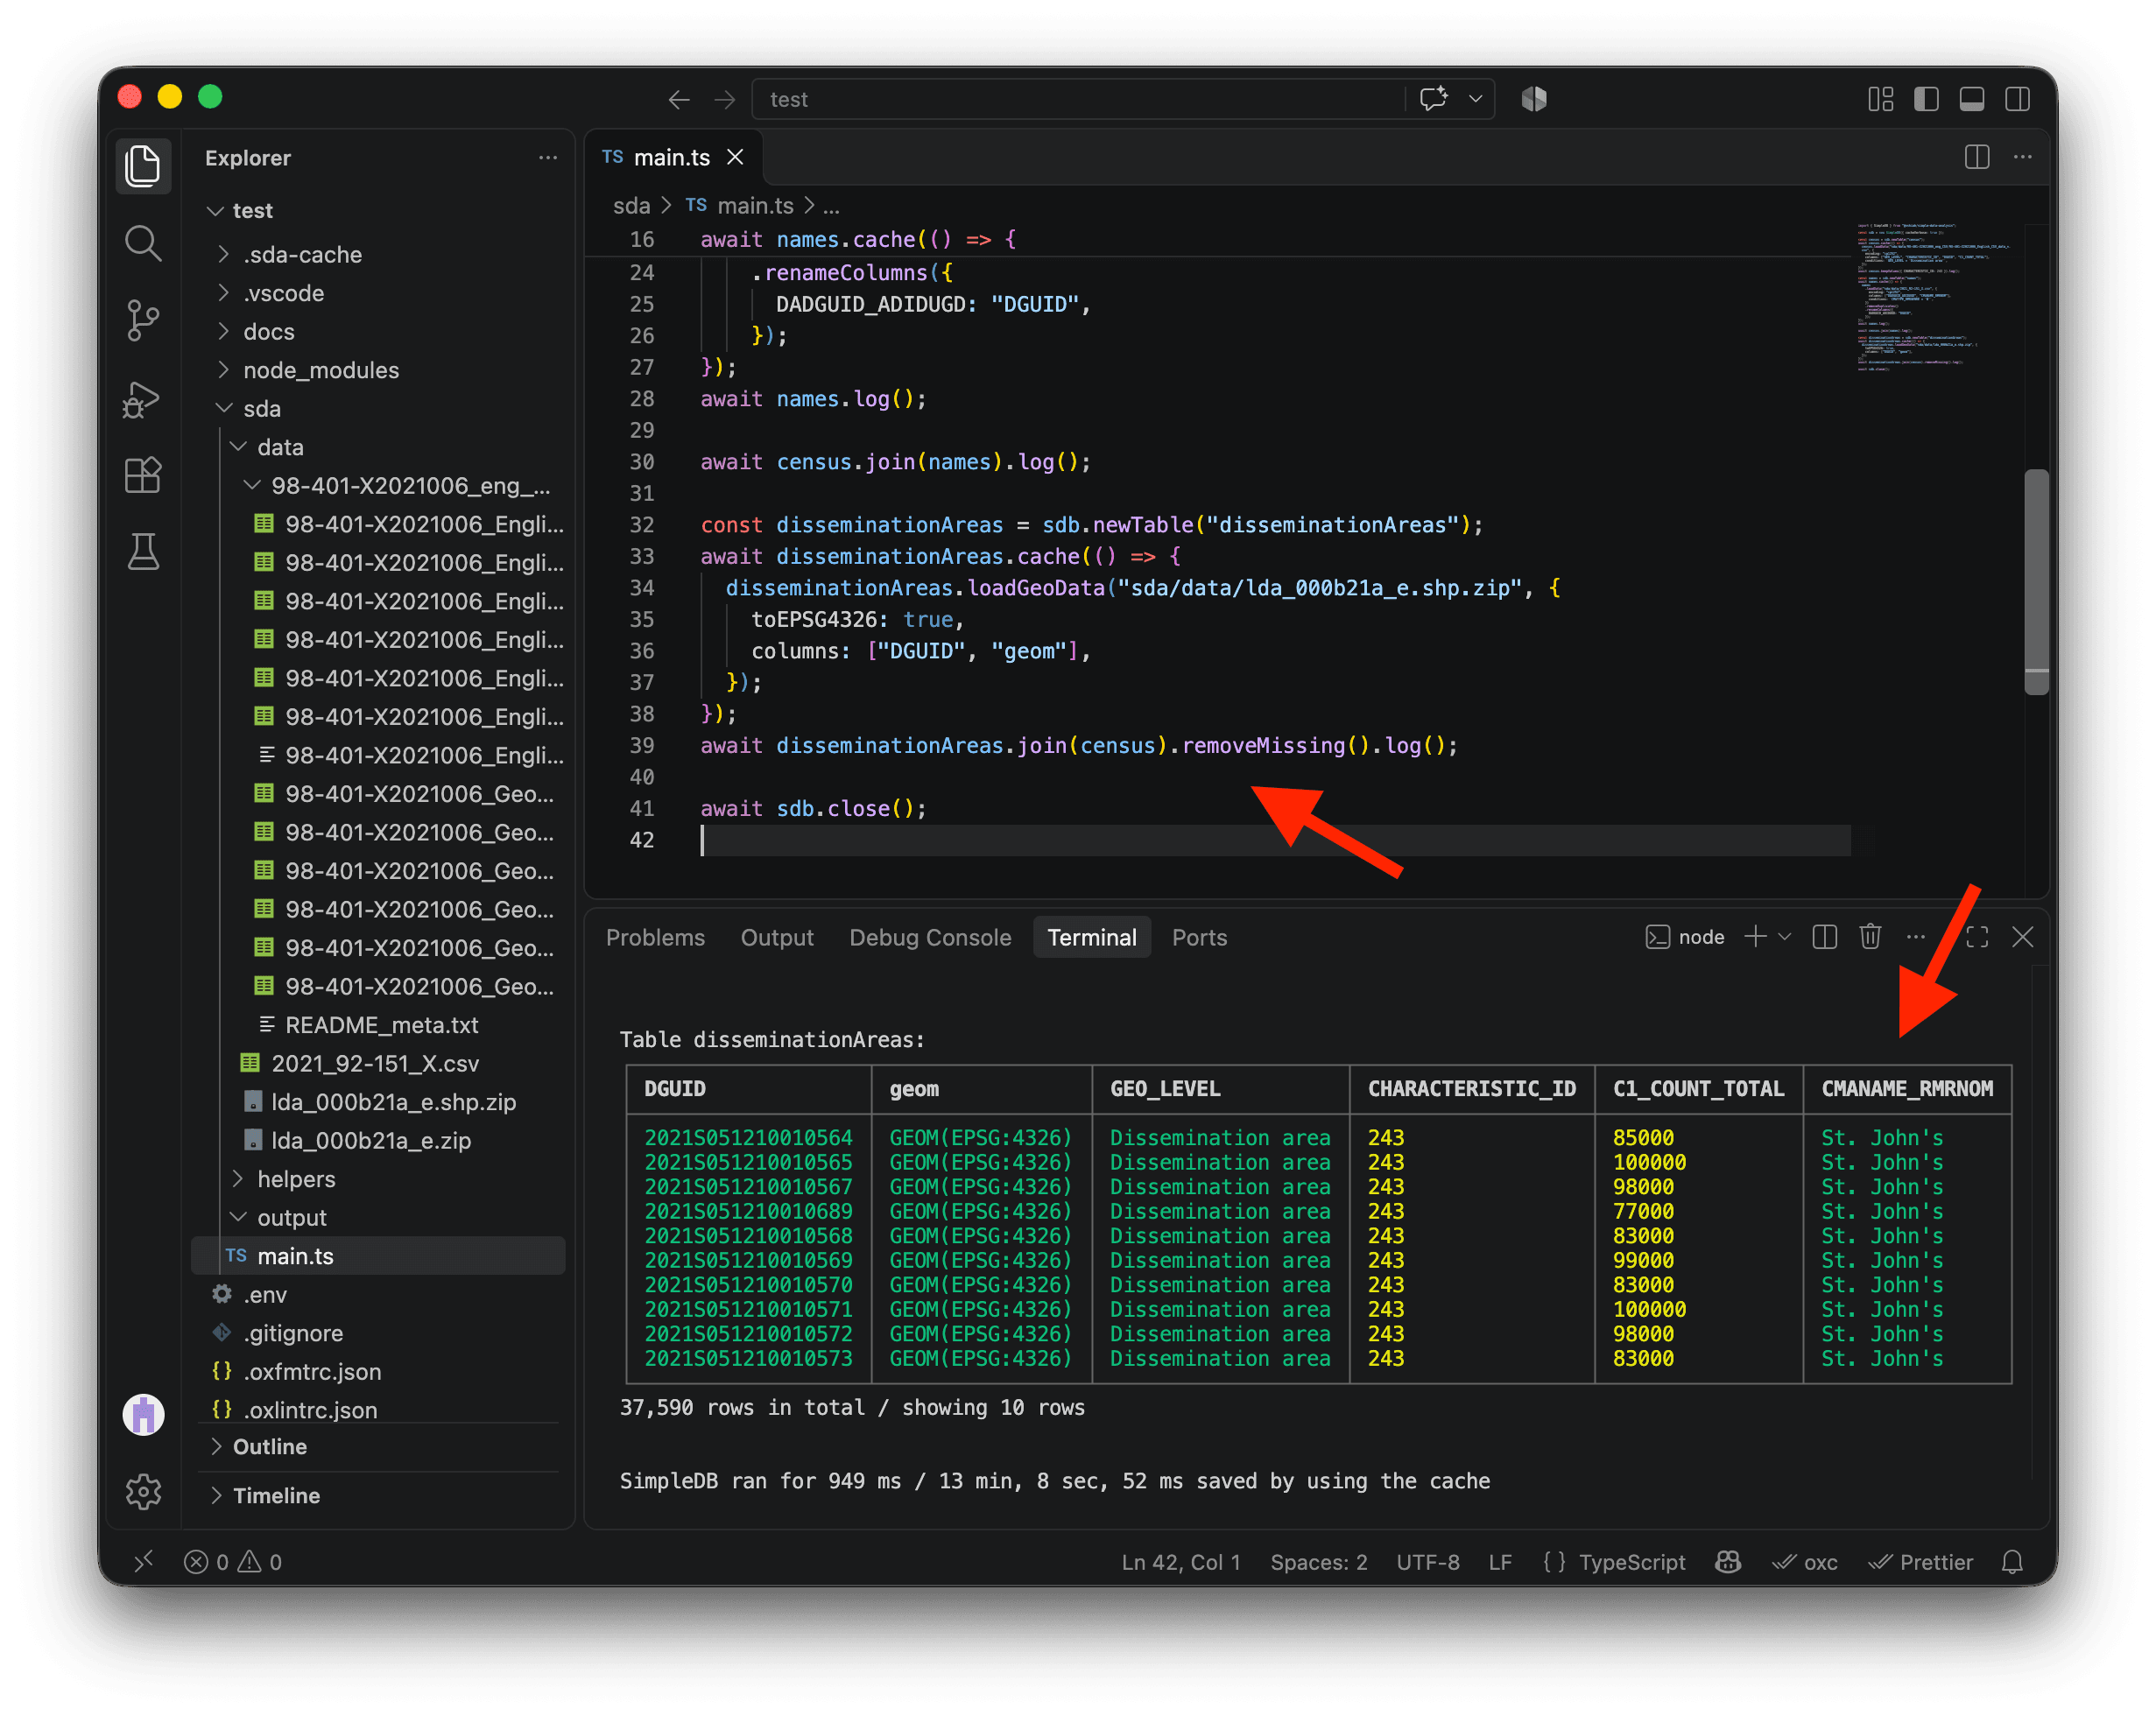
Avant d’aller plus loin, réorganisons le code écrit jusqu’ici. Il sert à créer notre table d’aires de diffusion. Déplaçons-le donc dans une fonction utilitaire nommée getDisseminationAreas, dans le dossier helpers. Pas d’inquiétude : le cache est assez intelligent pour reconnaître que le code n’a pas changé, même s’il se trouve dans un autre fichier. Nous conservons donc tous les gains de vitesse du cache ! ⚡
Nous ajoutons export default à la ligne 3 pour pouvoir importer la fonction ailleurs dans le code. Nous retournons aussi disseminationAreas à la ligne 43 pour pouvoir travailler avec la table créée par la fonction. Maintenant que nous savons ce que fait chaque étape, j’ai retiré les appels intermédiaires à .log() et gardé seulement le dernier pour que le terminal reste clair.
import { SimpleDB } from "@nshiab/simple-data-analysis";

export default async function getDisseminationAreas(sdb: SimpleDB) {
  const census = sdb.newTable("census");
  await census.cache(() => {
    census.loadData(
      "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
      {
        encoding: "cp1252",
        columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
        conditions: `GEO_LEVEL = 'Dissemination area'`,
      },
    );
  });
  census.keepValues({ CHARACTERISTIC_ID: 243 });

  const names = sdb.newTable("names");
  await names.cache(() => {
    names.loadData("sda/data/2021_92-151_X.csv", {
      encoding: "cp1252",
      columns: ["DADGUID_ADIDUGD", "CMANAME_RMRNOM"],
      conditions: `CMATYPE_RMRGENRE = 'B'`,
    })
      .removeDuplicates()
      .renameColumns({
        DADGUID_ADIDUGD: "DGUID",
      });
  });
  census.join(names);

  const disseminationAreas = sdb.newTable("disseminationAreas");
  await disseminationAreas.cache(() => {
    disseminationAreas.loadGeoData("sda/data/lda_000b21a_e.shp.zip", {
      toEPSG4326: true,
      columns: ["DGUID", "geom"],
    });
  });
  await disseminationAreas
    .join(census)
    .removeMissing()
    .log();

  return disseminationAreas;
}
Nous pouvons maintenant importer et appeler getDisseminationAreas dans main.ts, puis enregistrer le résultat dans la constante disseminationAreas.
import { SimpleDB } from "@nshiab/simple-data-analysis";
import getDisseminationAreas from "./helpers/getDisseminationAreas.ts";

const sdb = new SimpleDB({ cacheVerbose: true });

const disseminationAreas = await getDisseminationAreas(sdb);

await sdb.close();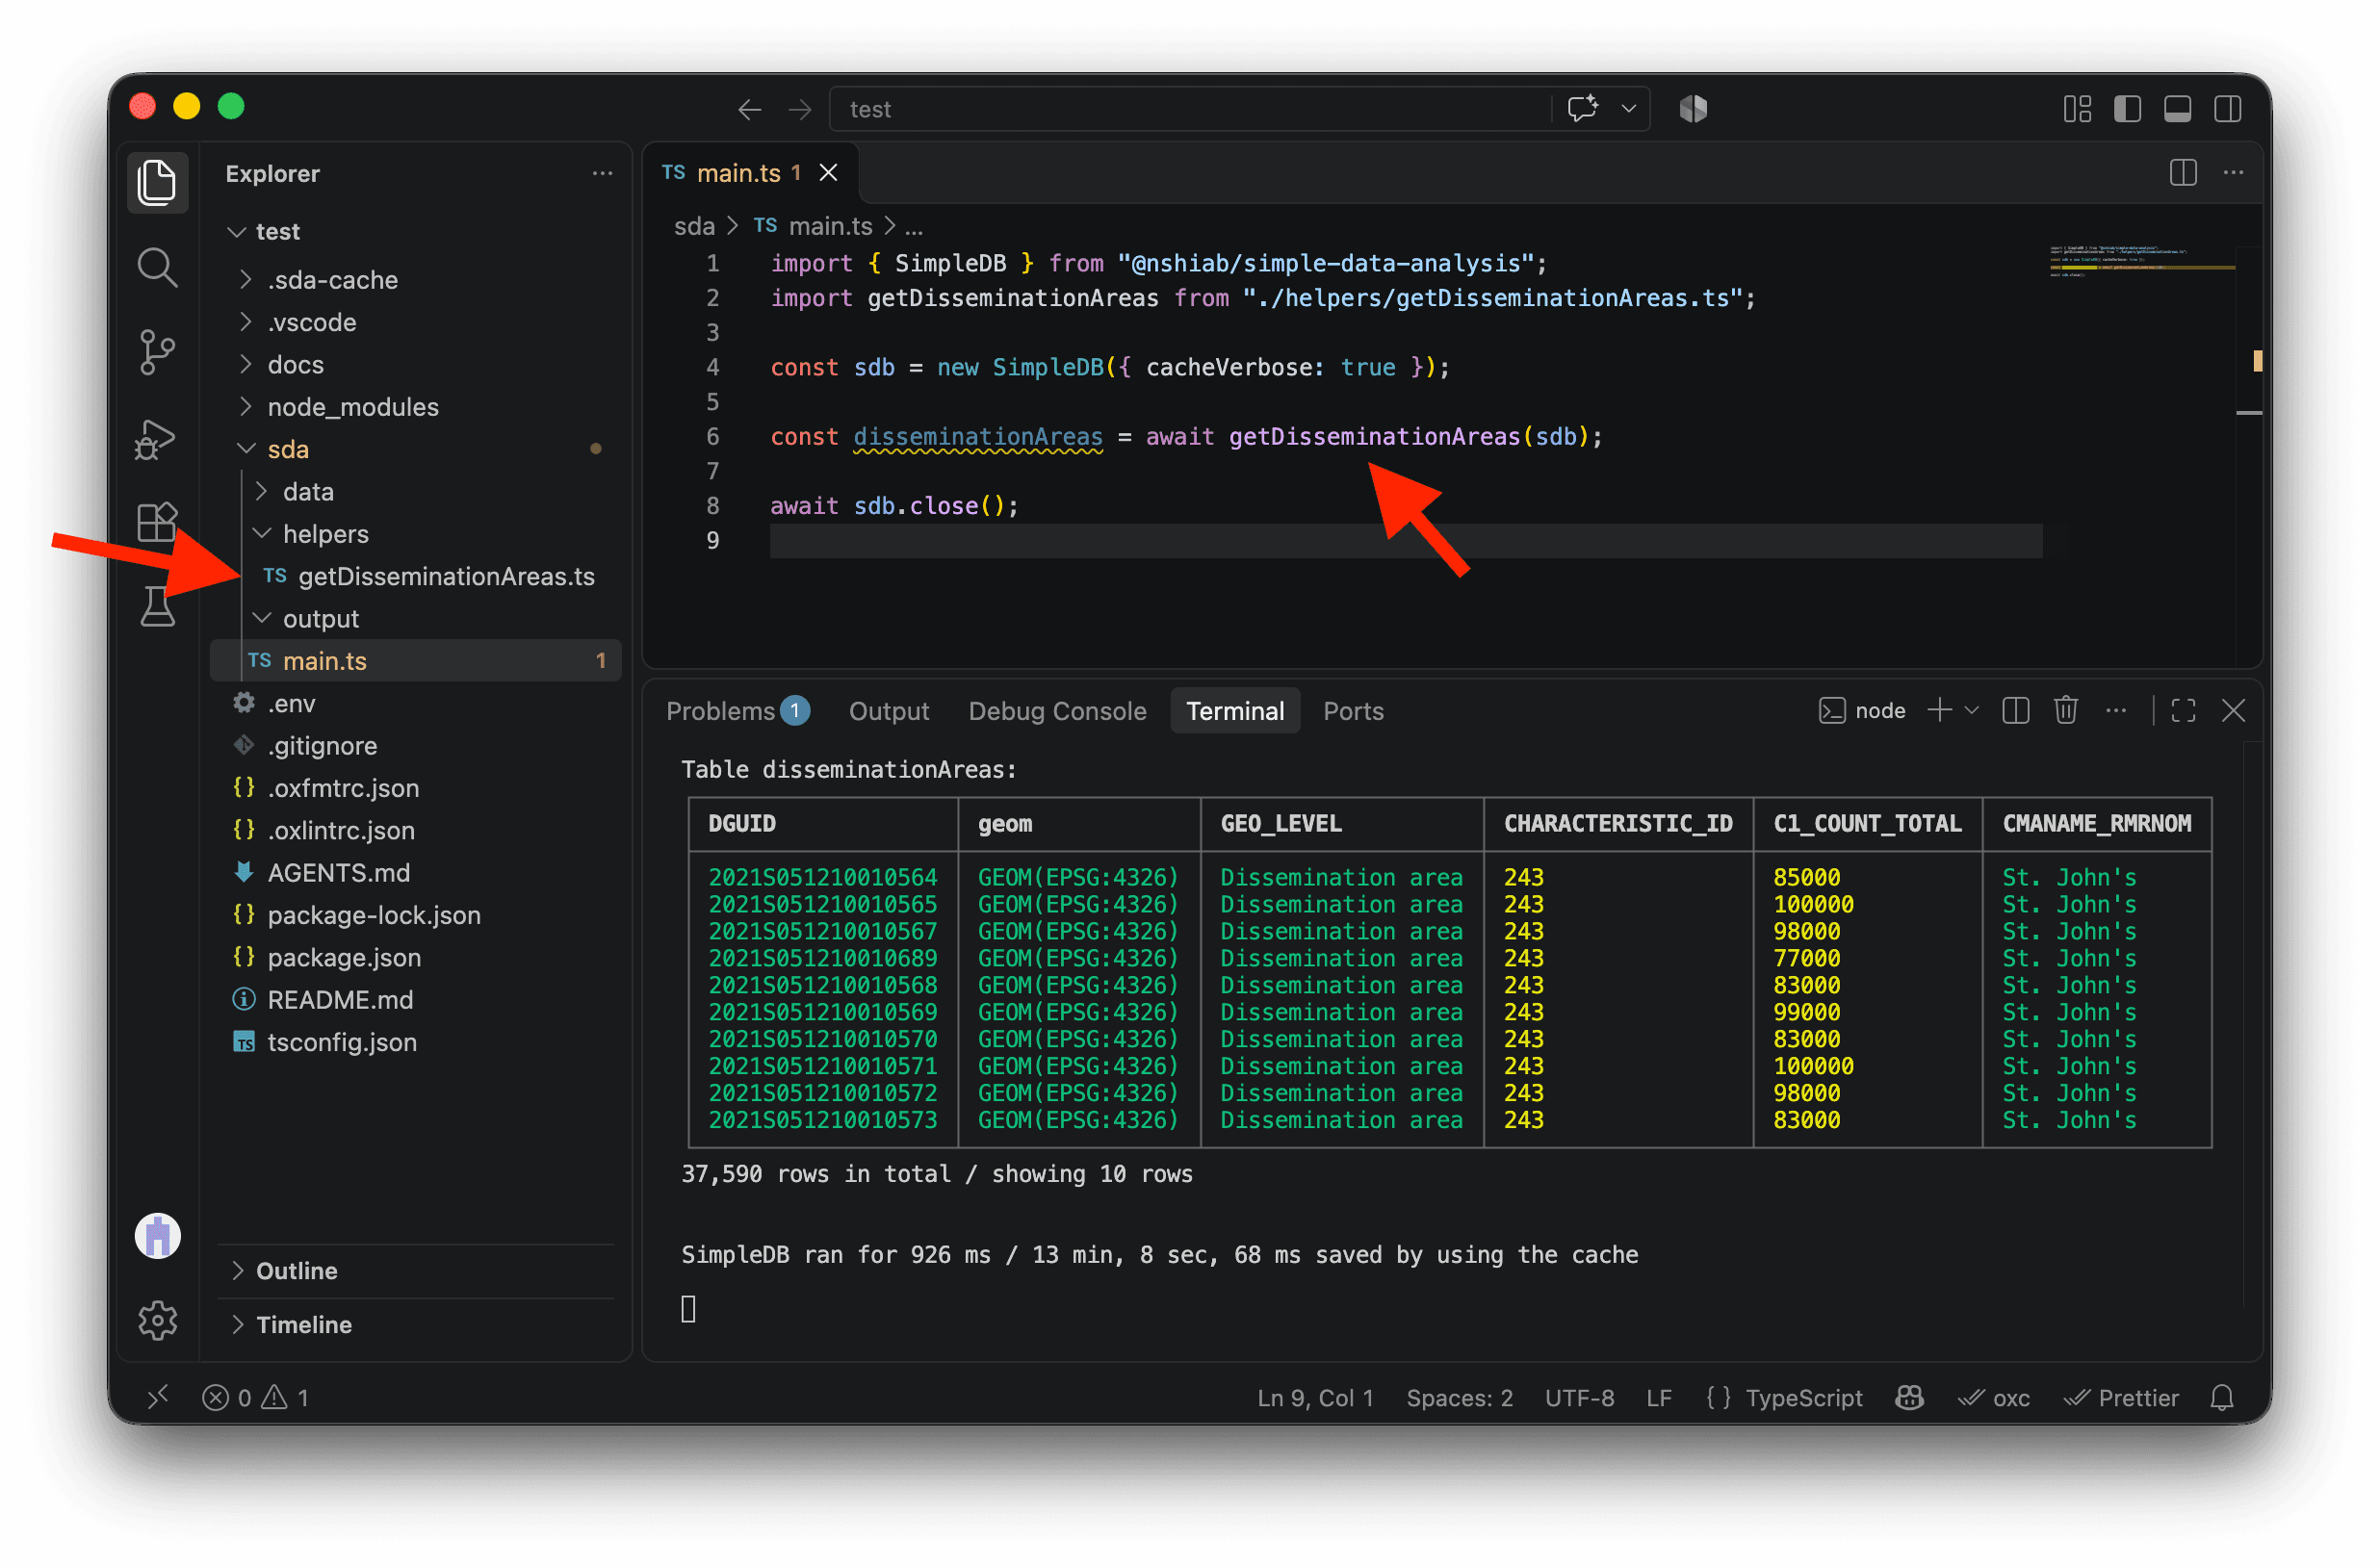
VS Code souligne disseminationAreas en jaune à la ligne 6 parce que nous n’utilisons pas cette variable dans le code actuel. Si vous remontez dans le terminal, vous verrez le même avertissement. Un avertissement laisse le code s’exécuter, alors qu’une erreur l’arrête. Cet avertissement nous aide à repérer les variables que nous pouvons supprimer pour que notre code reste facile à suivre. Nous utiliserons disseminationAreas dans la section suivante.
Répondre à la question
Maintenant que nous avons réuni les données du recensement et les géométries des aires de diffusion, nous pouvons répondre à notre question :
- Pour chaque région métropolitaine canadienne, quelles aires de diffusion ont un revenu des ménages supérieur ou inférieur à la médiane ?
Comparer les revenus à la médiane
Pour chaque aire de diffusion, nous voulons savoir de combien son revenu médian des ménages est supérieur ou inférieur à la médiane des revenus médians des aires de diffusion de sa région métropolitaine. La méthode percentChange calcule directement cet écart en pourcentage. Créez le fichier addMedianVariation.ts dans le dossier helpers.
"C1_COUNT_TOTAL"contient le revenu médian des ménages de chaque aire de diffusion.{ stat: "median", by: "CMANAME_RMRNOM" }utilise comme référence la médiane de ces valeurs dans chaque région métropolitaine."percVar"est le nom de la nouvelle colonne qui contient le résultat.base: 100exprime l’écart en pourcentage, etdecimals: 0l’arrondit à l’entier le plus proche.
import type { SimpleTable } from "@nshiab/simple-data-analysis";

export default async function addMedianVariation(disseminationAreas: SimpleTable) {
  await disseminationAreas
    .percentChange("C1_COUNT_TOTAL", { stat: "median", by: "CMANAME_RMRNOM" }, "percVar", {
      base: 100,
      decimals: 0,
    })
    .log();
}
Nous pouvons maintenant importer addMedianVariation dans main.ts et l’appeler avec notre table disseminationAreas.
import { SimpleDB } from "@nshiab/simple-data-analysis";
import getDisseminationAreas from "./helpers/getDisseminationAreas.ts";
import addMedianVariation from "./helpers/addMedianVariation.ts";

const sdb = new SimpleDB({ cacheVerbose: true });

const disseminationAreas = await getDisseminationAreas(sdb);
await addMedianVariation(disseminationAreas);

await sdb.close();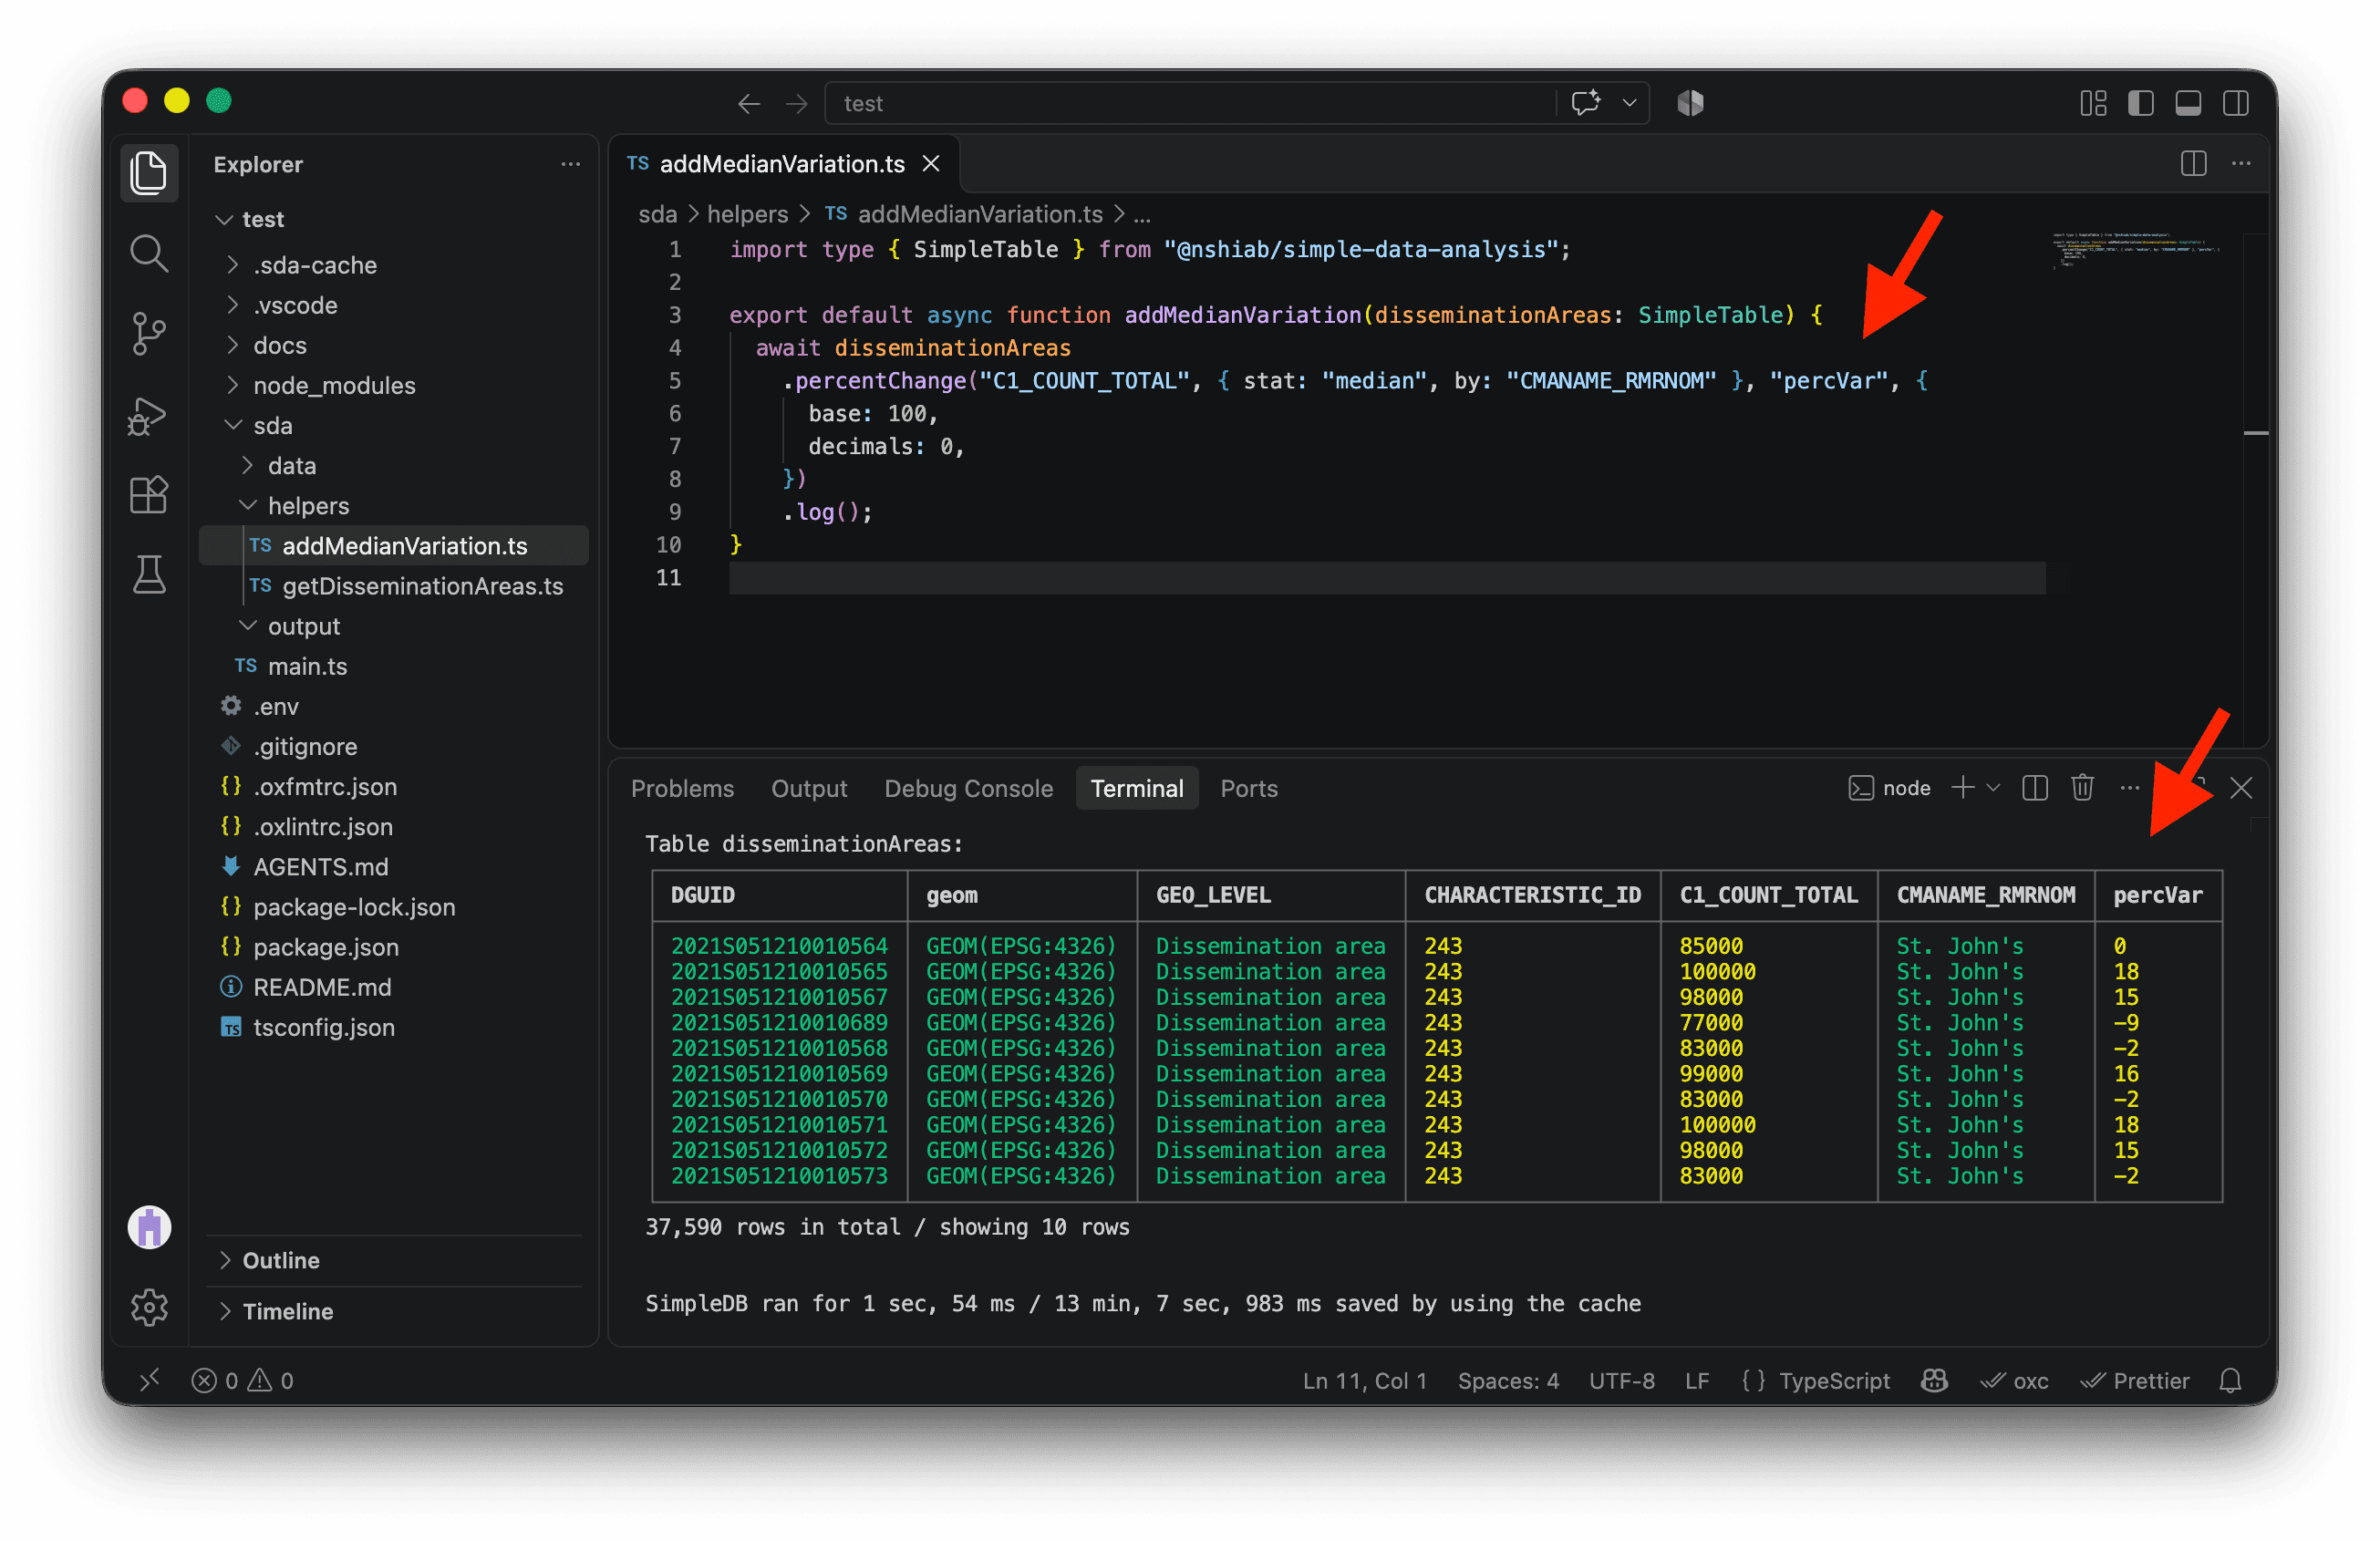
Nous avons enfin la réponse à notre question ! Pour chacune des 37 590 aires de diffusion situées dans une région métropolitaine, percVar indique si le revenu médian des ménages est supérieur ou inférieur à la médiane calculée à partir des aires de diffusion de cette région, et de combien de pour cent. Nous sommes prêts à créer une carte pour chaque région métropolitaine ! 🚀
Créer les cartes
Pour garder notre code bien organisé et notre esprit sain, créons un nouveau fichier visualizeData.ts dans helpers. C’est là que nous mettrons le code qui créera nos cartes.
La nouvelle fonction reçoit notre table disseminationAreas sous forme de SimpleTable. Pour l’instant, elle affiche simplement un message dans le terminal.
import type { SimpleTable } from "@nshiab/simple-data-analysis";

export default async function visualizeData(
  disseminationAreas: SimpleTable,
) {
  console.log("\nVisualizing dissemination areas data...");
}
Importons et appelons maintenant visualizeData dans main.ts.
import { SimpleDB } from "@nshiab/simple-data-analysis";
import getDisseminationAreas from "./helpers/getDisseminationAreas.ts";
import addMedianVariation from "./helpers/addMedianVariation.ts";
import visualizeData from "./helpers/visualizeData.ts";

const sdb = new SimpleDB({ cacheVerbose: true });

const disseminationAreas = await getDisseminationAreas(sdb);
await addMedianVariation(disseminationAreas);
await visualizeData(disseminationAreas);

await sdb.close();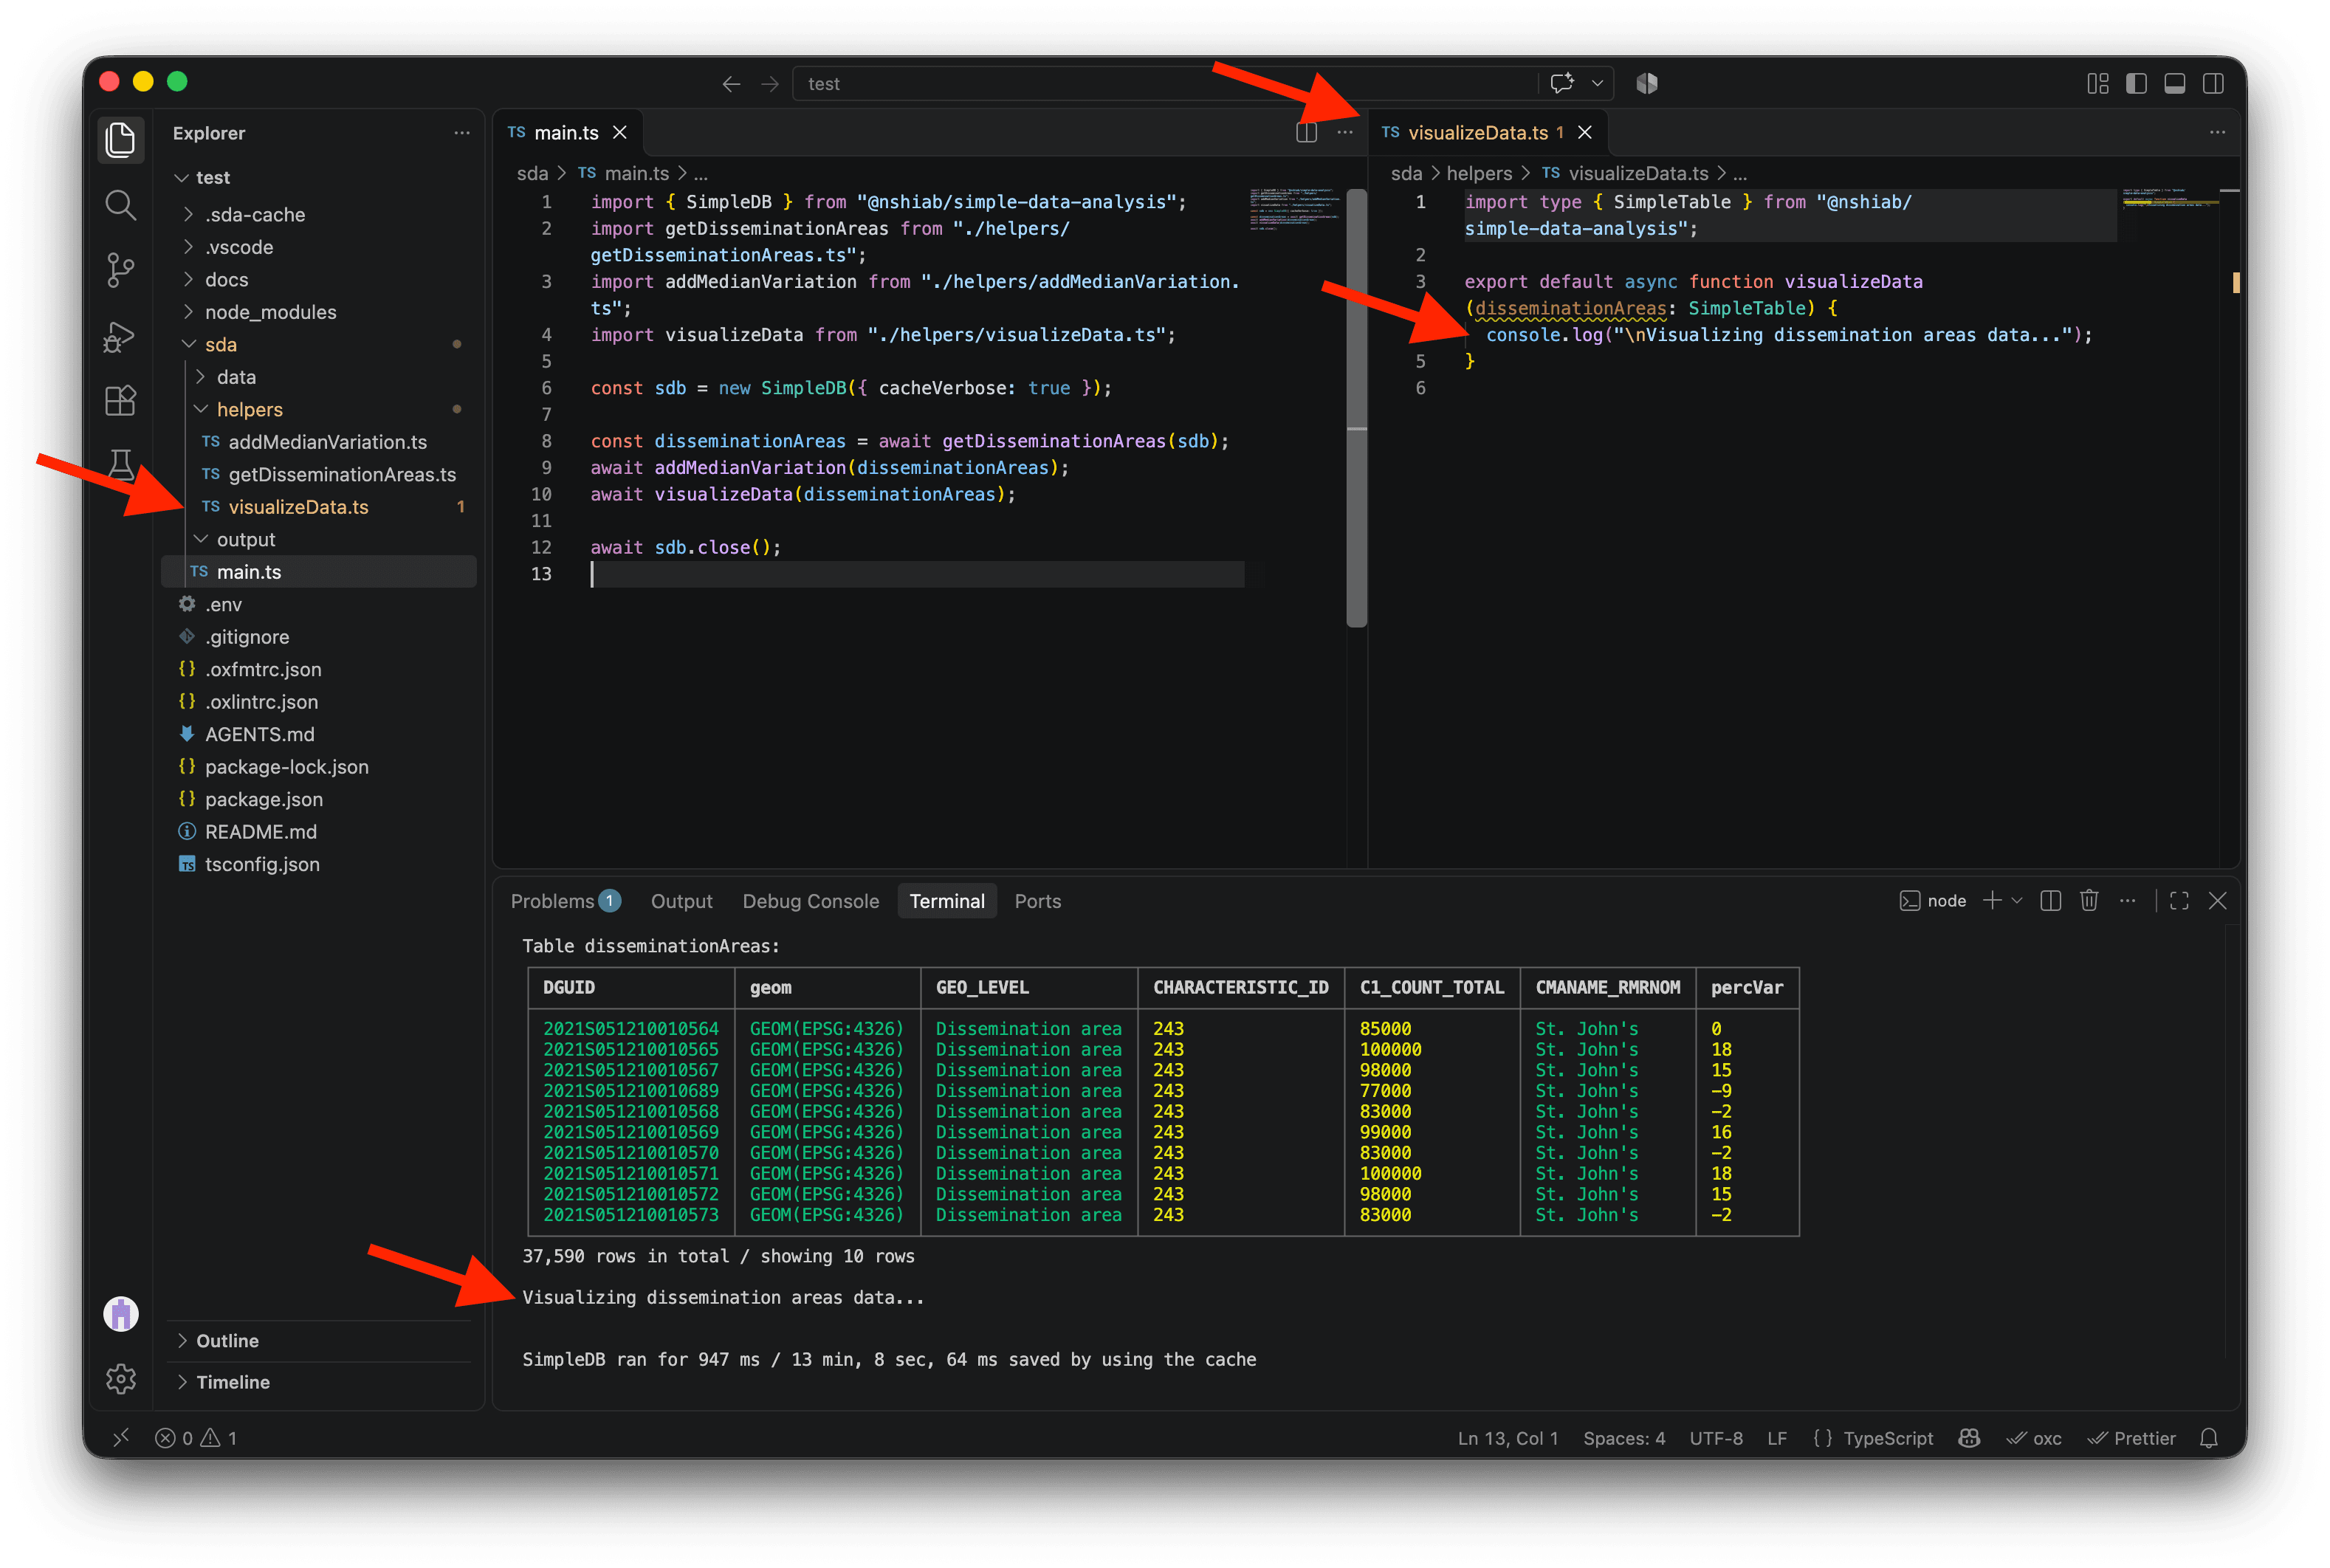
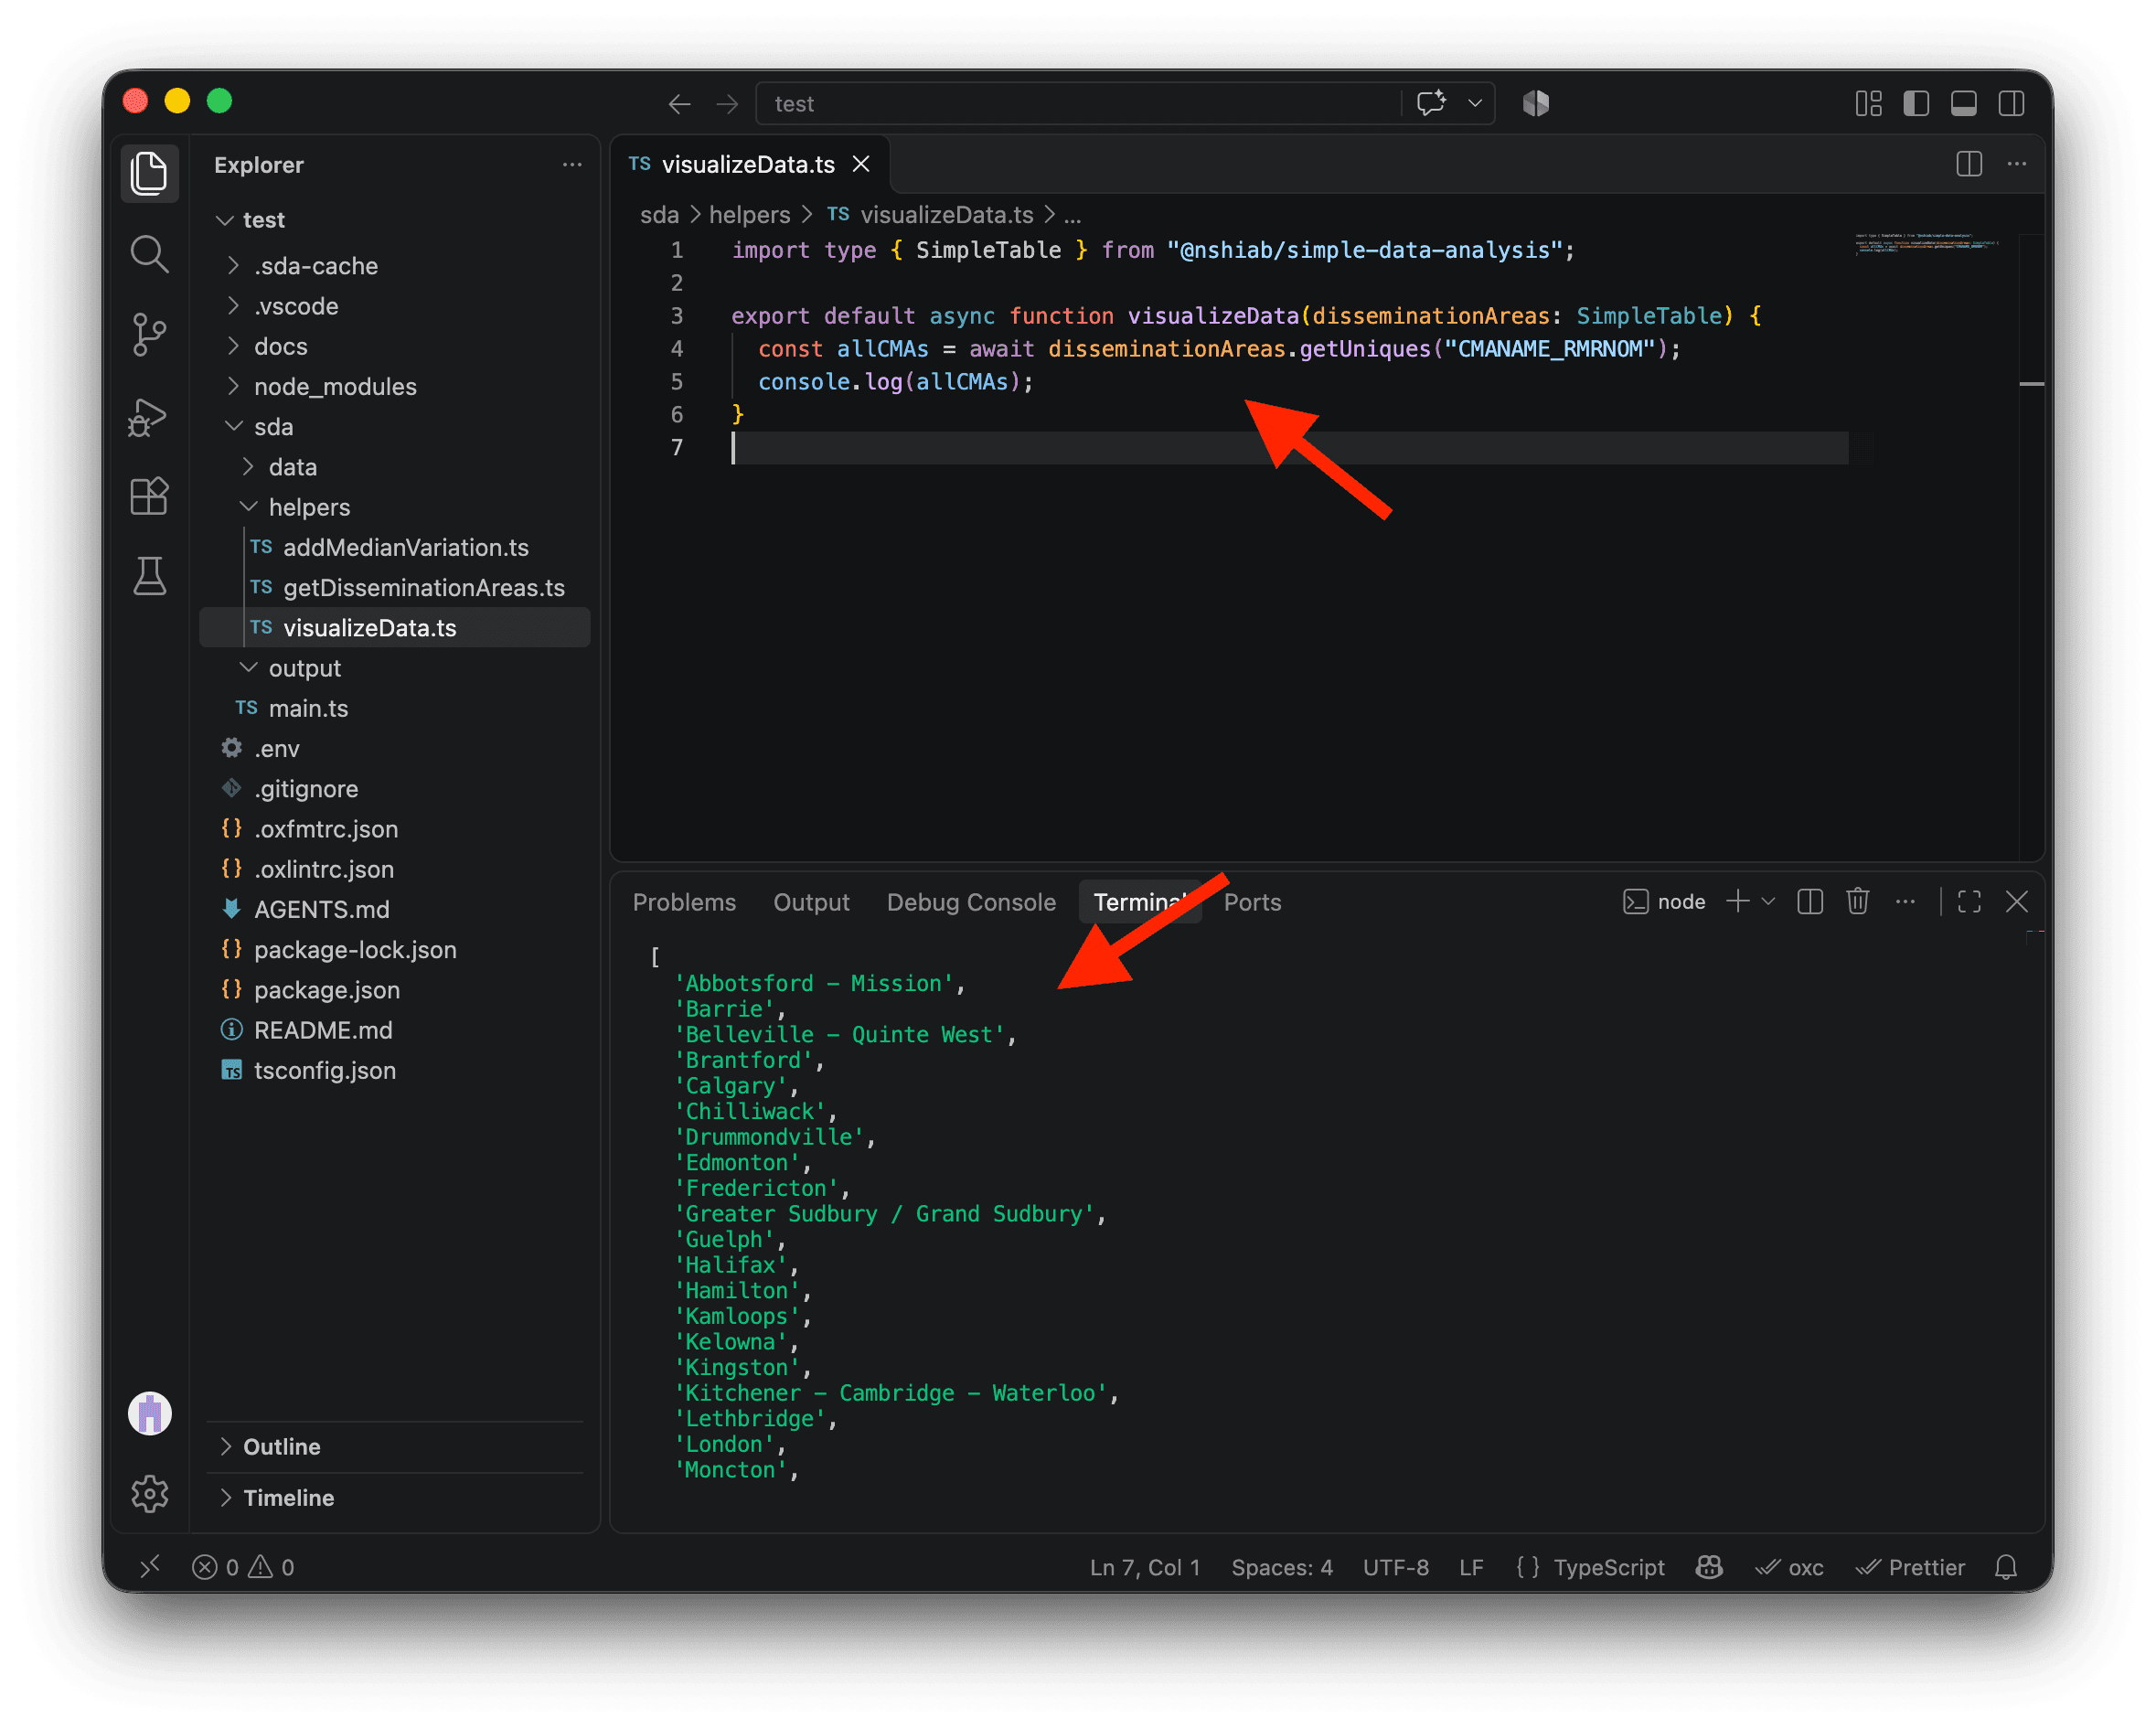
Nous voulons créer une carte par région métropolitaine. Commençons par récupérer tous les noms de régions métropolitaines uniques avec getUniques. L’affichage de allCMAs montre la liste que nous utiliserons pour parcourir les régions et créer une carte pour chacune.
import type { SimpleTable } from "@nshiab/simple-data-analysis";

export default async function visualizeData(
  disseminationAreas: SimpleTable,
) {
  const allCMAs = await disseminationAreas.getUniques("CMANAME_RMRNOM");
  console.log(allCMAs);
}
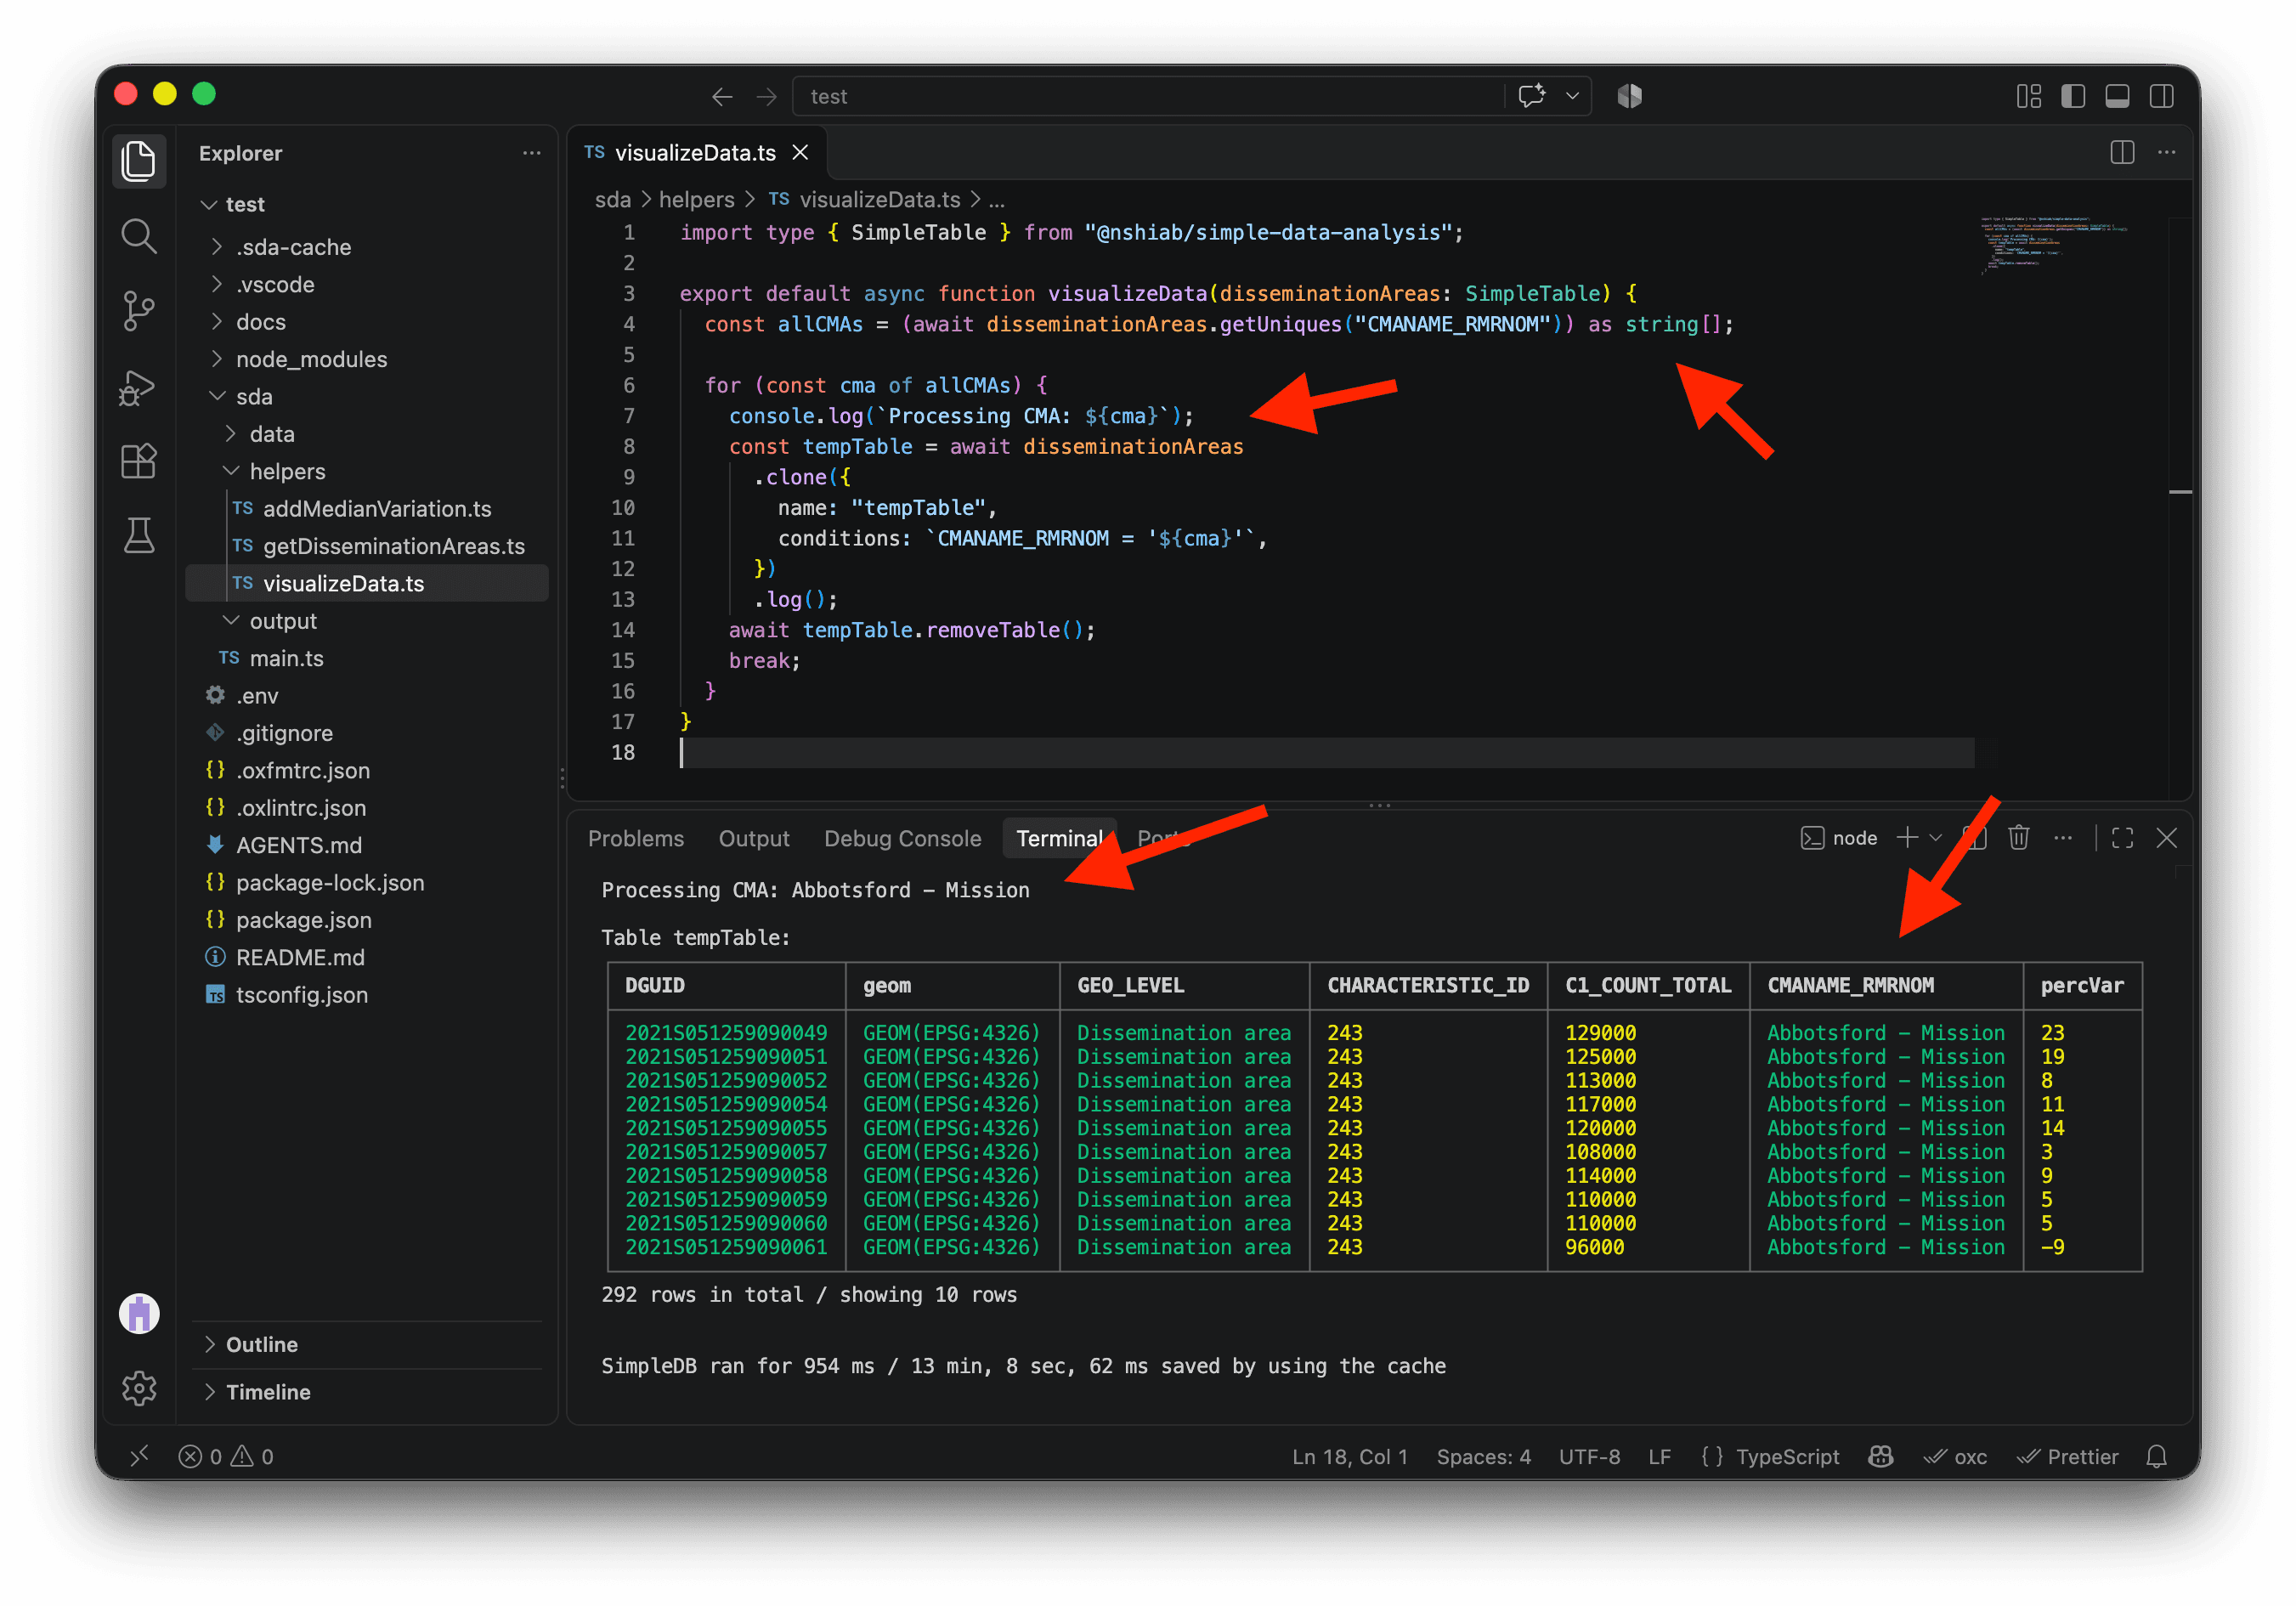
Nous pouvons maintenant parcourir les régions métropolitaines une à une. Dans le code ci-dessous, nous affichons le nom de la RMR en cours de traitement. Puis nous clonons disseminationAreas dans une table temporaire en utilisant conditions pour ne garder que les lignes de cette région, et nous affichons le résultat.
À la fin de chaque itération, nous supprimons tempTable pour que la suivante reparte à neuf. Pour l’instant, break à la ligne 17 arrête la boucle après la première RMR. Une fois que la carte fonctionnera pour une région, nous retirerons cette instruction pour toutes les traiter.
import type { SimpleTable } from "@nshiab/simple-data-analysis";

export default async function visualizeData(
  disseminationAreas: SimpleTable,
) {
  const allCMAs = (await disseminationAreas.getUniques("CMANAME_RMRNOM")) as string[];

  for (const cma of allCMAs) {
    console.log(`Processing CMA: ${cma}`);
    const tempTable = await disseminationAreas
      .clone({
        name: "tempTable",
        conditions: `CMANAME_RMRNOM = '${cma}'`,
      })
      .log();
    await tempTable.removeTable();
    break;
  }
}On donne un petit coup de pouce à TypeScript à la ligne 6 en ajoutant as string[]. On a vu dans le terminal que getUniques nous donne une liste de noms de RMR. On indique donc à TypeScript que ce sont des chaînes de caractères. On peut ainsi insérer cma dans les chaînes des lignes 9 et 13 sans avertissement.
Comme vous pouvez le voir, la première région métropolitaine traitée est Abbotsford–Mission. La table temporaire ne contient que 292 lignes, toutes pour cette région.
Nous pouvons maintenant dessiner notre première carte. Quand nous avons exécuté setup-data-project, Plot a été installé automatiquement. Cette librairie de visualisation fonctionne bien avec SDA et nous aidera à dessiner la carte.
Avec writeMap et les fonctions plot et geo de Plot, nous dessinons les frontières des aires de diffusion. En donnant la valeur percVar à fill, nous colorons chaque aire selon son écart en pourcentage par rapport à la médiane de la région métropolitaine.
import type { SimpleTable } from "@nshiab/simple-data-analysis";
import { geo, plot } from "@observablehq/plot";

export default async function visualizeData(
  disseminationAreas: SimpleTable,
) {
  const allCMAs = (await disseminationAreas.getUniques("CMANAME_RMRNOM")) as string[];

  for (const cma of allCMAs) {
    console.log(`Processing CMA: ${cma}`);

    const tempTable = await disseminationAreas
      .clone({
        name: "tempTable",
        conditions: `CMANAME_RMRNOM = '${cma}'`,
      })
      .writeMap(
        (geoData) =>
          plot({
            marks: [
              geo(geoData, {
                fill: "percVar",
              }),
            ],
          }),
        `./sda/output/${cma}.png`,
      );

    await tempTable.removeTable();
    break;
  }
}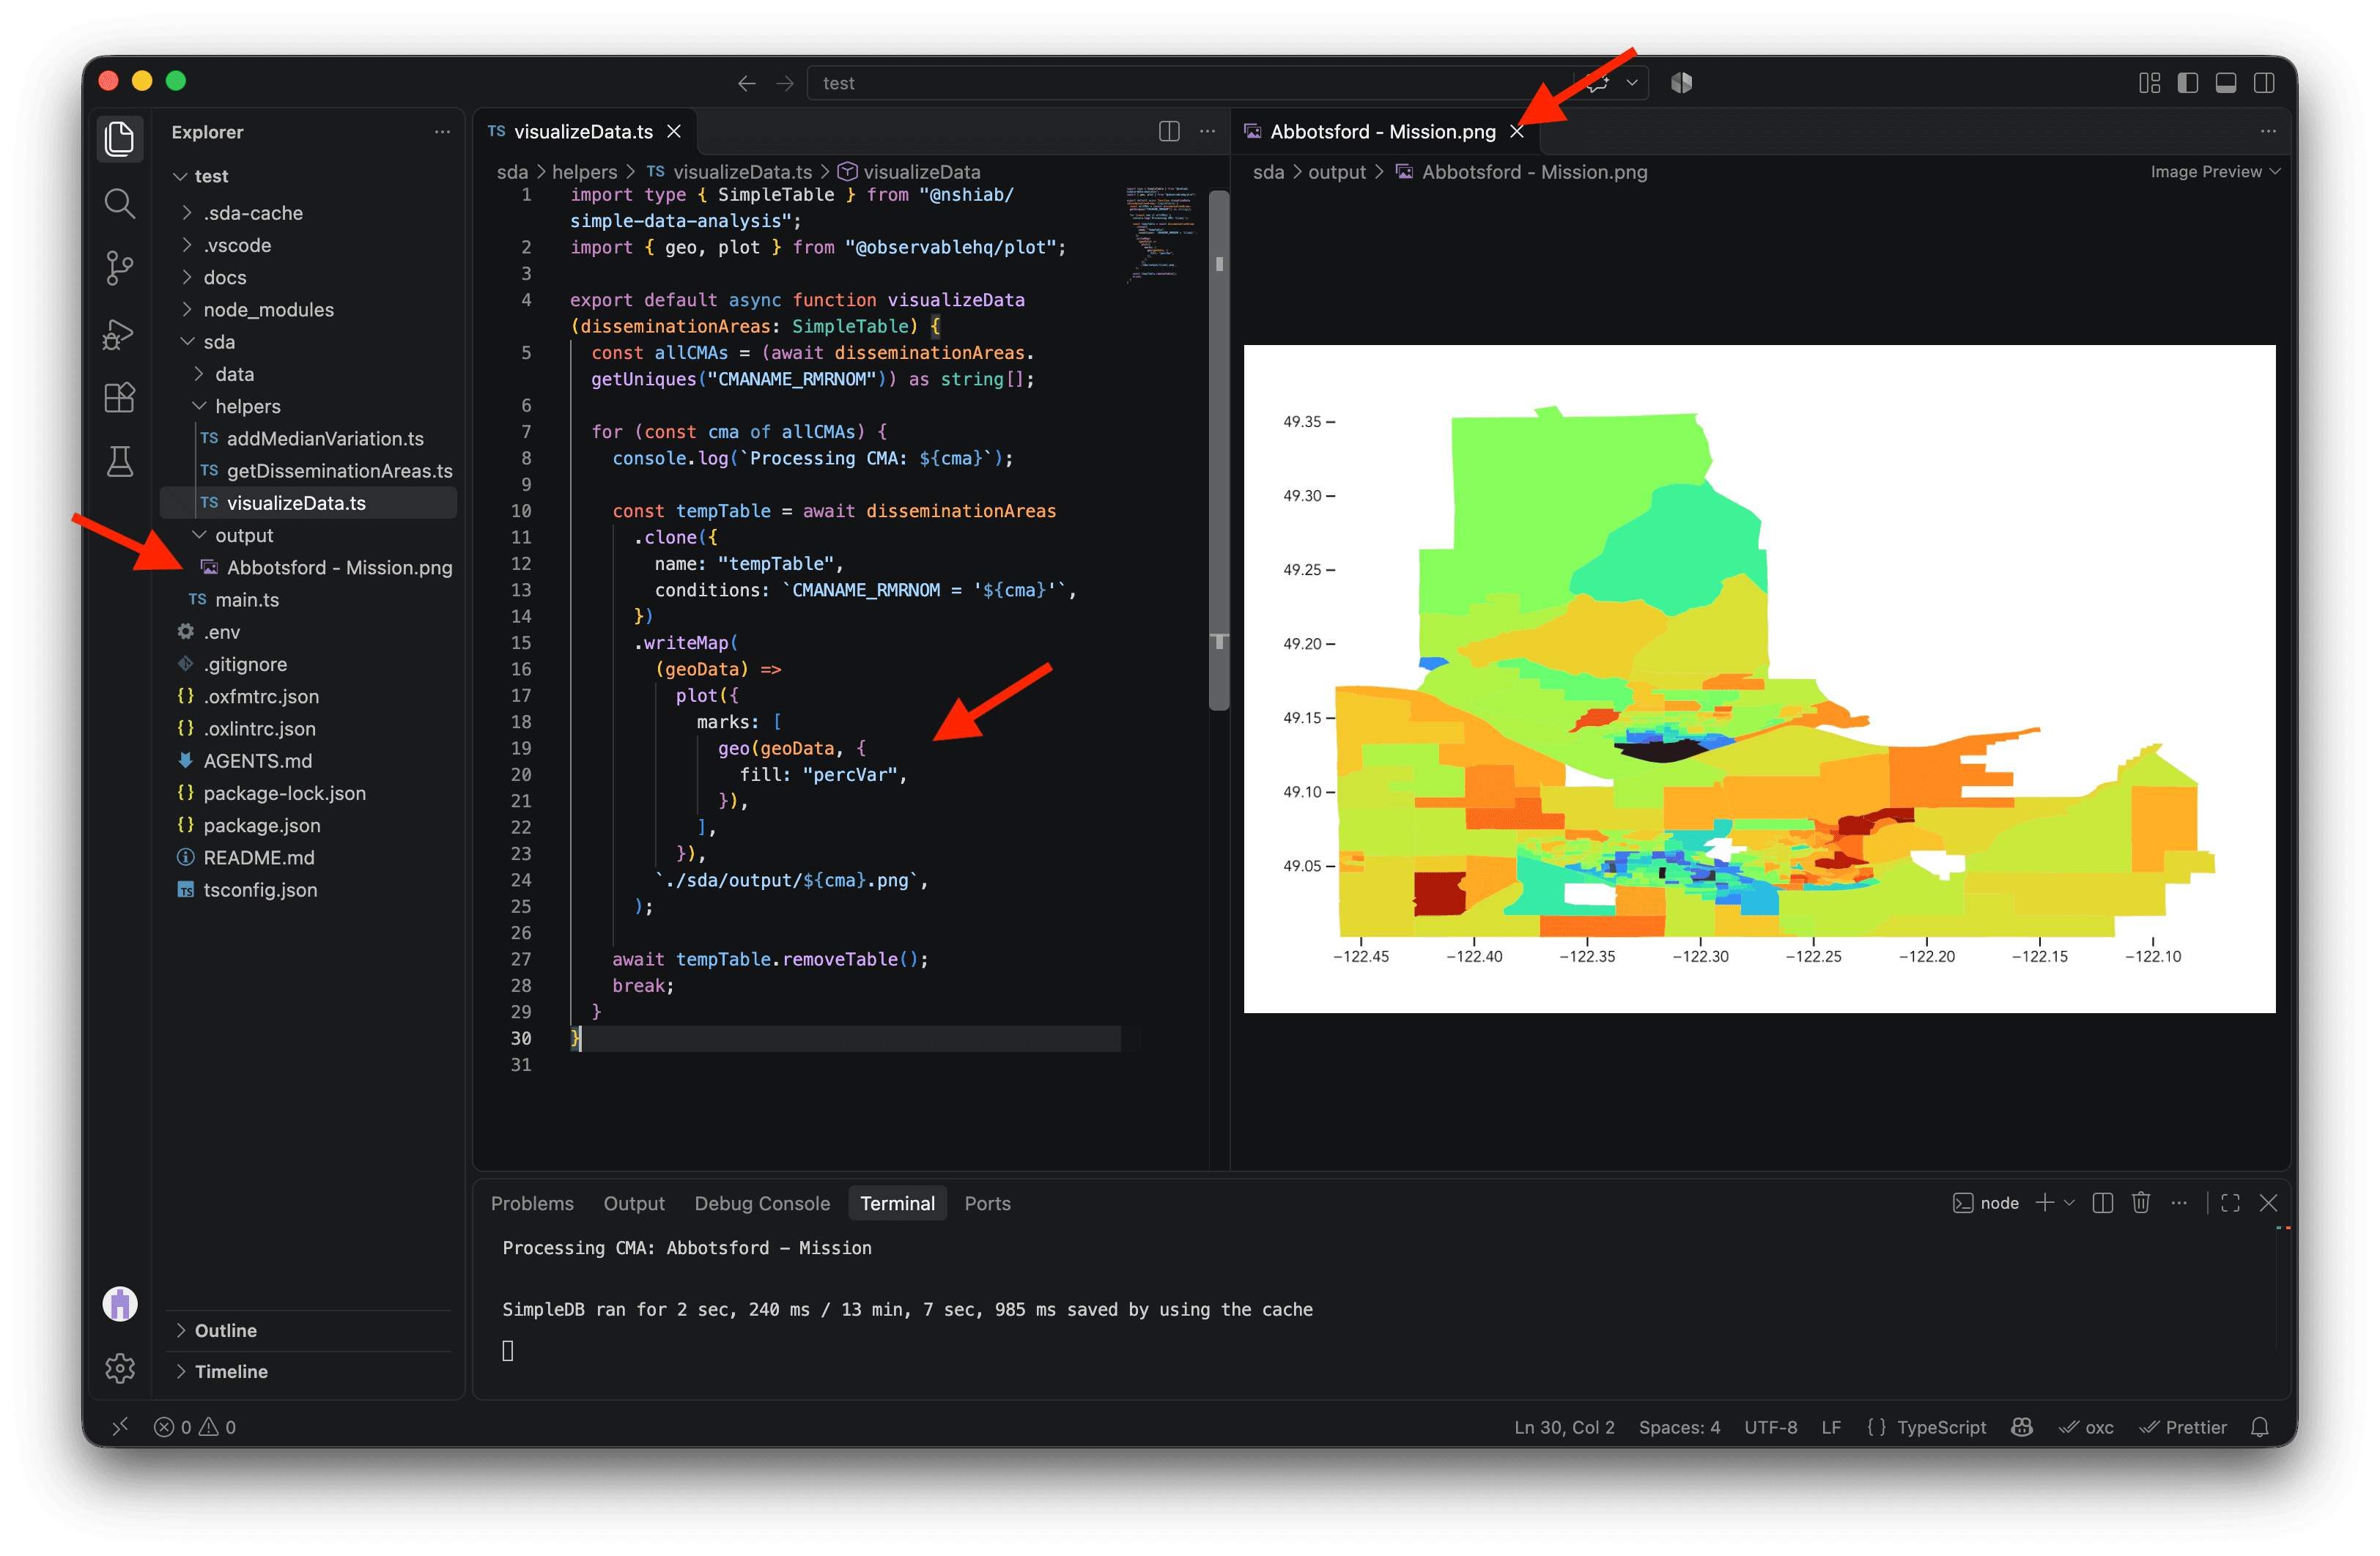
C’est laid, mais ça fonctionne !
Nous pouvons maintenant ajouter un titre, un sous-titre, une légende de source, une échelle de couleurs divergente et une projection. Dans certaines aires de diffusion, les revenus dépassent la médiane régionale de 200 %, 300 % ou même 400 %, ce qui peut masquer les écarts plus faibles. En fixant le domaine des couleurs à [-100, 100], nous gardons une échelle utile : les valeurs supérieures à +100 % utilisent la couleur positive la plus intense. Pour en savoir plus sur ces réglages, consultez la leçon Visualiser des données.
import type { SimpleTable } from "@nshiab/simple-data-analysis";
import { geo, plot } from "@observablehq/plot";

export default async function visualizeData(
  disseminationAreas: SimpleTable,
) {
  const allCMAs = (await disseminationAreas.getUniques("CMANAME_RMRNOM")) as string[];

  for (const cma of allCMAs) {
    console.log(`Processing CMA: ${cma}`);

    const tempTable = await disseminationAreas
      .clone({
        name: "tempTable",
        conditions: `CMANAME_RMRNOM = '${cma}'`,
      })
      .writeMap(
        (geoData) =>
          plot({
            title: cma,
            subtitle:
              "Variation from the median household total income at the dissemination area level.",
            caption: "2021 Census, Statistics Canada",
            projection: {
              type: "mercator",
              domain: geoData,
            },
            color: {
              legend: true,
              type: "diverging",
              domain: [-100, 100],
              ticks: 5,
              tickFormat: (d) => {
                if (d > 0) {
                  return `+${d}%`;
                }
                return `${d}%`;
              },
              label: null,
            },
            marks: [
              geo(geoData, {
                fill: "percVar",
              }),
            ],
          }),
        `./sda/output/${cma}.png`,
      );

    await tempTable.removeTable();
    break;
  }
}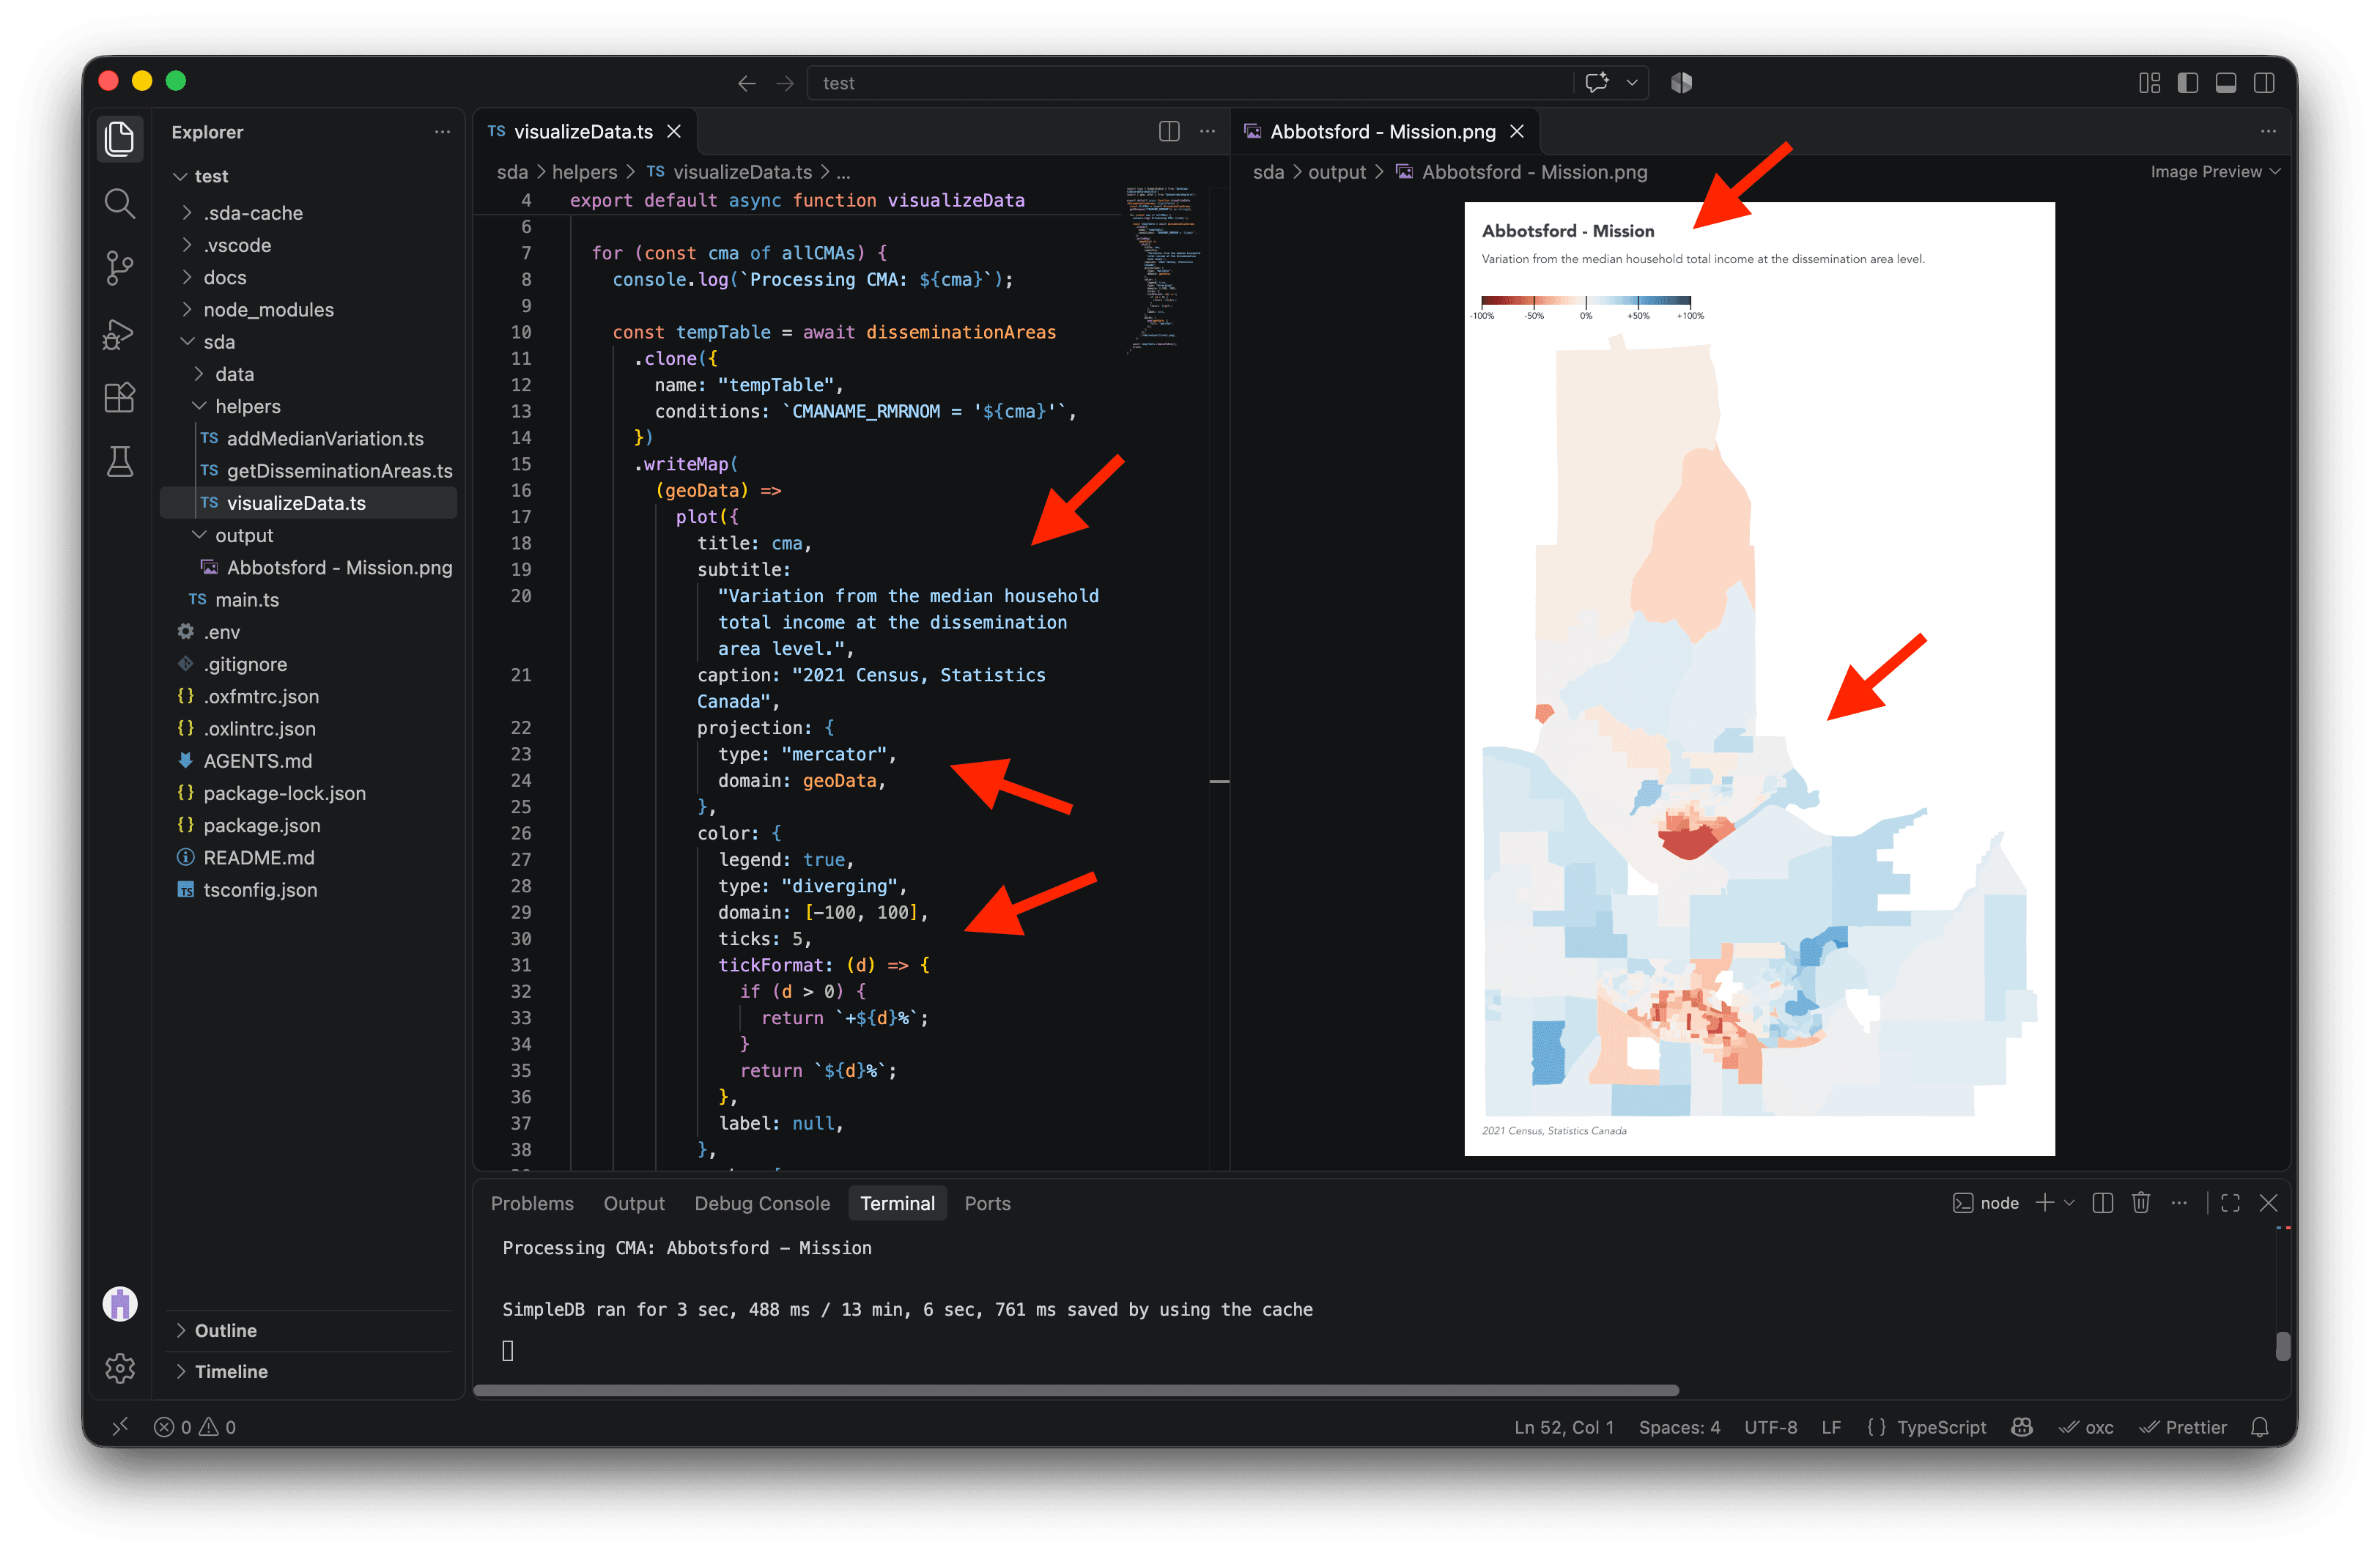
C’est déjà beaucoup mieux ! 💅
Une dernière touche : ajoutons un contour à la région métropolitaine. Dans le nouveau code ci-dessous, nous clonons tempTable dans la boucle pour créer une table outline. La méthode aggregateGeo("union") fusionne les géométries des aires de diffusion en un seul polygone, ce qui laisse une ligne avec la frontière de la région métropolitaine.
Nous utilisons ensuite insertTables pour ajouter cette ligne à tempTable. L’option unifyColumns est nécessaire parce que outline ne possède qu’une colonne geom, tandis que tempTable contient aussi les colonnes du recensement. Dans writeMap, un deuxième appel à geo sélectionne l’entité dont percVar vaut null, soit notre contour, et la trace en noir avec une légère transparence.
Nous supprimons aussi la table outline après avoir écrit la carte, afin d’en créer une nouvelle à chaque itération de la boucle.
Si ces étapes vous semblent complexes, je vous encourage à revoir la leçon Visualiser des données avant de continuer.
import type { SimpleTable } from "@nshiab/simple-data-analysis";
import { geo, plot } from "@observablehq/plot";

export default async function visualizeData(
  disseminationAreas: SimpleTable,
) {
  const allCMAs = (await disseminationAreas.getUniques("CMANAME_RMRNOM")) as string[];

  for (const cma of allCMAs) {
    console.log(`Processing CMA: ${cma}`);

    const tempTable = await disseminationAreas
      .clone({
        name: "tempTable",
        conditions: `CMANAME_RMRNOM = '${cma}'`,
      });

    const outline = tempTable
      .clone("outline")
      .aggregateGeo("union");

    tempTable.insertTables(outline, { unifyColumns: true });

    await tempTable.writeMap(
      (geoData) =>
        plot({
          title: cma,
          subtitle:
            "Variation from the median household total income at the dissemination area level.",
          caption: "2021 Census, Statistics Canada",
          projection: {
            type: "mercator",
            domain: geoData,
          },
          color: {
            legend: true,
            type: "diverging",
            domain: [-100, 100],
            ticks: 5,
            tickFormat: (d) => {
              if (d > 0) {
                return `+${d}%`;
              }
              return `${d}%`;
            },
            label: null,
          },
          marks: [
            geo(geoData, {
              fill: "percVar",
            }),
            geo(geoData.features.filter((d) => d.properties.percVar === null), {
              stroke: "black",
              strokeOpacity: 0.5,
            }),
          ],
        }),
      `./sda/output/${cma}.png`,
    );

    await outline.removeTable();
    await tempTable.removeTable();
    break;
  }
}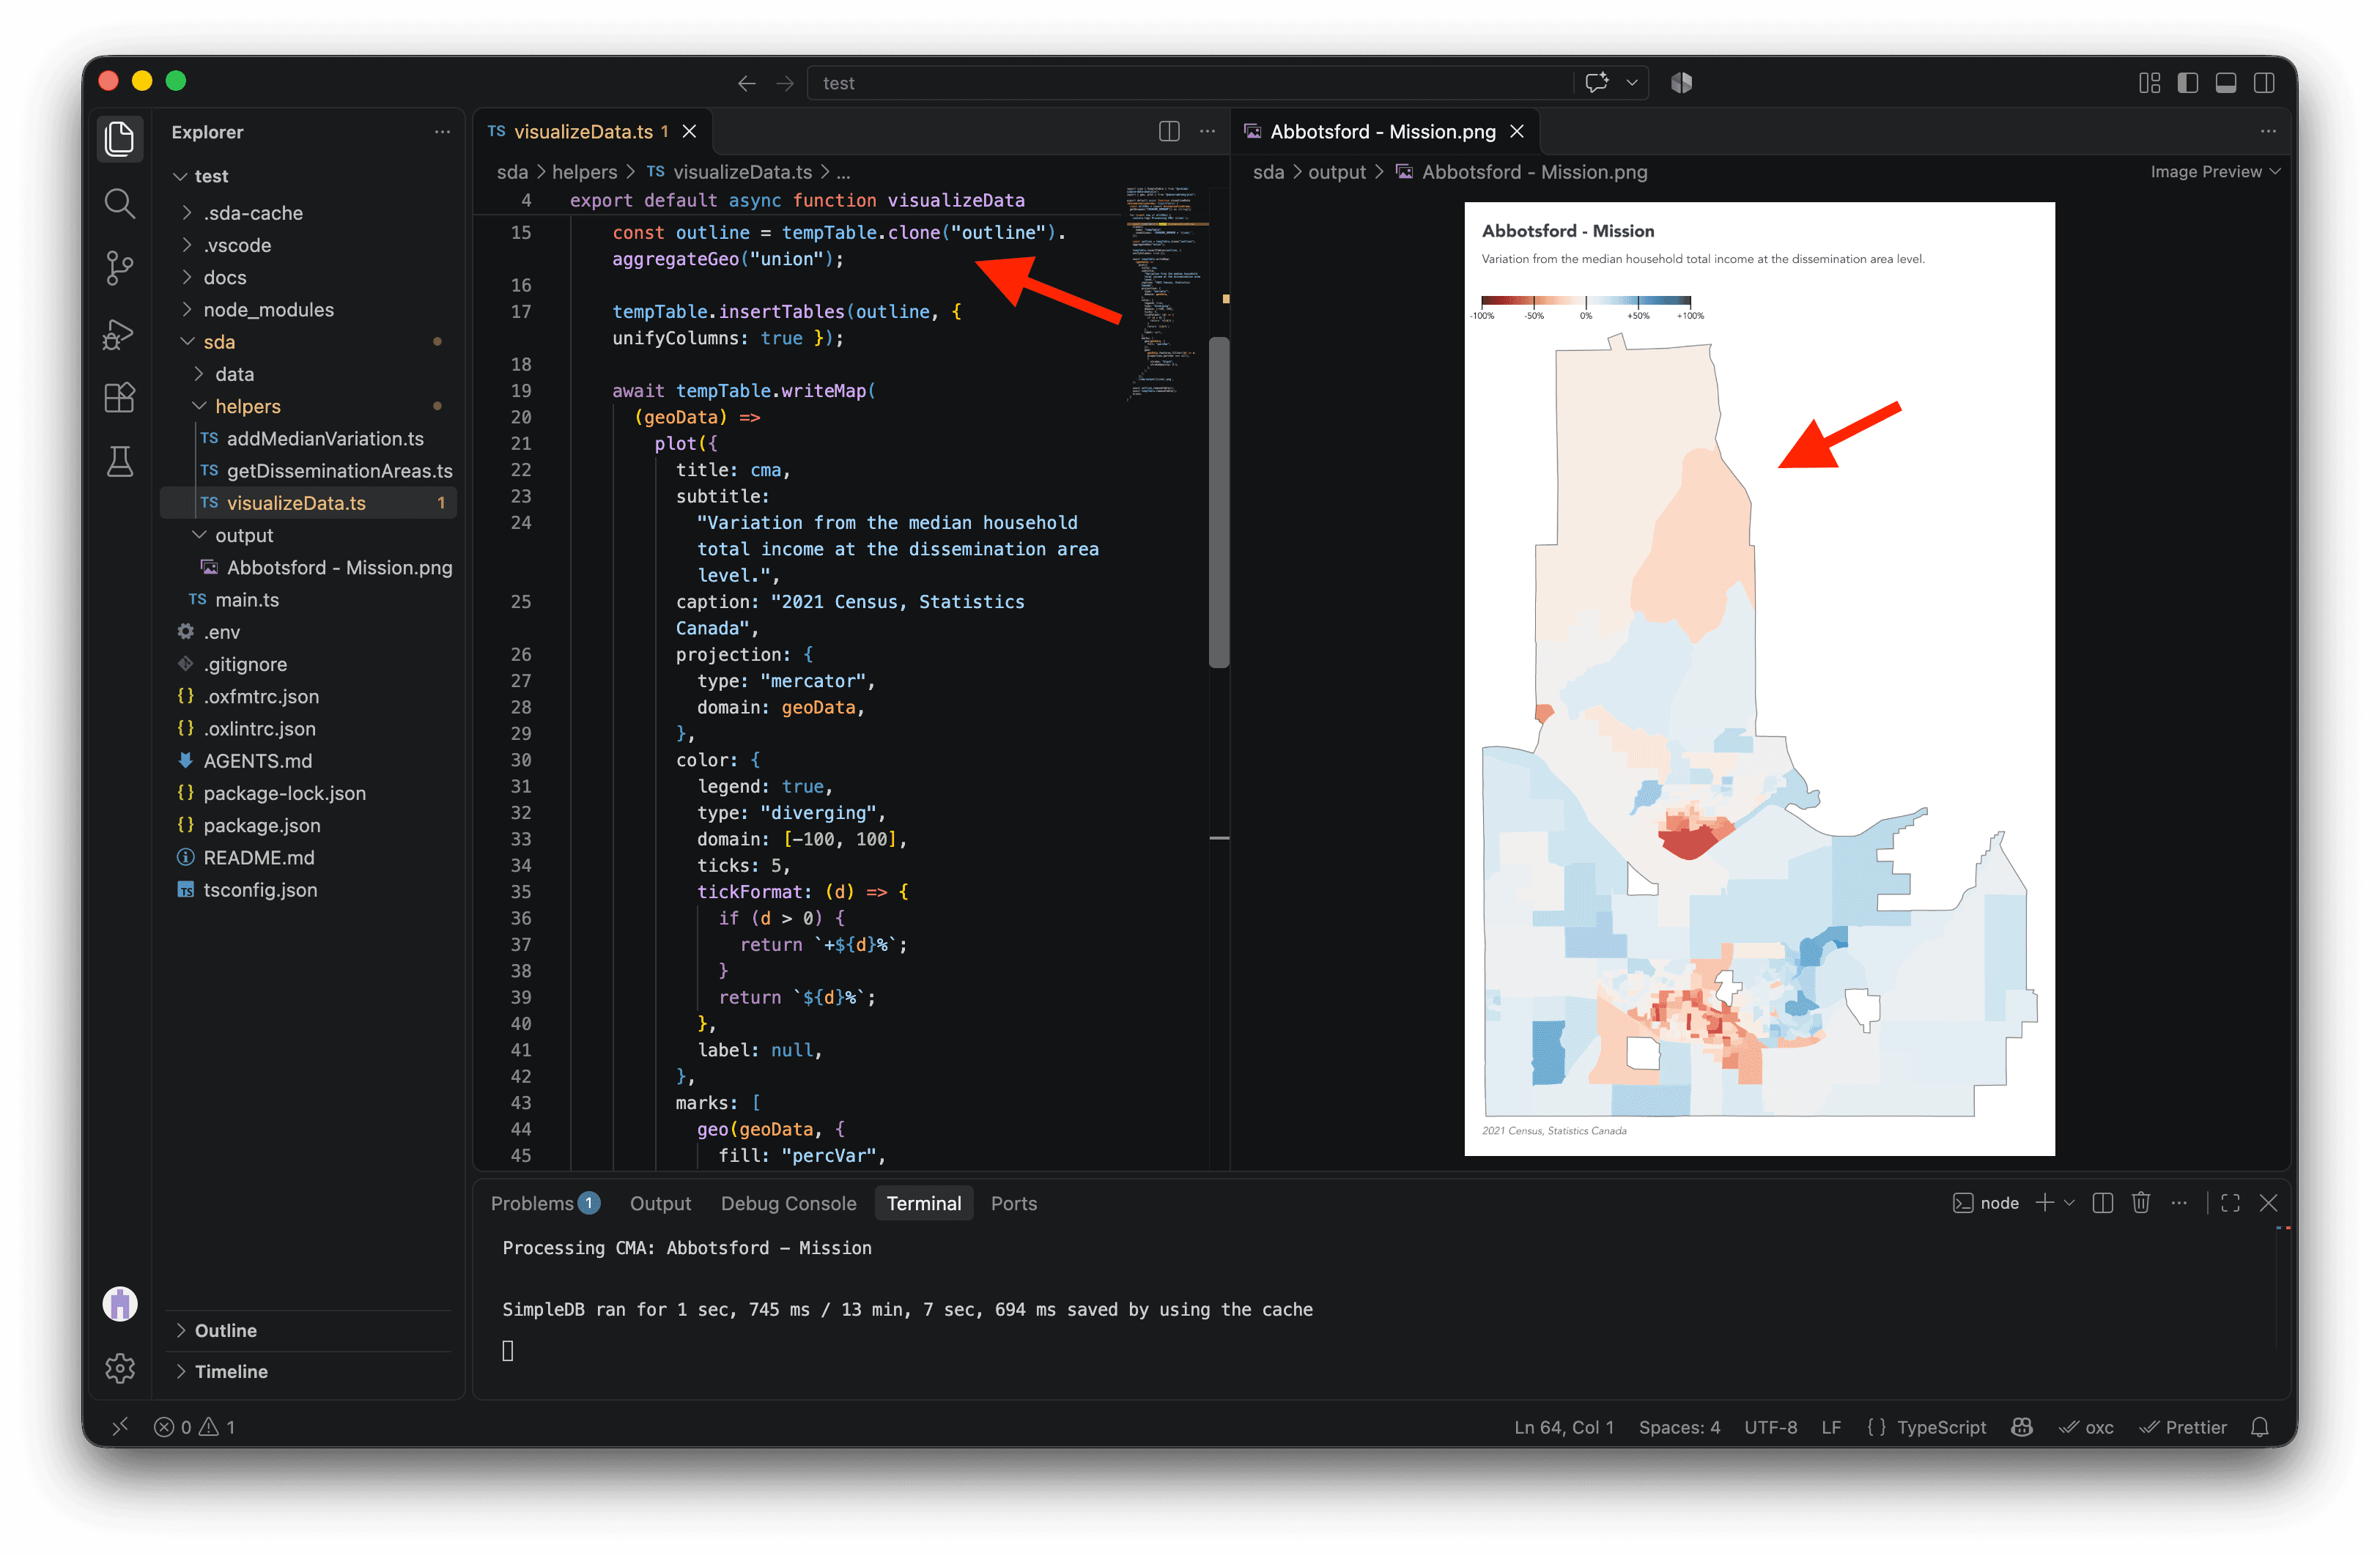
La différence est subtile, mais le contour aide à voir les trous dans la géométrie de la région métropolitaine. Il rend aussi la frontière visible quand les aires de diffusion près du bord sont blanches ou presque blanches.
Nous sommes presque prêts à retirer break et à créer les cartes de toutes les régions métropolitaines. Mais d’abord, nous devons nettoyer le nom de la RMR utilisé dans le chemin du fichier de sortie. Un nom comme Greater Sudbury / Grand Sudbury contient /, ce qui créerait un dossier indésirable dans ./sda/output/${cma}.png au lieu d’un seul fichier image.
Ensuite, nous devons échapper les apostrophes dans les noms de RMR comme St. John's. Comme la condition SQL entoure le nom d’apostrophes, toute apostrophe à l’intérieur du nom doit être doublée.
Dans le code ci-dessous, nous utilisons replaceAll pour ces deux corrections. Nous retirons aussi break pour que la boucle crée une carte pour chaque région métropolitaine.
import type { SimpleTable } from "@nshiab/simple-data-analysis";
import { geo, plot } from "@observablehq/plot";

export default async function visualizeData(
  disseminationAreas: SimpleTable,
) {
  const allCMAs = (await disseminationAreas.getUniques("CMANAME_RMRNOM")) as string[];

  for (const cma of allCMAs) {
    console.log(`Processing CMA: ${cma}`);

    const tempTable = disseminationAreas
      .clone({
        name: "tempTable",
        conditions: `CMANAME_RMRNOM = '${cma.replaceAll("'", "''")}'`,
      });

    const outline = tempTable
      .clone("outline")
      .aggregateGeo("union");

    tempTable.insertTables(outline, { unifyColumns: true });

    await tempTable.writeMap(
      (geoData) =>
        plot({
          title: cma,
          subtitle:
            "Variation from the median household total income at the dissemination area level.",
          caption: "2021 Census, Statistics Canada",
          projection: {
            type: "mercator",
            domain: geoData,
          },
          color: {
            legend: true,
            type: "diverging",
            domain: [-100, 100],
            ticks: 5,
            tickFormat: (d) => {
              if (d > 0) {
                return `+${d}%`;
              }
              return `${d}%`;
            },
            label: null,
          },
          marks: [
            geo(geoData, {
              fill: "percVar",
            }),
            geo(geoData.features.filter((d) => d.properties.percVar === null), {
              stroke: "black",
              strokeOpacity: 0.5,
            }),
          ],
        }),
      `./sda/output/${cma.replaceAll("/", "_")}.png`,
    );

    await outline.removeTable();
    await tempTable.removeTable();
  }
}
Cependant, ce code traite les premières régions métropolitaines, puis échoue pour Calgary. Le message d’erreur laisse croire que certaines géométries d’entrée sont invalides. 🤔
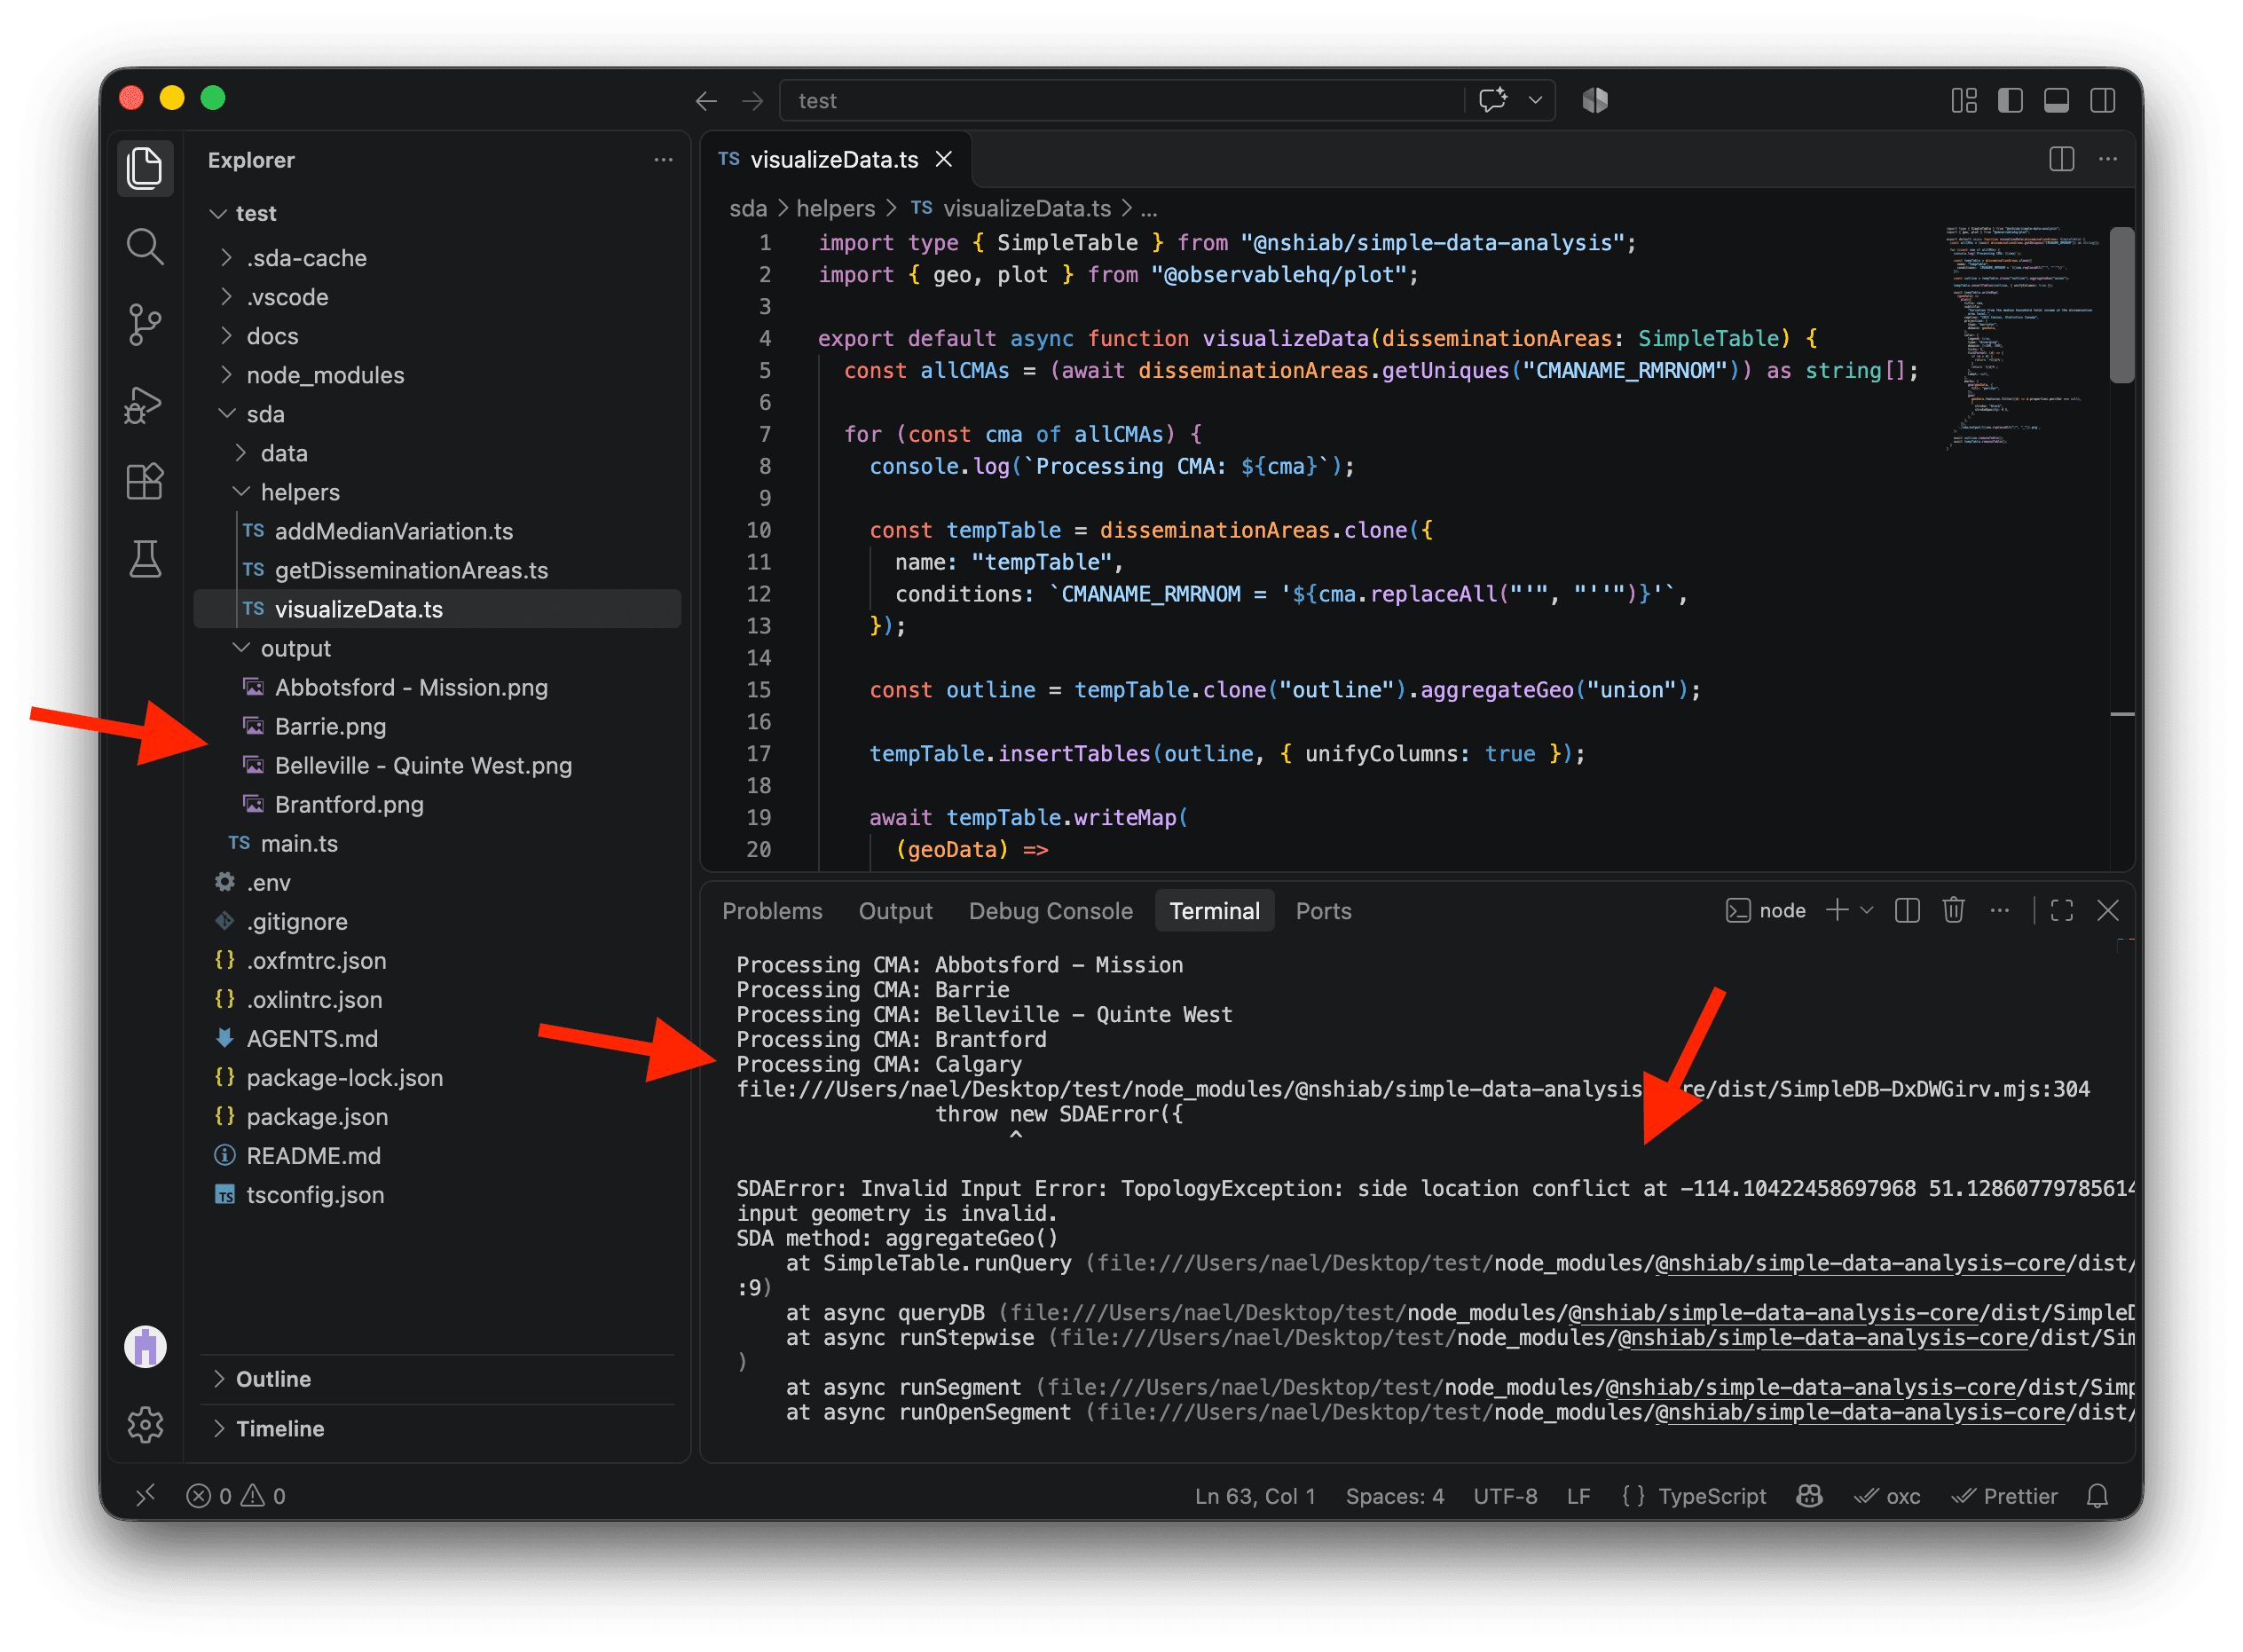
Heureusement, SDA permet de corriger facilement les géométries invalides avec fixGeo(). Nous chargeons les frontières des aires de diffusion dans getDisseminationAreas. Il suffit donc d’enchaîner cette méthode après loadGeoData() à l’intérieur de cache(). SDA réparera les géométries pendant leur chargement et conservera le résultat corrigé en cache pour les prochains lancements.
import { SimpleDB } from "@nshiab/simple-data-analysis";

export default async function getDisseminationAreas(sdb: SimpleDB) {
  const census = sdb.newTable("census");
  await census.cache(() => {
    census.loadData(
      "sda/data/98-401-X2021006_eng_CSV/98-401-X2021006_English_CSV_data_*.csv",
      {
        encoding: "cp1252",
        columns: ["GEO_LEVEL", "CHARACTERISTIC_ID", "DGUID", "C1_COUNT_TOTAL"],
        conditions: `GEO_LEVEL = 'Dissemination area'`,
      },
    );
  });
  census.keepValues({ CHARACTERISTIC_ID: 243 });

  const names = sdb.newTable("names");
  await names.cache(() => {
    names.loadData("sda/data/2021_92-151_X.csv", {
      encoding: "cp1252",
      columns: ["DADGUID_ADIDUGD", "CMANAME_RMRNOM"],
      conditions: `CMATYPE_RMRGENRE = 'B'`,
    })
      .removeDuplicates()
      .renameColumns({
        DADGUID_ADIDUGD: "DGUID",
      });
  });
  census.join(names);

  const disseminationAreas = sdb.newTable("disseminationAreas");
  await disseminationAreas.cache(() => {
    disseminationAreas
      .loadGeoData("sda/data/lda_000b21a_e.shp.zip", {
        toEPSG4326: true,
        columns: ["DGUID", "geom"],
      })
      .fixGeo();
  });
  await disseminationAreas
    .join(census)
    .removeMissing()
    .log();

  return disseminationAreas;
}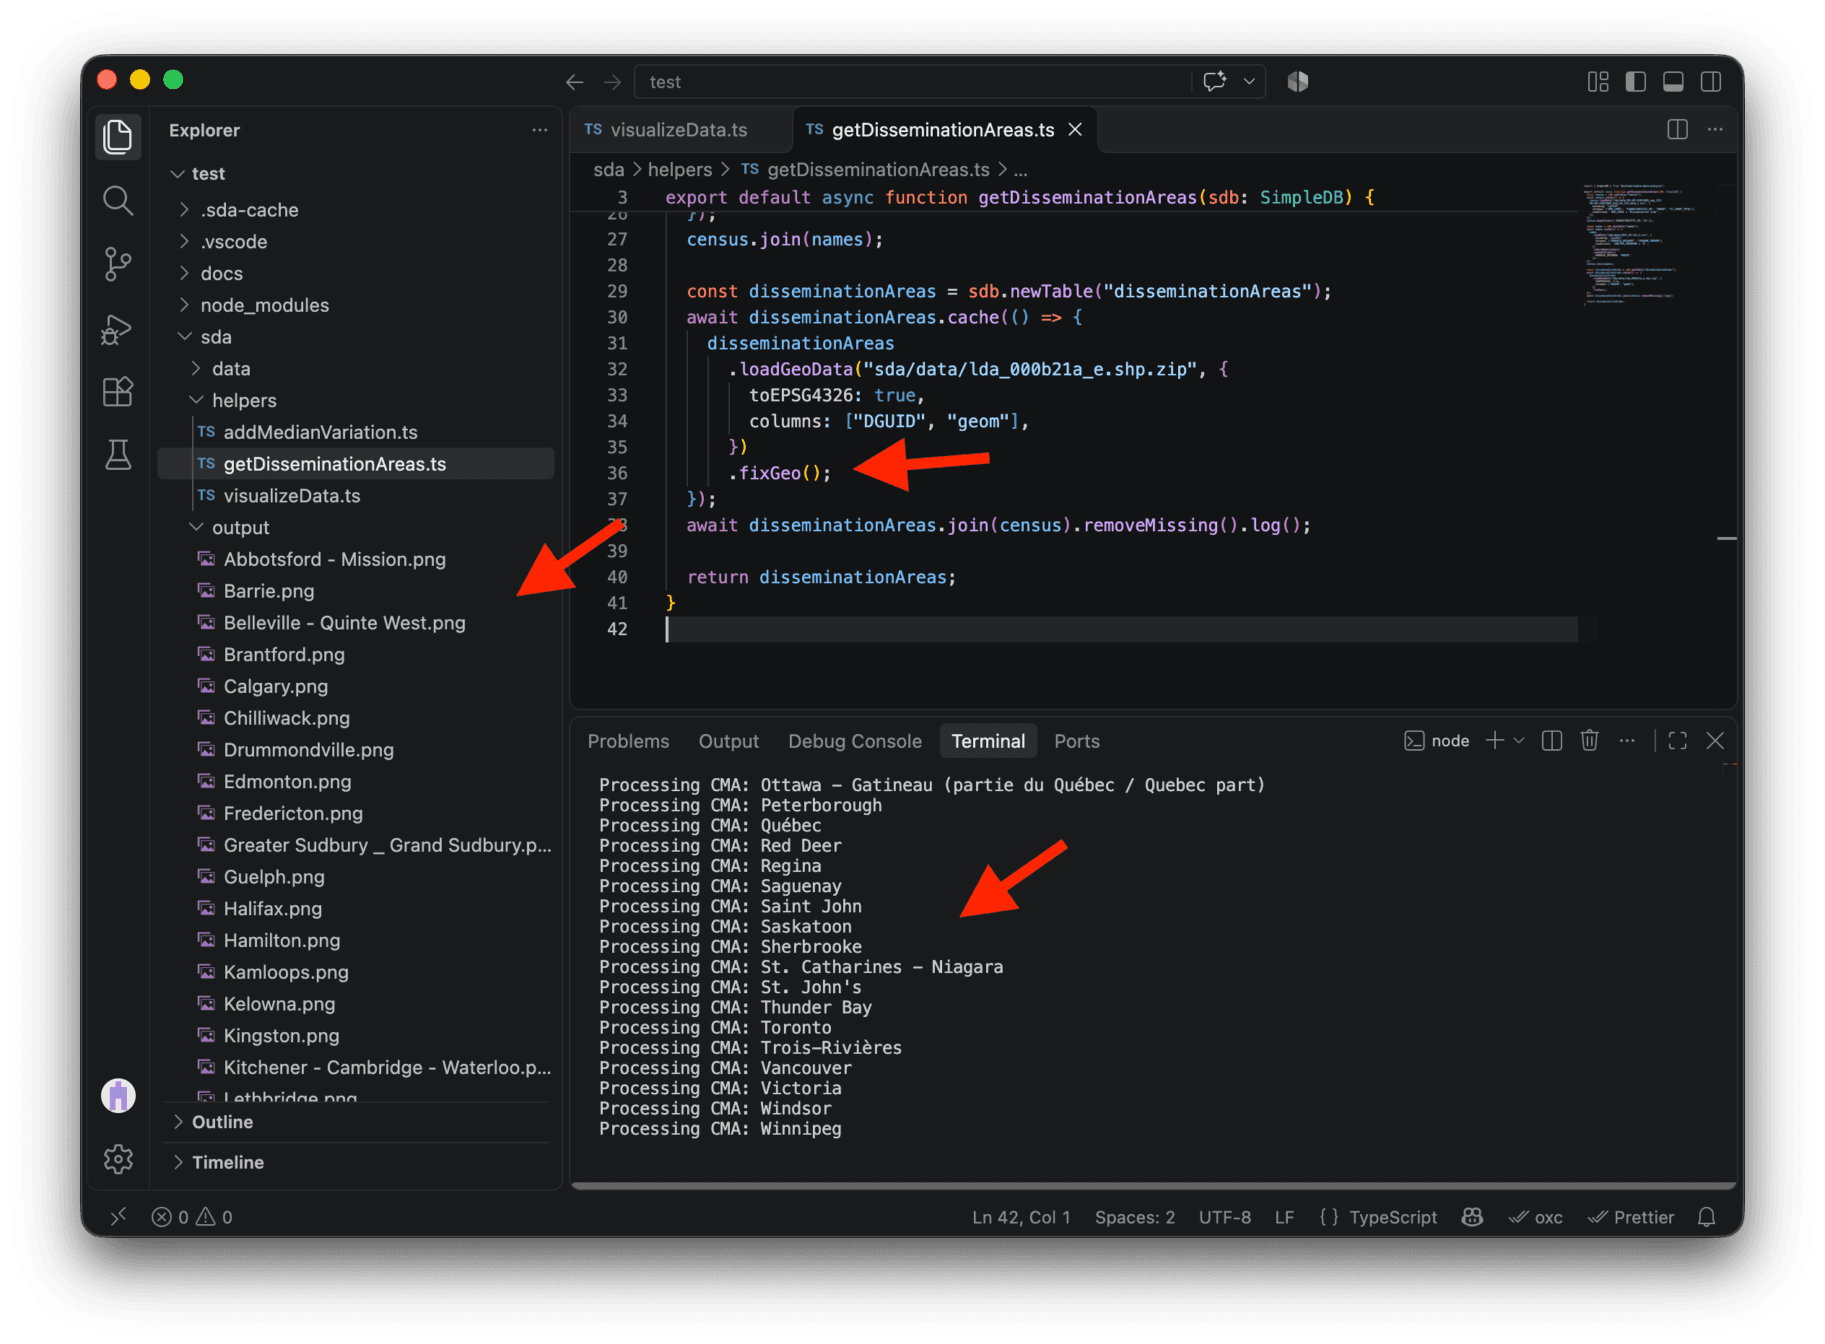
Une fois la modification enregistrée, le script crée les 42 cartes ! 🥳 Sur mon ordinateur, cette exécution avec le cache n’a pris que sept secondes. C’est impressionnant pour autant de cartes.
Ces cartes sont des images PNG. Si vous préférez des fichiers vectoriels modifiables, remplacez .png par .svg dans le chemin de sortie de writeMap. Vous pourrez ensuite ouvrir les fichiers SVG et les retoucher dans un logiciel comme Illustrator.
Ouvrez quelques images dans sda/output pour voir le résultat. Montréal est ma ville et je trouve fascinants les motifs du revenu des ménages qu’on y voit. Voici sa carte en pleine résolution :
Conclusion
Quel parcours ! Traiter de grands ensembles de données répartis entre plusieurs tables tabulaires et géospatiales n’est pas une mince affaire.
Mais j’espère que cet exemple concret vous a montré comment SDA permet de venir à bout de plusieurs gigaoctets de données comme si c’était du beurre. 🧈
Pour poursuivre le cours, passez à Git et GitHub. Vous y apprendrez à suivre les modifications de votre code et à collaborer sur des projets.
Amusez-vous avec votre prochain projet de données et n’hésitez pas à m’écrire pour partager ce que vous créez avec SDA ou poser vos questions ! 😊