Le défi du milliard de lignes 😱
Dernière mise à jour le
Bienvenue dans ce nouveau projet où nous allons exploiter un fichier CSV contenant un milliard de lignes. Oui, UN MILLIARD !
Il s’agit d’un défi très amusant créé par Gunnar Morling .
Votre mission, si vous l’acceptez, est en apparence simple : écrire un programme en Java pour récupérer les valeurs de température à partir d’un fichier texte et calculer les températures minimale, moyenne et maximale par station météo. Il y a juste un petit détail : le fichier contient 1 000 000 000 de lignes !
Au lieu d’utiliser un programme en Java, nous allons bien sûr utiliser TypeScript, avec la librairie Simple Data Analysis (SDA) que j’ai créée (donnez-lui un ⭐ ). C’est une excellente occasion de tester sa puissance !
Si vous êtes bloqué à un moment donné dans ce projet, il peut être utile de revoir les leçons précédentes du chapitre 3, particulièrement Installation et Données tabulaires, qui expliquent les bases de SDA.
C’est parti !
Installation
Créez un nouveau dossier vide à un endroit pratique sur votre ordinateur et ouvrez-le dans VS Code. Ouvrez ensuite le terminal dans VS Code.
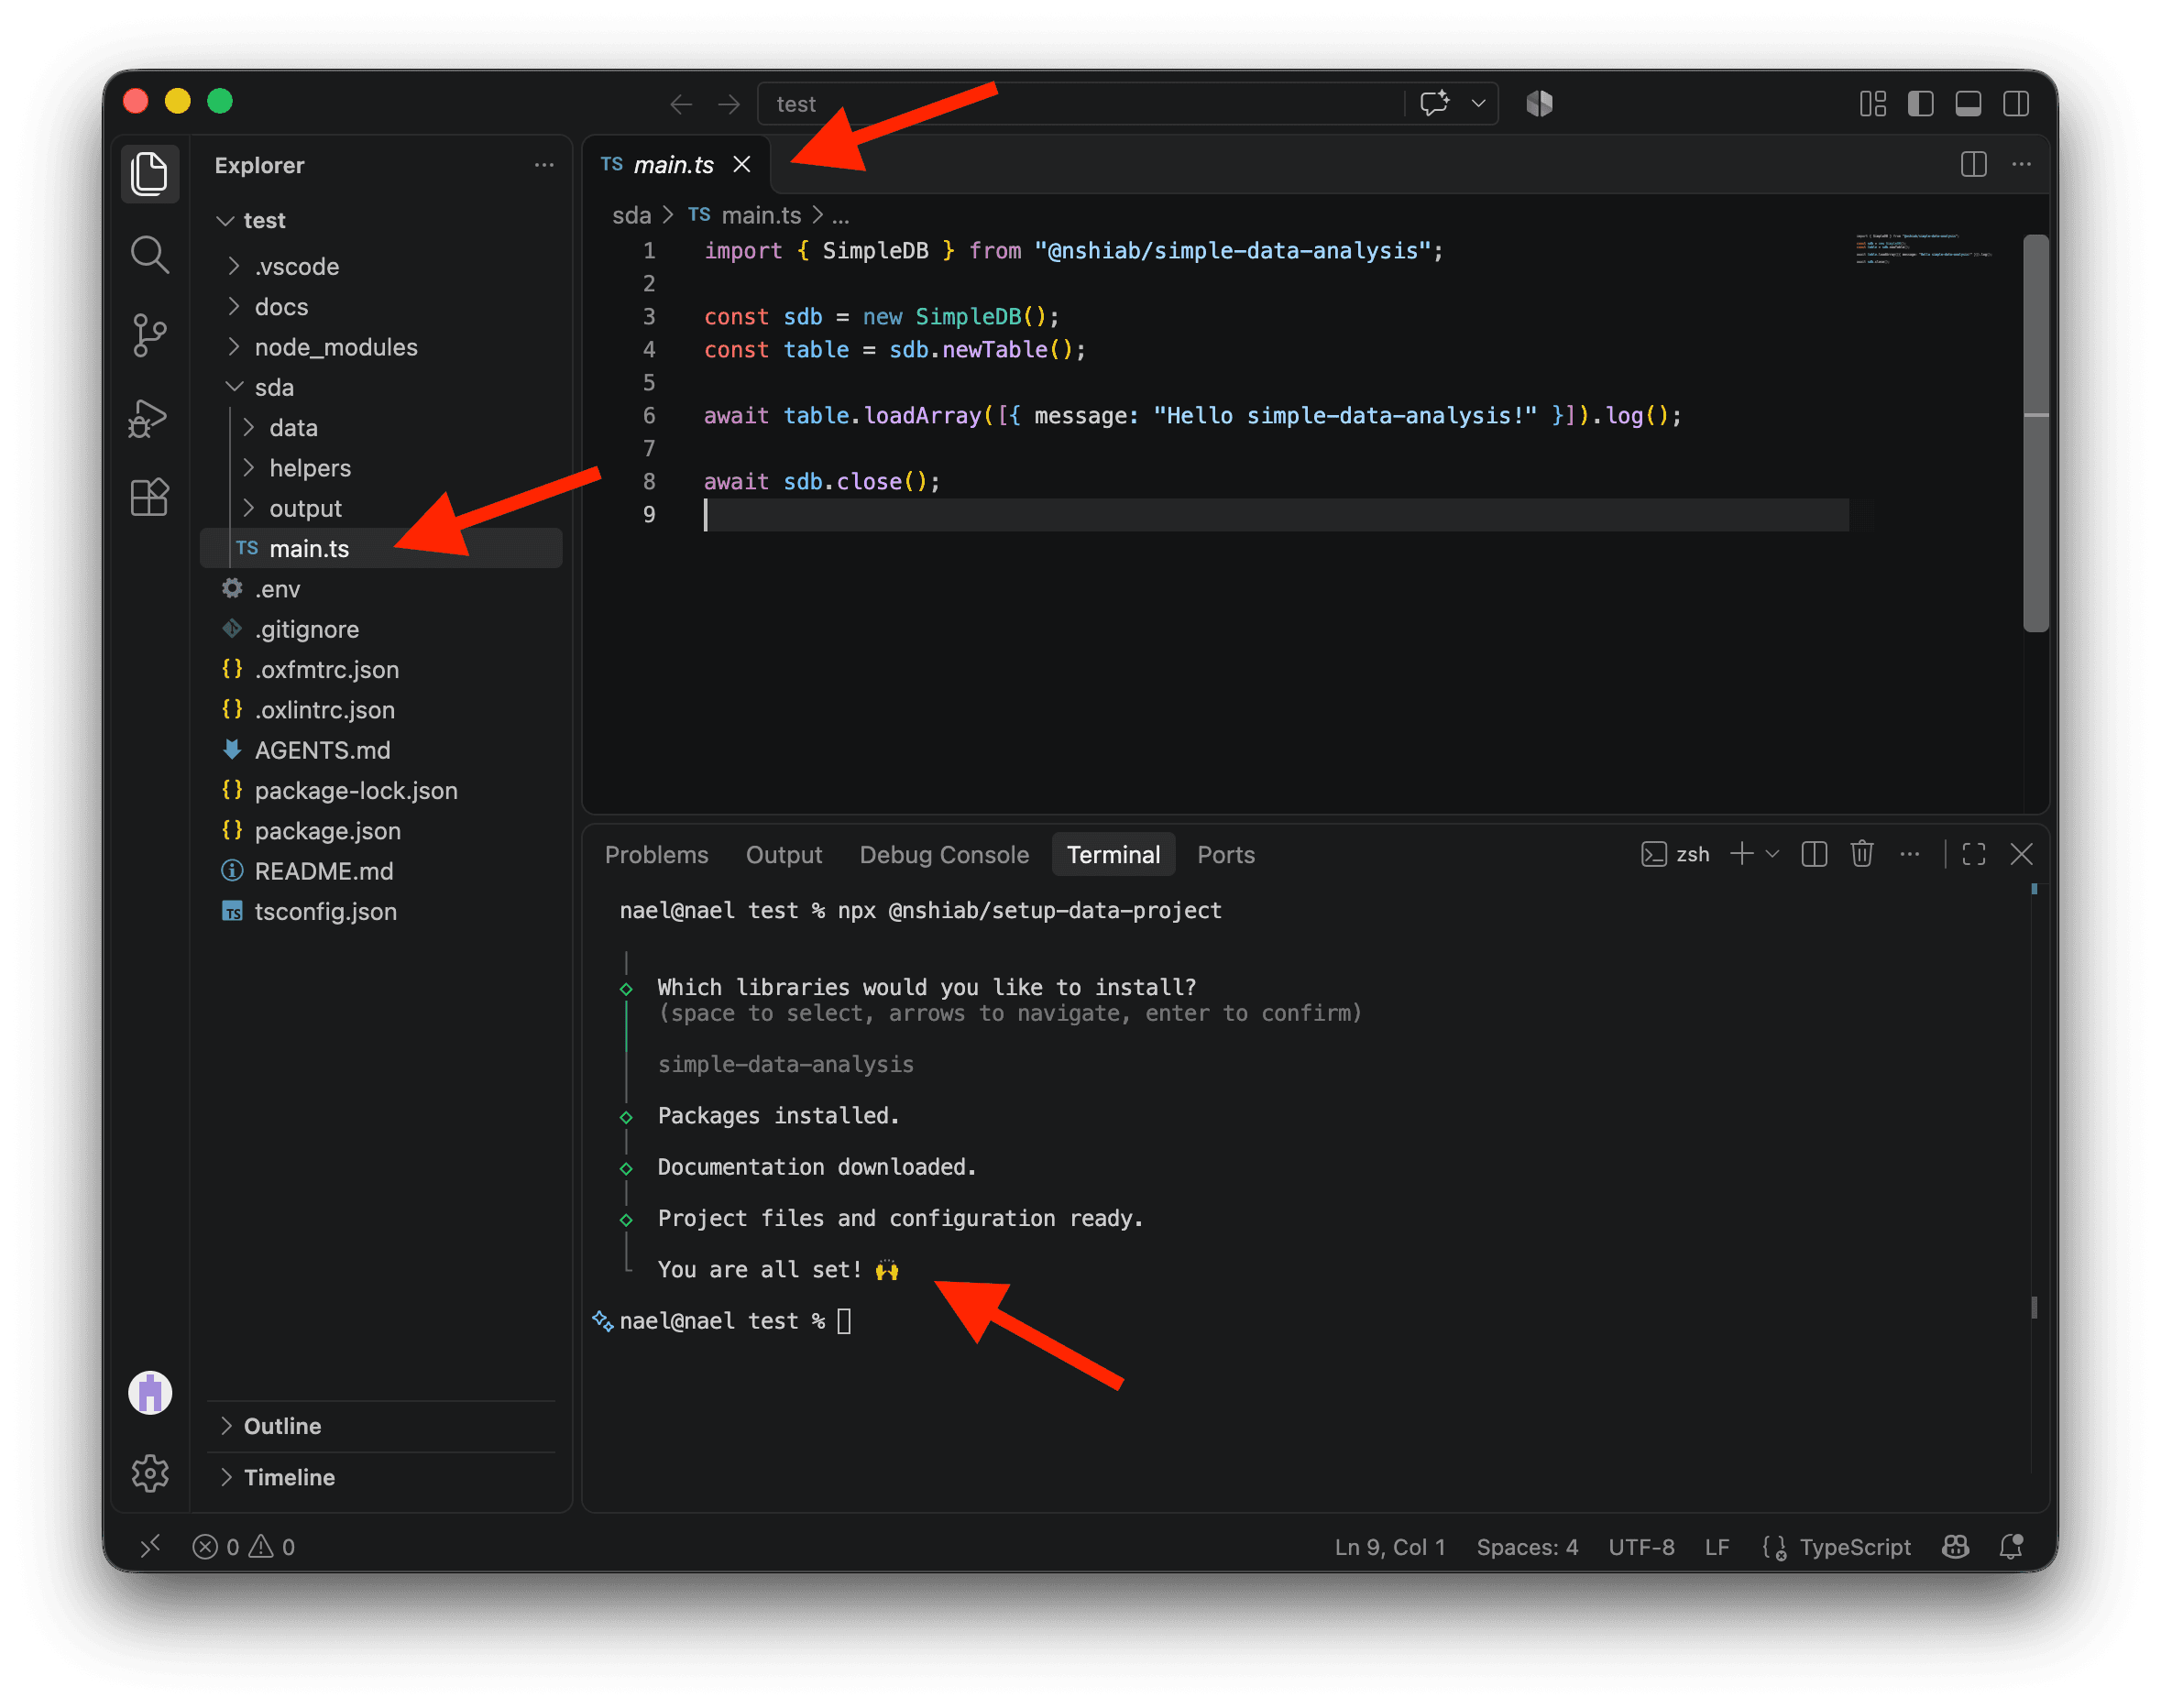
Nous utiliserons @nshiab/setup-data-project, une librairie que j’ai créée pour installer les librairies et préparer tous les fichiers et réglages nécessaires à un projet. Exécutez cette commande dans le terminal :
npx @nshiab/setup-data-project --sdaSi on vous demande de confirmer l’installation de la librairie, tapez y et appuyez sur Entrée.
L’option --sda sélectionne automatiquement la librairie simple-data-analysis à installer.
Une fois que le terminal affiche You are all set!, ouvrez sda/main.ts. Vous y trouverez du code de départ.
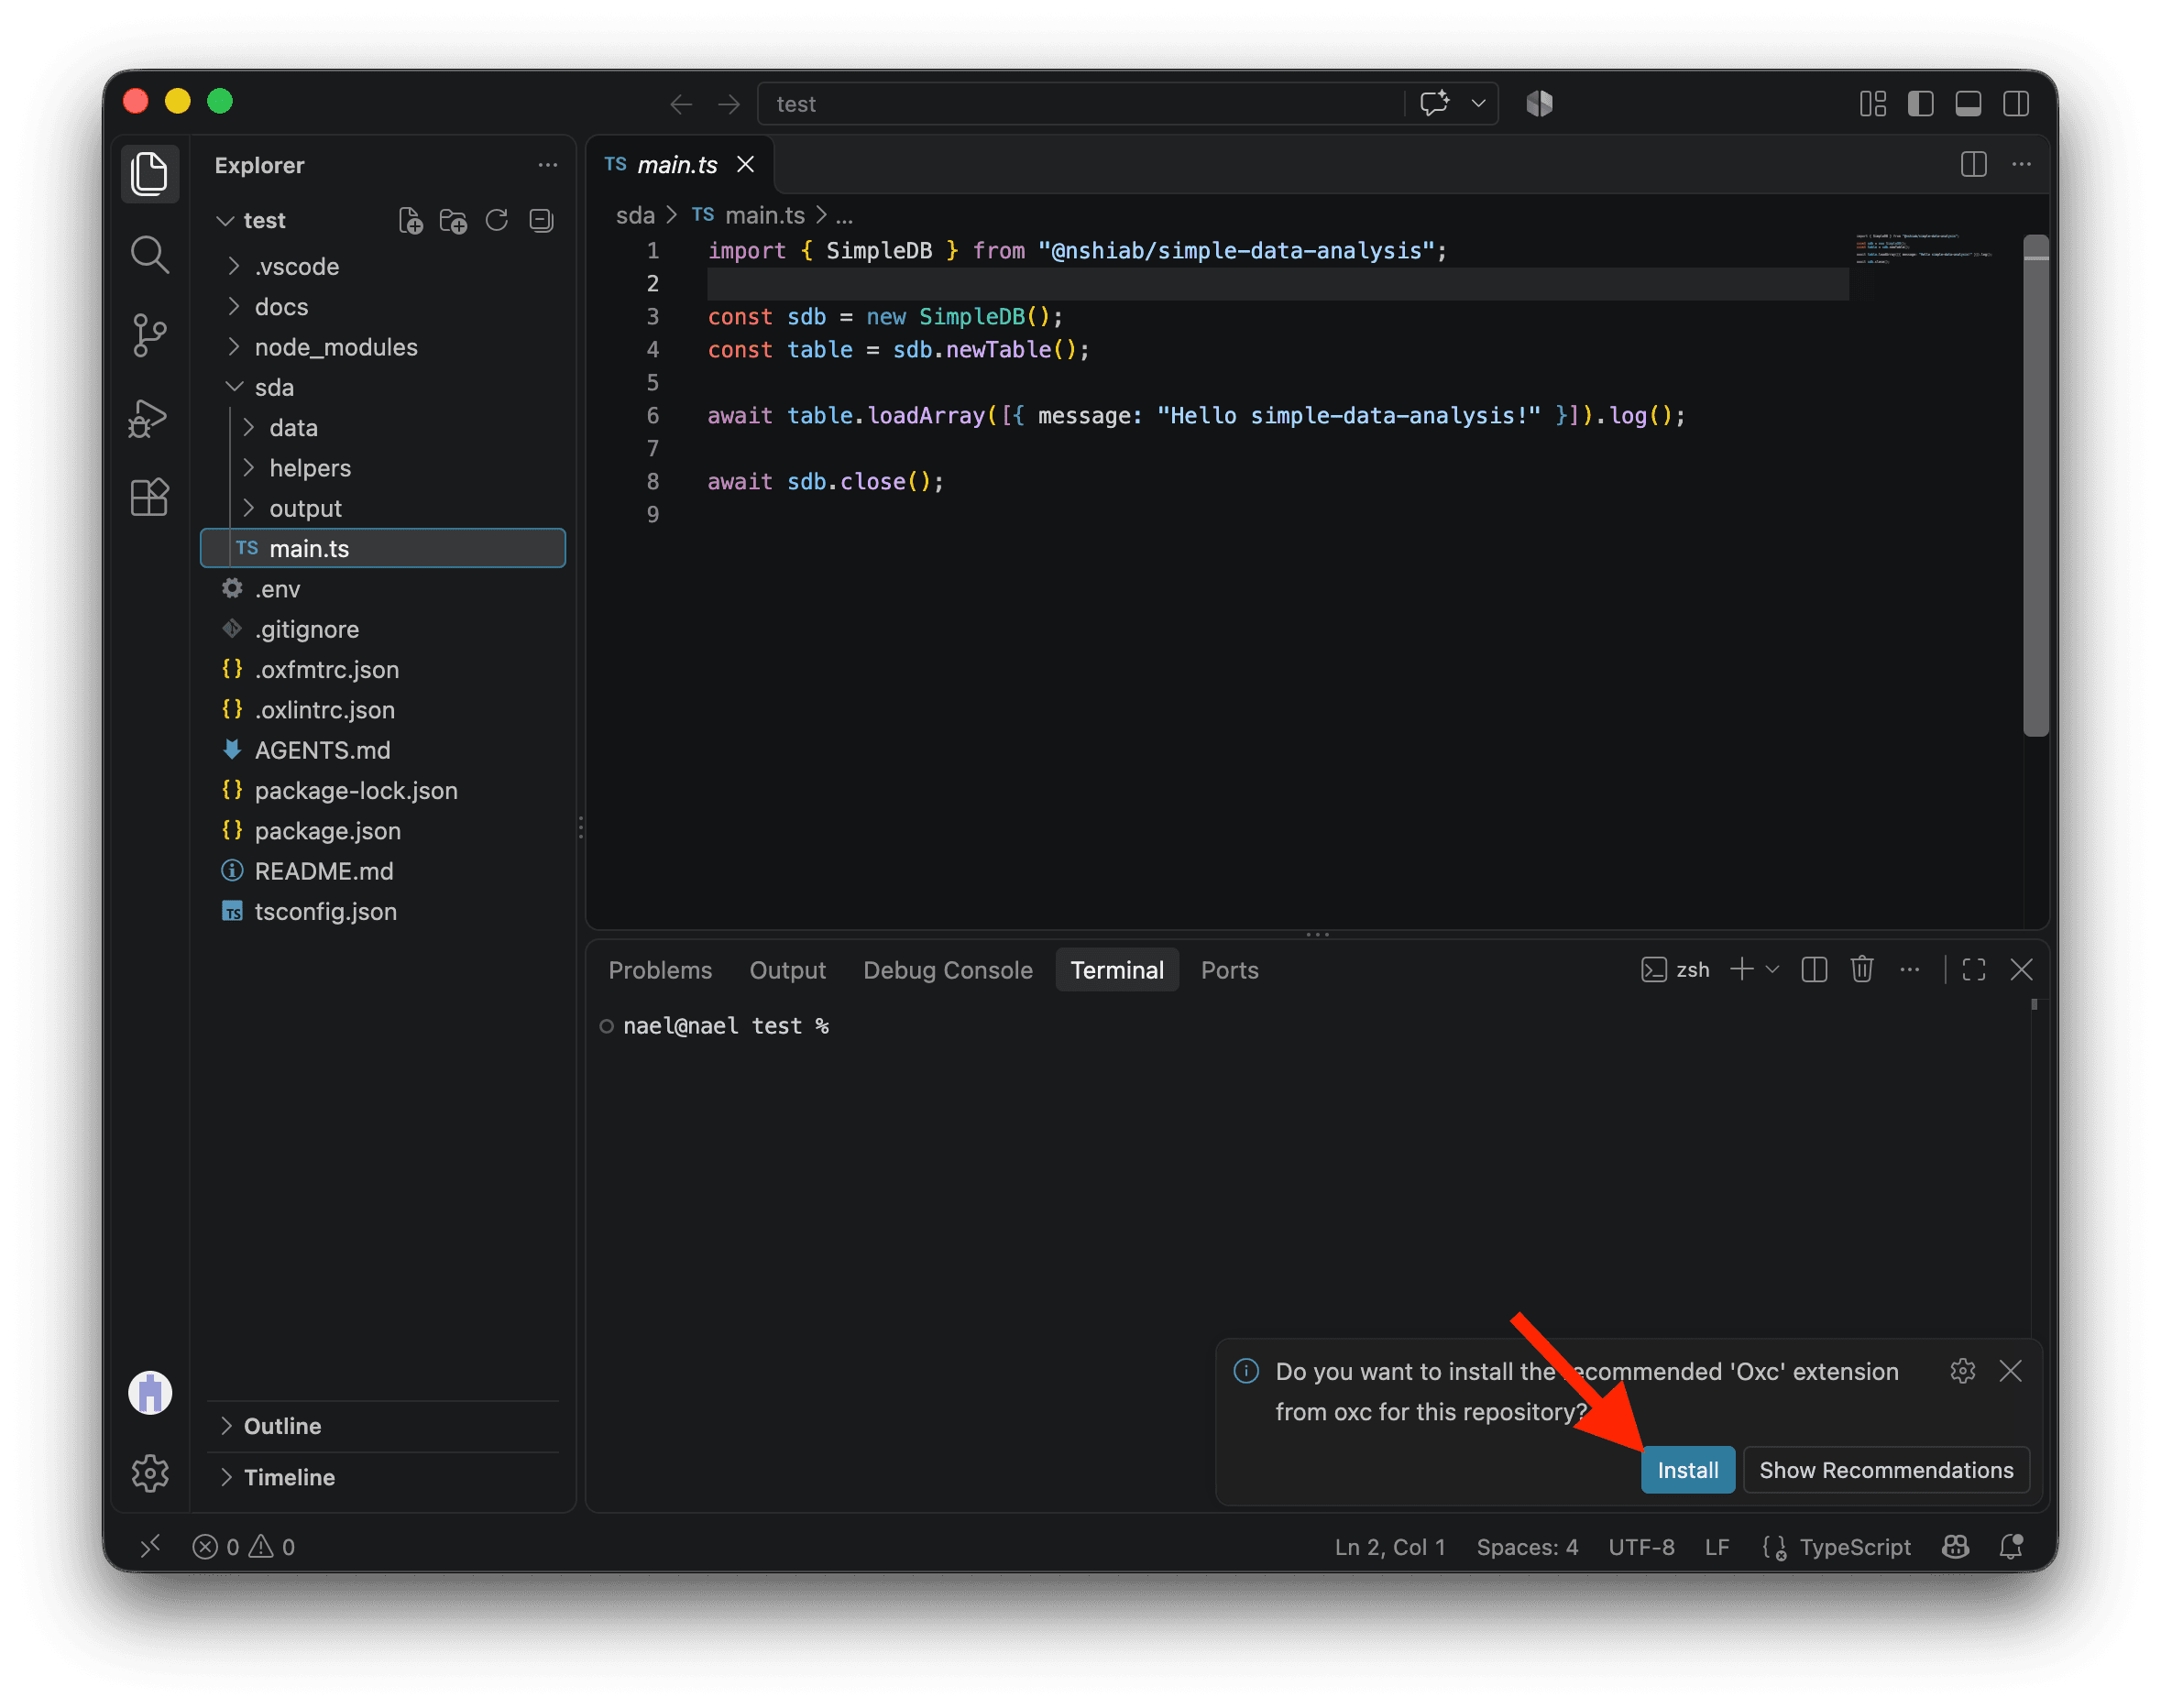
Si VS Code vous propose d’installer l’extension recommandée Oxc, cliquez sur Install. Elle aide à formater votre code et à repérer des problèmes potentiels pendant que vous travaillez.
Nous sommes maintenant prêts à surveiller sda/main.ts. Exécutez la commande ci-dessous. Chaque fois que vous enregistrez le fichier, votre code sera automatiquement formaté, vérifié et exécuté :
npm run sda:watchSi vous devez arrêter la surveillance, cliquez dans le terminal et appuyez sur Ctrl+C sur Mac ou Windows.
Gardez la surveillance active pendant ce projet.
Les données
Dans le défi original, vous devez copier un répertoire GitHub et exécuter un script pour générer un fichier CSV contenant 1 milliard de lignes. Je l’ai généré pour vous et j’ai téléversé une copie appartenant au cours sur Google Drive.
Téléchargez les données ici . Cela peut prendre quelques minutes car le fichier fait environ 4 Go.
Ensuite, placez-le dans votre dossier sda/data et décompressez-le. La version décompressée du fichier CSV fait environ 13 Go.
Pour charger les données, ajoutez ce code dans sda/main.ts. Selon votre ordinateur, cela peut prendre de quelques secondes à quelques minutes.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ logDuration: true });

await sdb
  .newTable()
  .loadData("sda/data/measurements.csv")
  .log();

await sdb.close();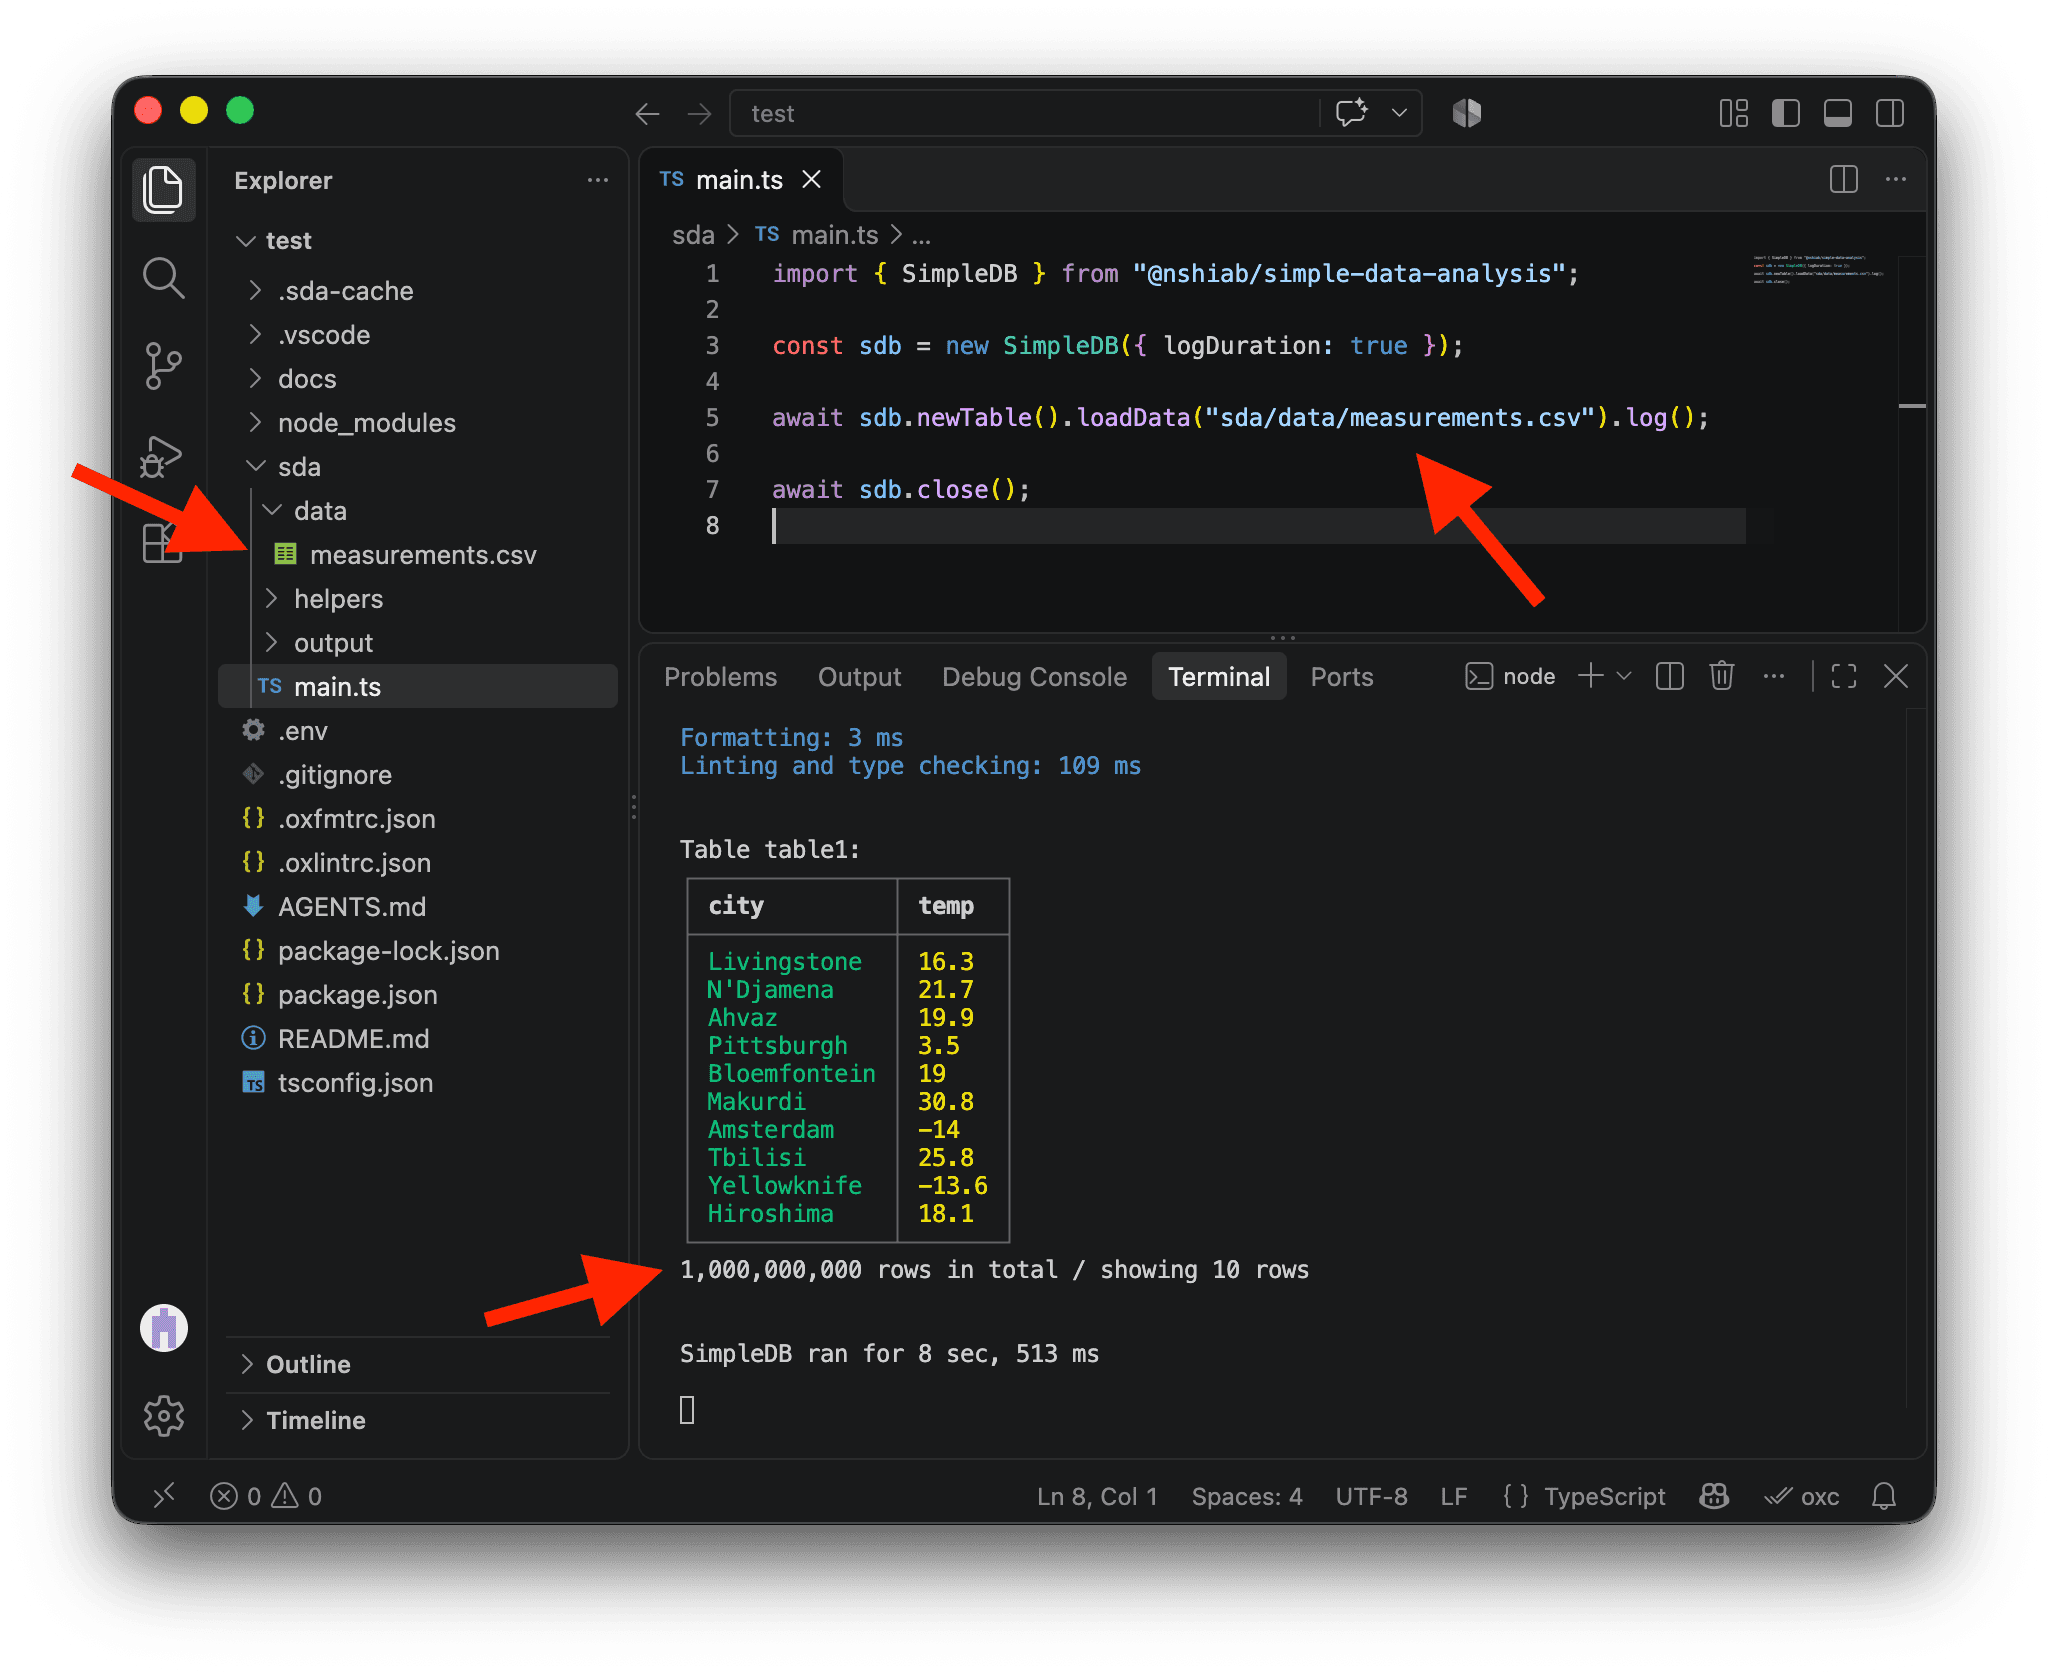
Félicitations ! Vous venez de charger 1 000 000 000 de lignes de données ! Comme vous pouvez le voir, cela prend environ huit secondes sur mon M4 Max, ce qui est très impressionnant pour un fichier CSV de cette taille. 🥳
Selon la RAM disponible sur votre ordinateur, vous pourriez voir un dossier .tmp apparaître dans votre projet. Si les données sont plus volumineuses que votre RAM, ce dossier sera utilisé pour traiter toutes les données en stockant des morceaux prétraités.
Ce dossier .tmp peut devenir assez volumineux. Mais ne vous inquiétez pas : lorsque vous configurez un projet avec @nshiab/setup-data-project, il est automatiquement ajouté à .gitignore afin que vous ne le mettiez pas en ligne par erreur sur GitHub ou ailleurs.
Vous pouvez supprimer .tmp manuellement, même si je ne le fais généralement pas. La commande npm run clean le supprime aussi, mais attention : elle supprime également toutes les données mises en cache dans .sda-cache.
Le défi
Comme vous pouvez le voir ci-dessus, les données sont simplement une liste de villes avec des températures.
Maintenant, le défi est de calculer les températures minimale, moyenne et maximale par ville. Les résultats doivent également être triés par ordre alphabétique des villes.
Avec SDA, c’est très facile. Nous devons appeler une seule méthode, summarize, pour effectuer les calculs. Nous n’avons même pas besoin de trier les lignes manuellement, car summarize le fait par défaut.
import { SimpleDB } from "@nshiab/simple-data-analysis";

const sdb = new SimpleDB({ logDuration: true });

await sdb
  .newTable()
  .loadData("sda/data/measurements.csv")
  .summarize({
    columns: "temp",
    by: "city",
    stats: ["min", "mean", "max"],
  })
  .log();

await sdb.close();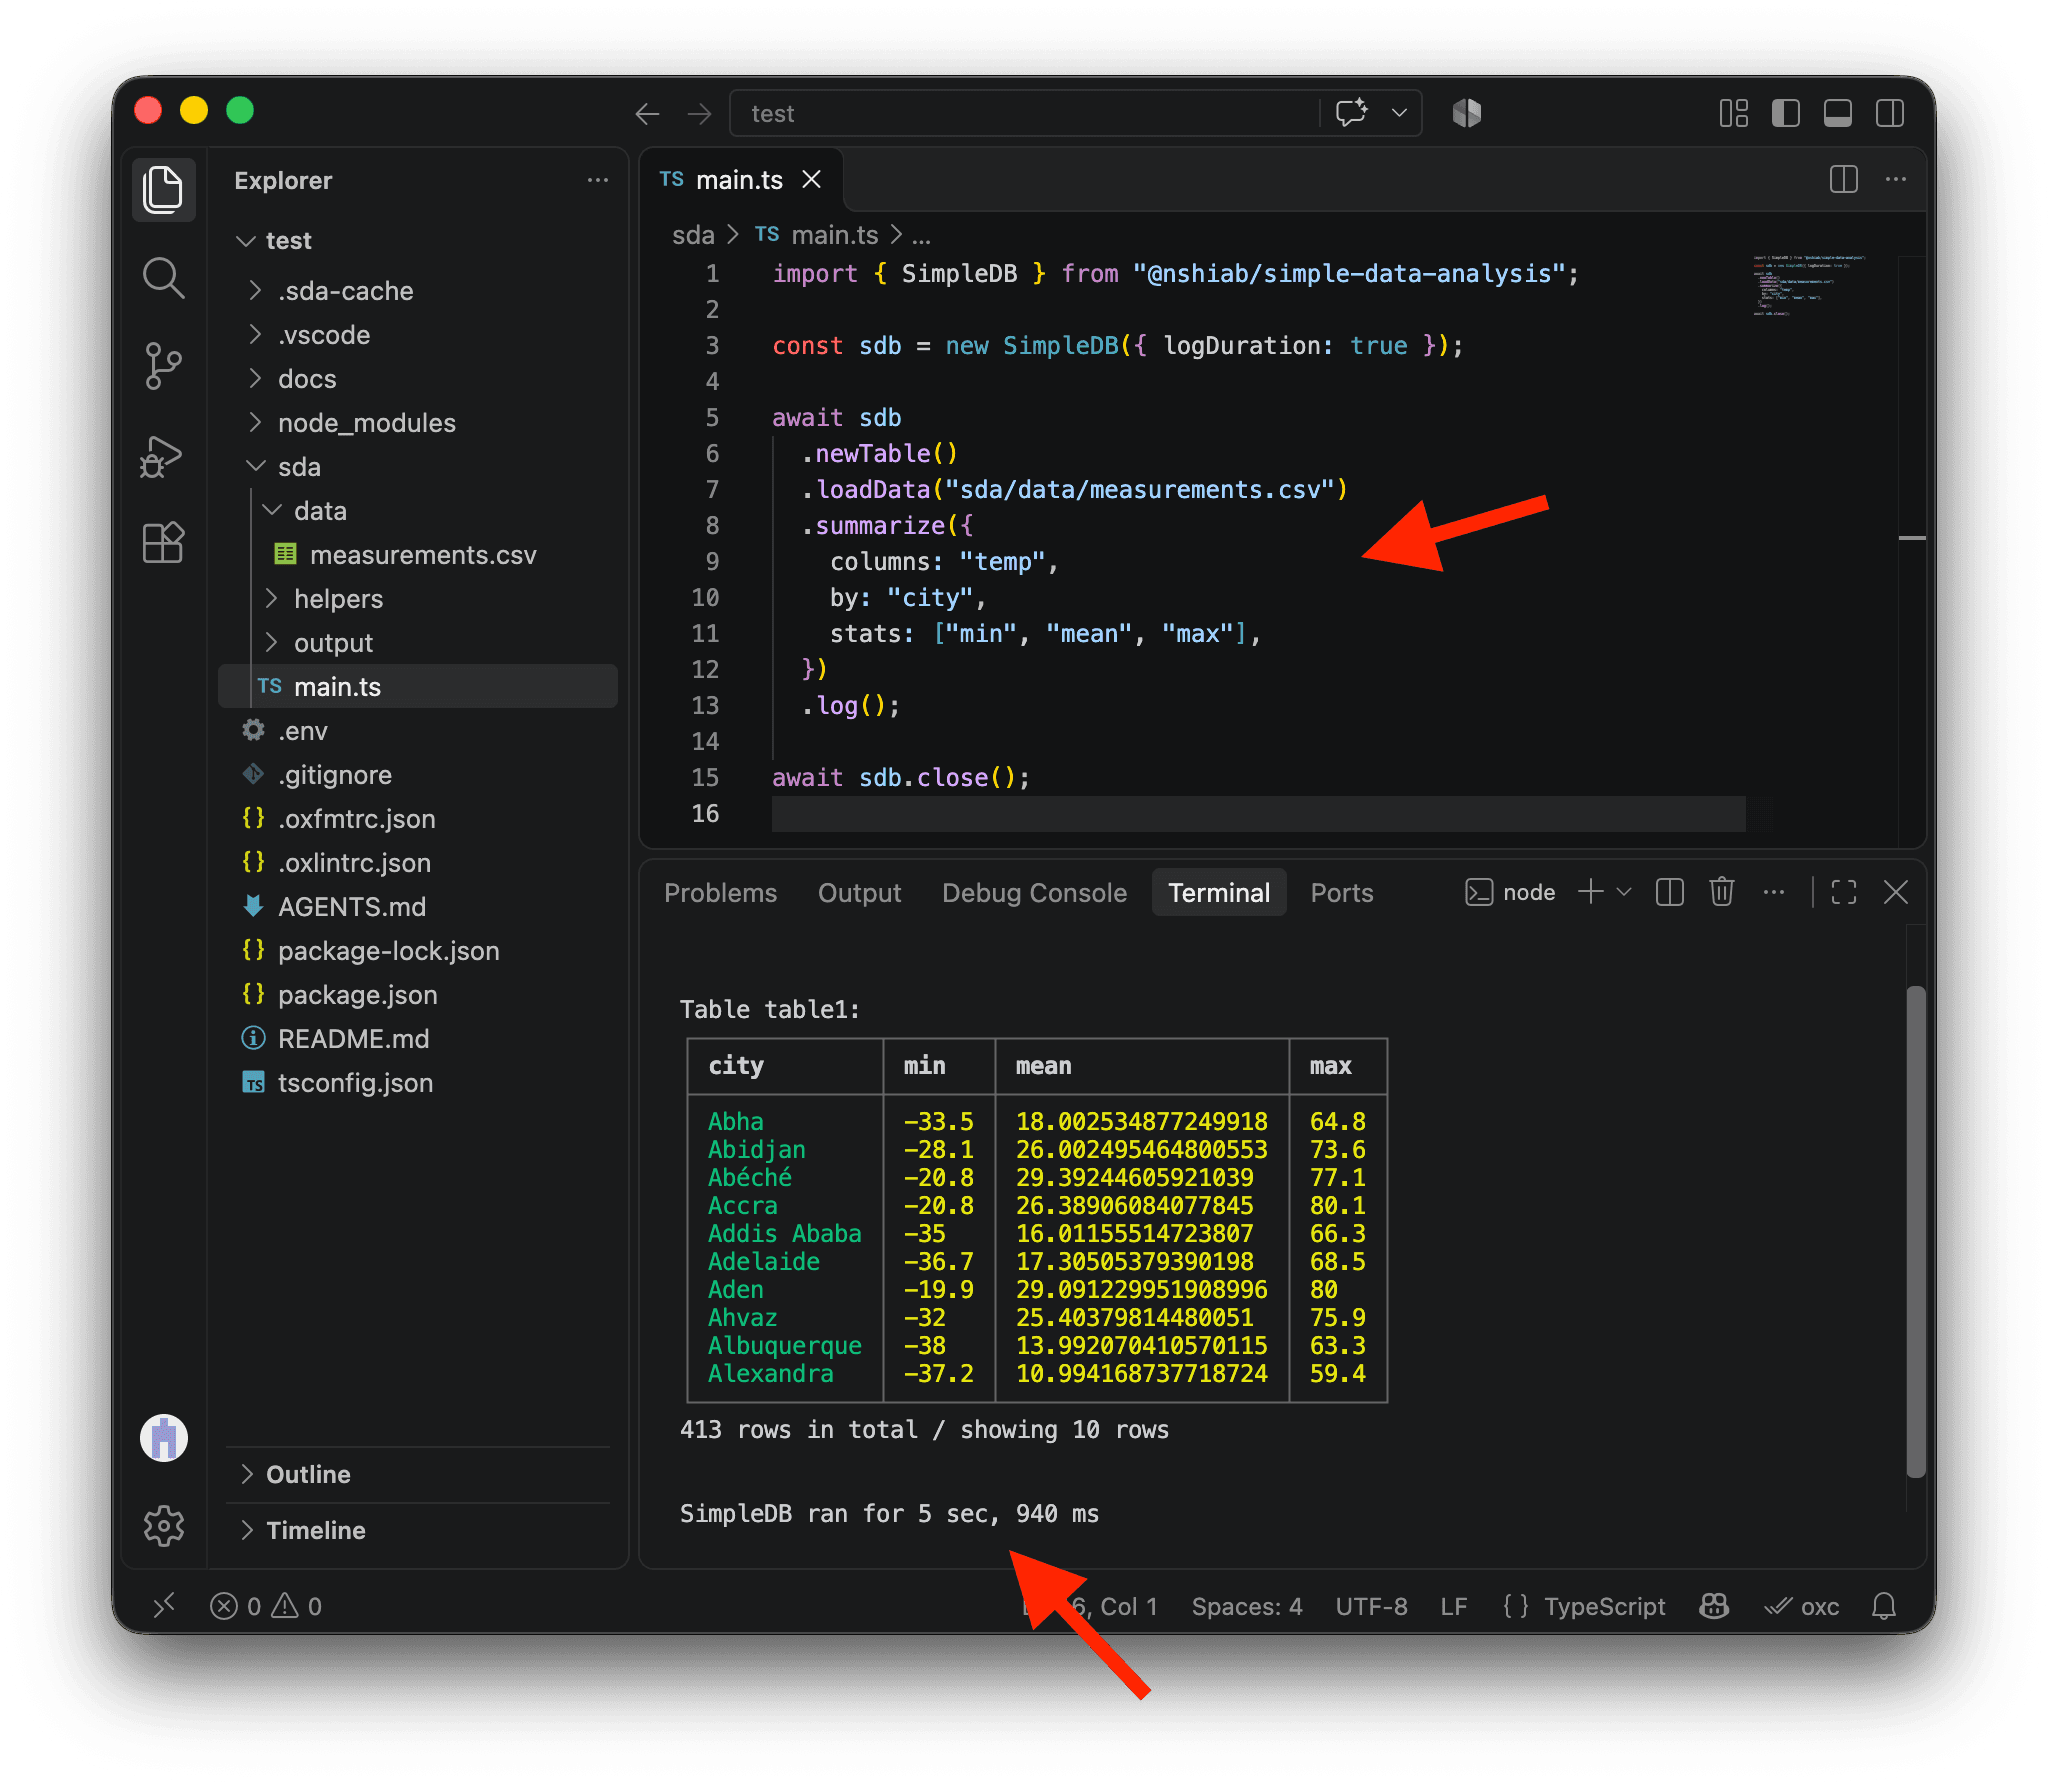
Sur mon ordinateur, ce code s’exécute encore plus rapidement que le simple chargement du fichier CSV, car la table finale est beaucoup plus petite que la table complète d’un milliard de lignes. Tout est traité à la volée, ce qui est assez incroyable. 🚀
Mais… comment ?
Bien que SDA soit une librairie TypeScript, elle utilise sous le capot DuckDB , un système de base de données très rapide écrit en C++. Lorsque vous utilisez des méthodes comme loadData ou summarize, SDA traduit tout en SQL et demande à DuckDB de l’exécuter.
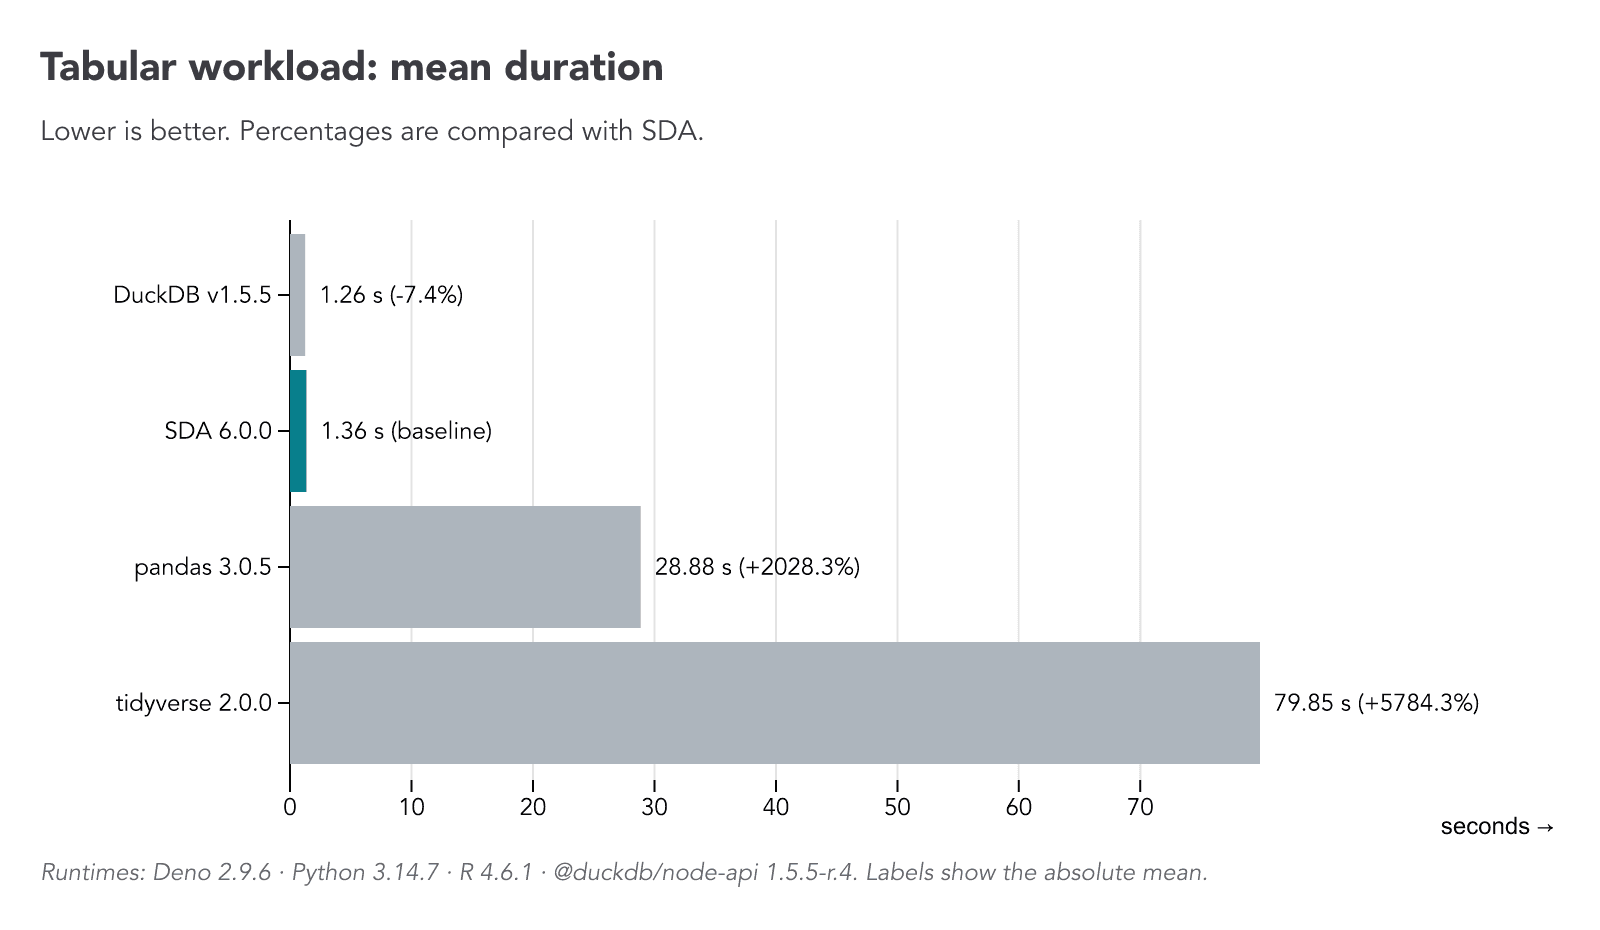
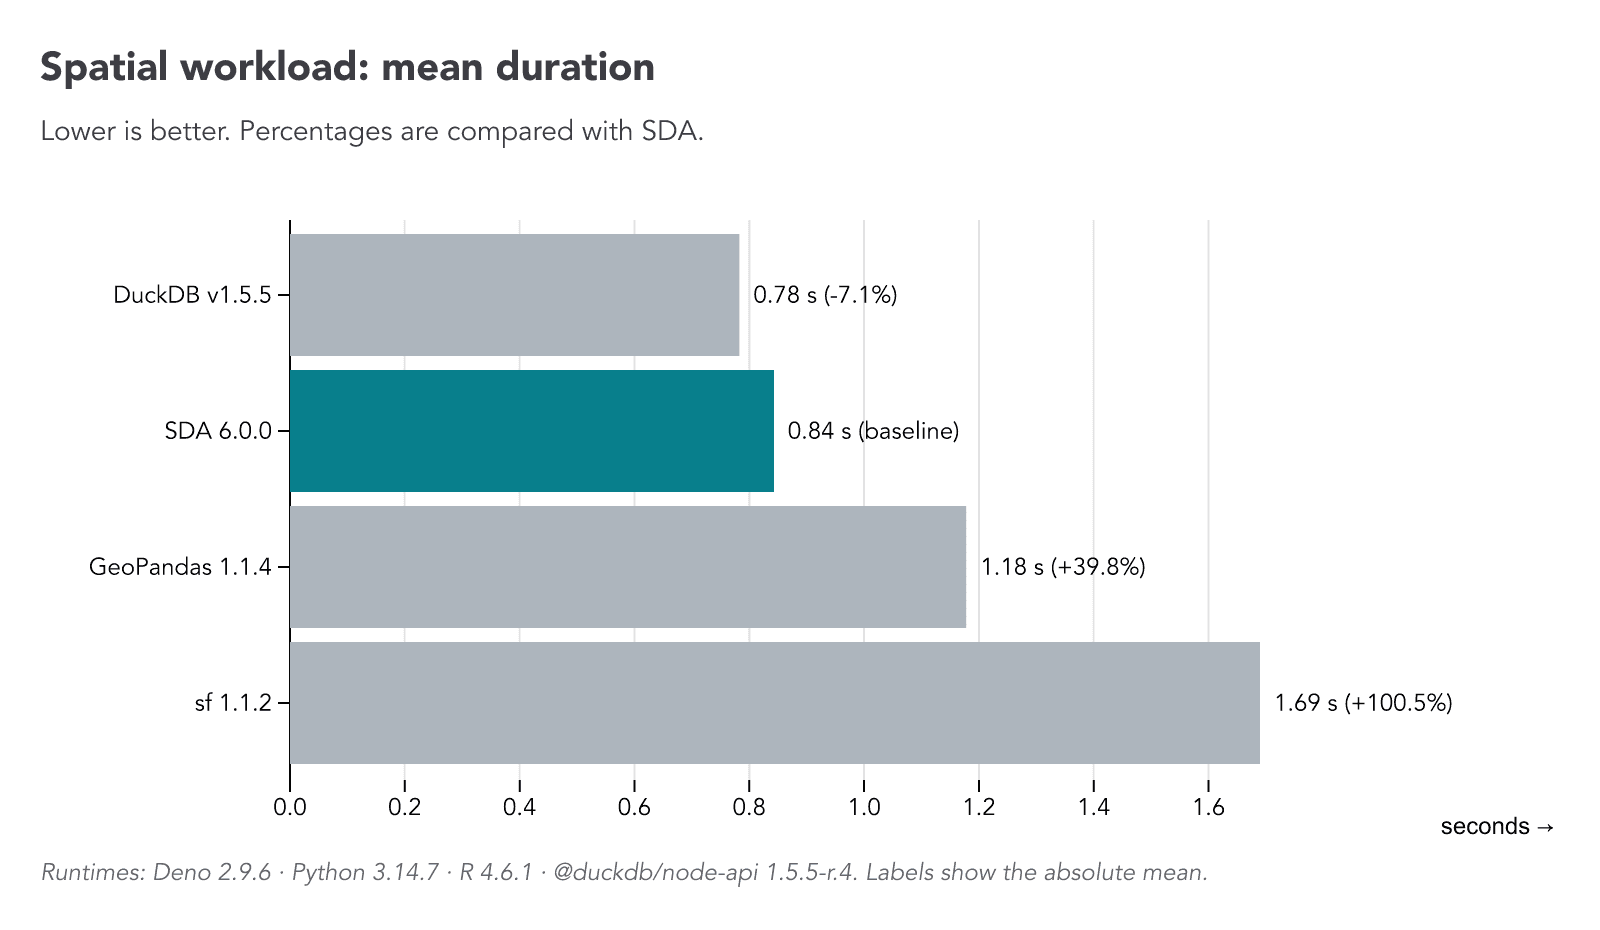
Pour comparer SDA à d’autres options populaires, dont DuckDB, j’ai effectué quelques tests sur mon MacBook Pro M4 Max, comme décrit ci-dessous.
Données tabulaires
Pour les données tabulaires, j’ai effectué un test avec les données climatiques canadiennes ajustées et homogénéisées , qui contiennent plus de 22 millions de lignes. Entre autres étapes, chaque option a calculé la température moyenne par station et par décennie. SDA a effectivement été extrêmement rapide par rapport aux autres options.
Données géospatiales
Pour les données géospatiales, j’ai utilisé le jeu de données regroupant tous les arbres publics de Montréal (335K). Le principal calcul consistait à compter le nombre d’arbres dans chacun des quartiers de la ville. Là encore, SDA a été une solution très rapide.
Les tests de mémoire racontent une histoire semblable. Vous pouvez consulter la méthodologie, le code et les résultats les plus récents dans le répertoire de Simple Data Analysis .
Conclusion
Voilà, c’est tout ! J’espère que ce projet vous a convaincu de la performance de la librairie Simple Data Analysis.
Plus rien ne vous empêche d’analyser des ensembles de données massifs avec TypeScript maintenant ! 💃🕺
Poursuivez avec Données tabulaires ou Visualiser des données au chapitre 3 pour découvrir d’autres façons d’utiliser SDA !